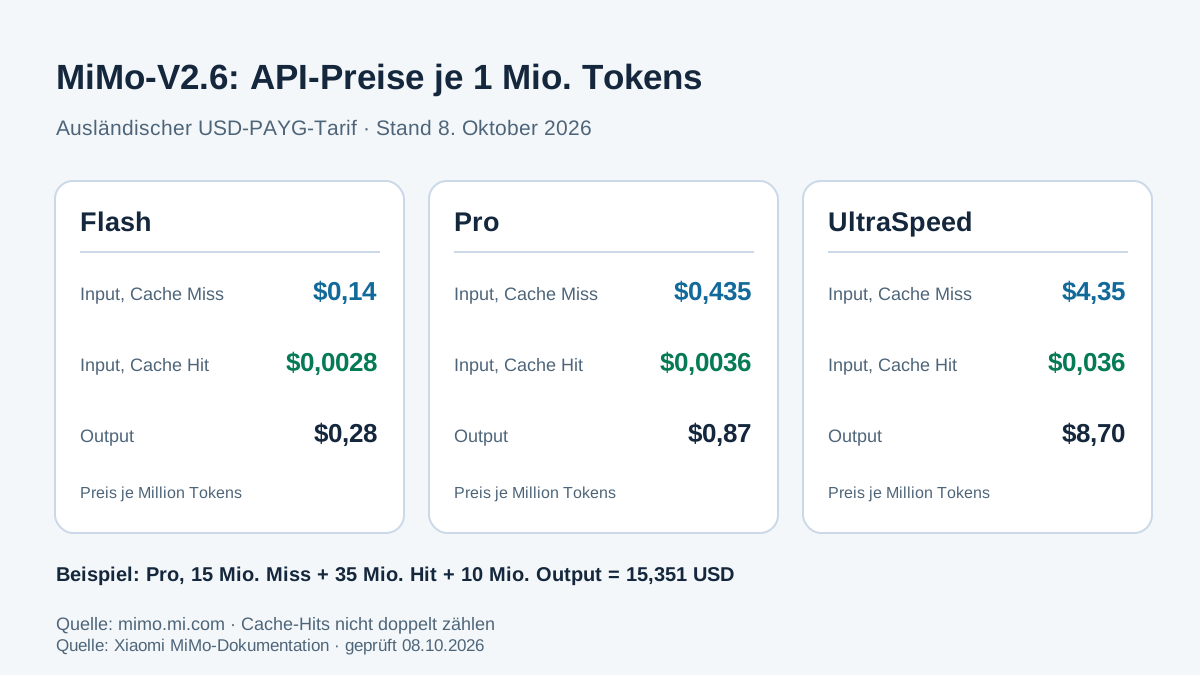
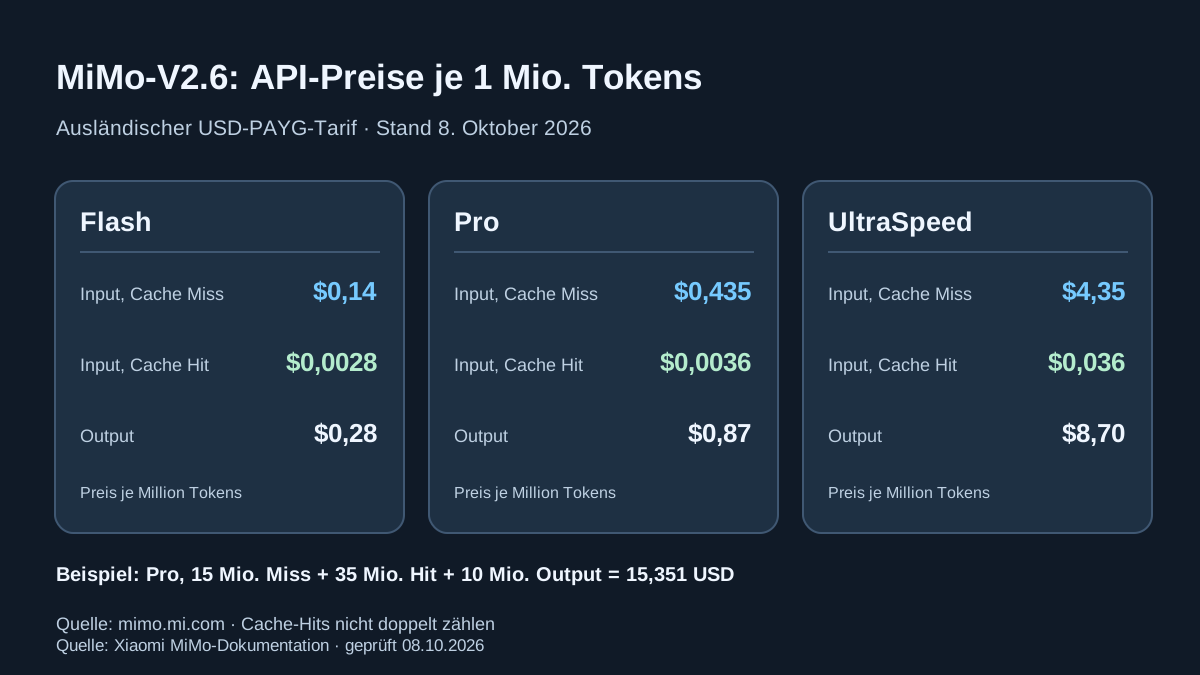
Aktualisiert: 8. Oktober 2026. Xiaomi hat die MiMo-V2.6-Familie veröffentlicht und die Gewichte von MiMo-V2.6-Pro und MiMo-V2.6-Flash geöffnet. Parallel gibt es MiMo-V2.6-Pro-UltraSpeed als gehosteten Hochgeschwindigkeitsmodus. MiMo-V2.6-Flash kostet 0,14 US-Dollar pro Million Input-Token und 0,28 US-Dollar pro Million Output-Token, MiMo-V2.6-Pro 0,435 US-Dollar beziehungsweise 0,87 US-Dollar, und UltraSpeed 4,35 US-Dollar beziehungsweise 8,70 US-Dollar — bei identischem 1M-Kontext und identischem 131.072-Token-Output-Limit. Alle drei API-Modellnamen werden kleingeschrieben: mimo-v2.6-flash, mimo-v2.6-pro und mimo-v2.6-pro-ultraspeed.
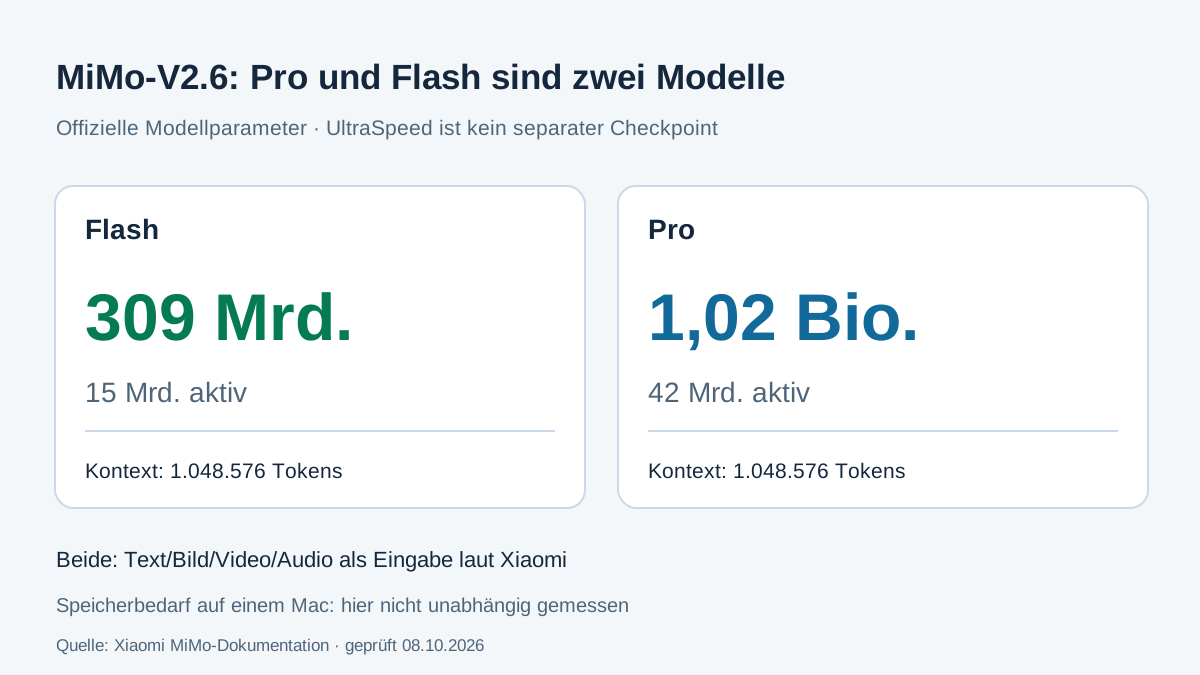
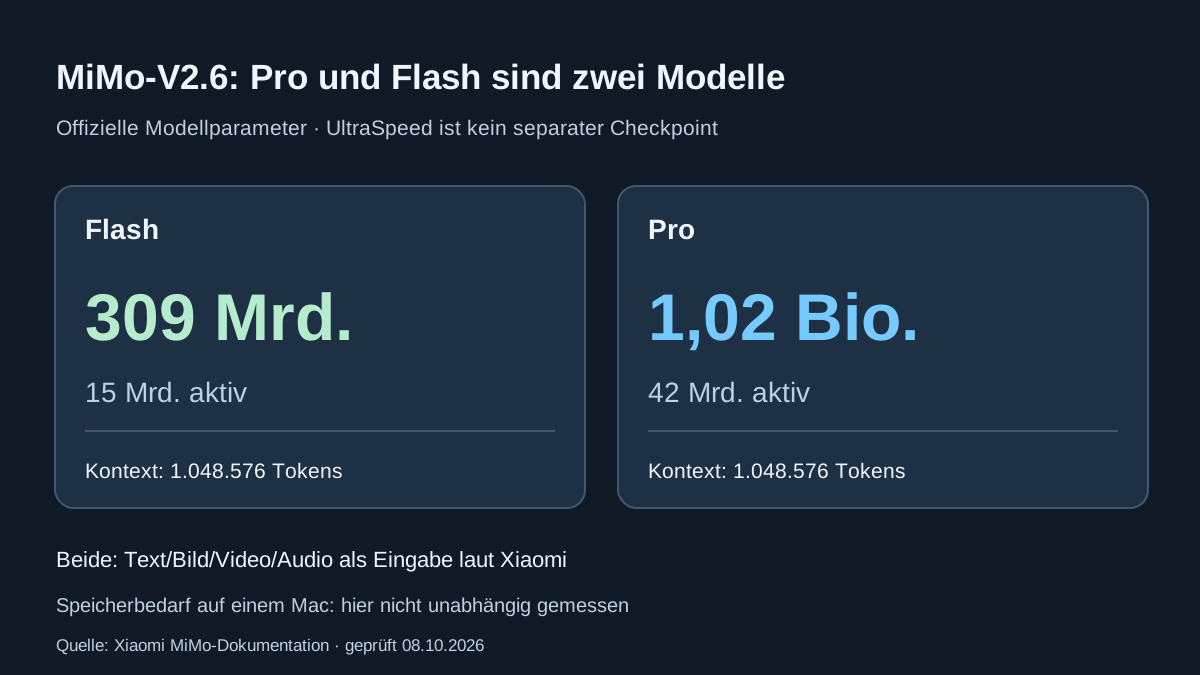
Evidenzgrundlage: Die große Vergleichstabelle weiter unten stammt aus Xiaomis eigener Model Card. Das ist nützlich, aber nicht dasselbe wie unabhängige Replikation. Für MiMo-V2.6-Pro liegt bereits eine unabhängige Messung von Artificial Analysis vor; für viele Einzelbenchmarks und für Flash/UltraSpeed noch nicht.
Die drei Varianten im direkten Vergleich
| Merkmal | MiMo-V2.6-Flash | MiMo-V2.6-Pro | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Rolle | Effizienzvariante | Flaggschiff | schnelle Pro-Inferenz |
| Architektur | Sparse MoE | Sparse MoE | Pro-Familie |
| Gesamtparameter | 309B | 1,02T | wie Pro |
| Aktiv pro Token | 15B | 42B | wie Pro |
| Kontext | 1.048.576 Token | 1.048.576 Token | 1.048.576 Token |
| Max. Output via Responses API | 131.072 Token | 131.072 Token | 131.072 Token |
| Input | Text, Bild, Video, Audio | Text, Bild, Video, Audio | Text, Bild, Video, Audio |
| API Input, Cache Miss | $0,14/M | $0,435/M | $4,35/M |
| API Input, Cache Hit | $0,0028/M | $0,0036/M | $0,036/M |
| API Output | $0,28/M | $0,87/M | $8,70/M |
| Batch API | $0,07/M in, $0,14/M out | $0,2175/M in, $0,435/M out | nicht angeboten |
| offene Gewichte | ja | ja | kein separater UltraSpeed-Checkpoint ausgewiesen |
Quellen: Xiaomi-Preisseite, Responses-API-Dokumentation und Model Cards. Der letzte Punkt ist eine redaktionelle Ableitung: Xiaomi nennt im Open-Source-Abschnitt Pro und Flash als Gewichte, UltraSpeed dagegen als Desktop/API-Modus.
Wie viel stärker ist Pro gegenüber Flash?
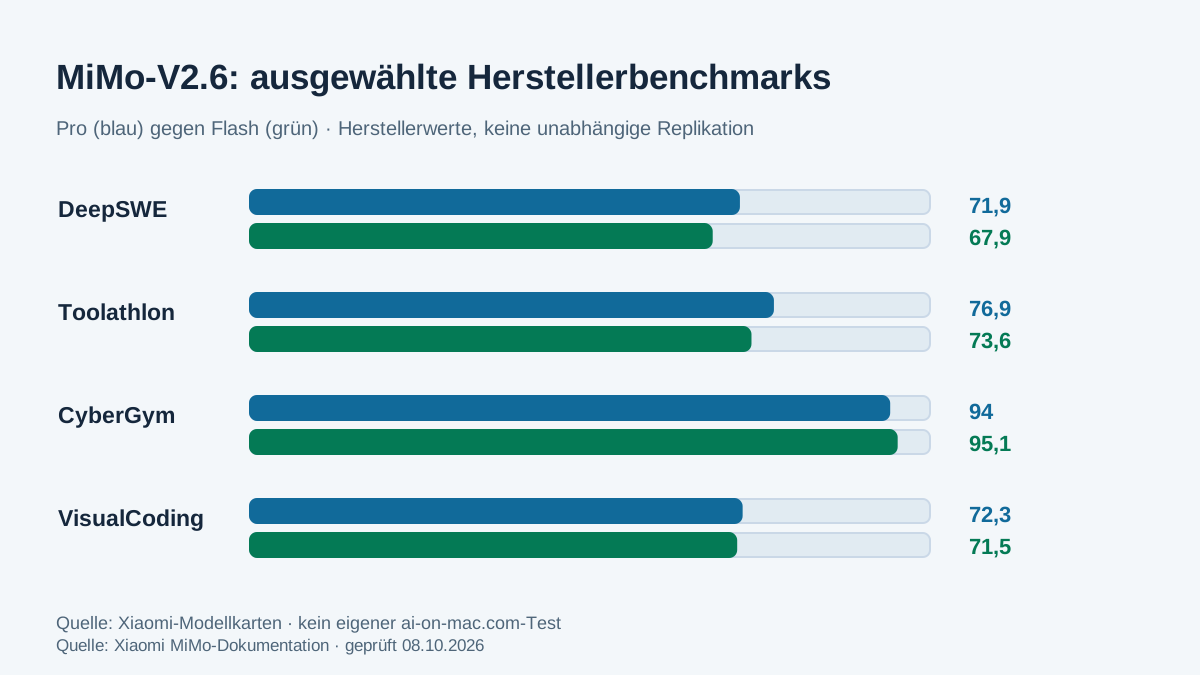
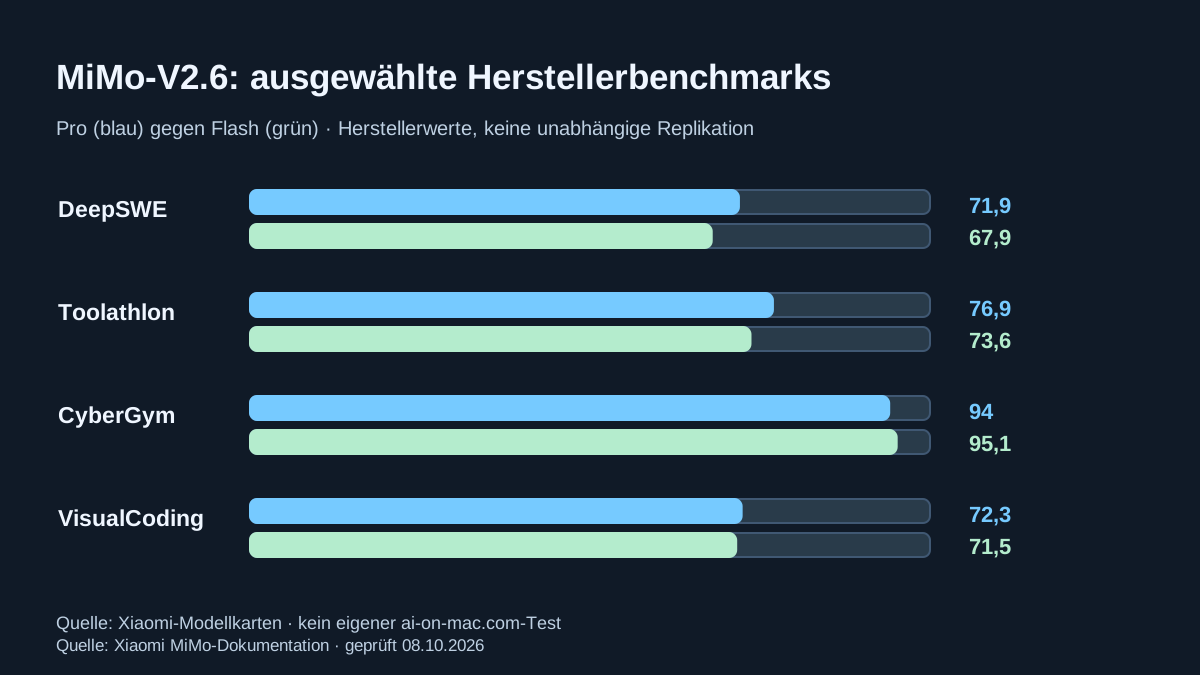
Xiaomis eigene Evaluationsdaten zeigen kein einheitliches Bild von „Pro schlägt Flash überall”. Pro liegt jedoch in der Mehrzahl der veröffentlichten Tests vorn:
| Benchmark | Pro | Flash | Differenz Pro − Flash |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 67,9 | +4,0 |
| ProgramBench | 26,5 | 26,0 | +0,5 |
| MiMo Code Bench | 63,2 | 61,2 | +2,0 |
| AutomationBench v1.0.6 | 53,1 | 52,3 | +0,8 |
| Toolathlon-Verified | 76,9 | 73,6 | +3,3 |
| Agents’ Last Exam | 31,6 | 27,6 | +4,0 |
| Terminal Bench 4.0 | 34,9 | 28,8 | +6,1 |
| OSWorld-Verified | 82,0 | 80,8 | +1,2 |
| JobBench | 62,0 | 61,2 | +0,8 |
| CyberGym | 94,0 | 95,1 | −1,1 |
| MiMo Cyber Bench | 80,2 | 77,2 | +3,0 |
| SEC Bench Pro | 66,3 | 47,5 | +18,8 |
| MiMo VisualCoding | 72,3 | 71,5 | +0,8 |
Praktisch ist der Abstand bei einigen allgemeinen Agenten- und visuellen Tests klein. Bei bestimmten Security-Aufgaben ist er deutlich größer. Gleichzeitig gewinnt Flash im veröffentlichten CyberGym-Wert knapp. Wer aus einer einzigen Zahl eine allgemeine Qualitätsrangliste ableitet, überinterpretiert die Daten.
Auch die Benchmarks selbst benötigen Kontext. DeepSWE v1.1 umfasst 113 langlaufende Software-Engineering-Aufgaben; Epoch AI fand bei einer Prüfung Probleme in mindestens 23 Aufgaben und stuft die Benchmarkversion deshalb als fehlerbehaftet ein. Terminal-Bench und CyberGym weisen ebenfalls darauf hin, dass Harness, Konfiguration und Stochastik die Resultate beeinflussen.
Unabhängige Messung: Artificial Analysis
Artificial Analysis misst MiMo-V2.6-Pro aktuell mit 46 Punkten im Intelligence Index und etwa 134 Output-Token/s über Xiaomis API. Der gemessene Preis entspricht der offiziellen Pro-Rate von $0,435/M Input und $0,87/M Output.
Das ist derzeit der stärkste unabhängige Querschnitt in der Quellenbasis dieses Artikels. Für Flash und insbesondere UltraSpeed liegen zum Recherchezeitpunkt noch nicht dieselben unabhängigen Messreihen vor. Xiaomis „bis zu 20ד-Aussage für UltraSpeed ist daher als Hersteller-Maximalangabe zu behandeln, nicht als garantierte Praxisbeschleunigung.
API-Kosten: drei Modelle, korrekte Cache-Rechnung
Xiaomis aktuelle Overseas-Preisliste bestätigt weiterhin die USD-Sätze für Pro, Flash und UltraSpeed. Es sind nutzungsabhängige API-Listenpreise pro Million Tokens – keine unlimitierten Abonnements. Eine einzelne Eingabe wird je nach tatsächlichem Cache-Status zum Cache-Miss- oder Cache-Hit-Tarif berechnet.
| Offizielle Overseas-API | Flash | Pro | UltraSpeed |
|---|---|---|---|
| Input, Cache Miss | 0,14 USD | 0,435 USD | 4,35 USD |
| Input, Cache Hit | 0,0028 USD | 0,0036 USD | 0,036 USD |
| Output | 0,28 USD | 0,87 USD | 8,70 USD |
| Batch-Input / Batch-Output | 0,07 / 0,14 USD | 0,2175 / 0,435 USD | nicht angeboten |
Beispielrechnungen – korrigiert am 8. Oktober 2026. Input und Cache-Tokens sind in Millionen angegeben; die Cache-Hits sind bereits Teil des Input-Gesamtwerts, nicht zusätzlich zu addieren. Alle Summen sind USD und ohne Zusatzgebühren:
| Szenario | Gesamter Input | davon Cache-Hit | Output | Flash | Pro | UltraSpeed |
|---|---|---|---|---|---|---|
| Leicht | 5 Mio. | 0 | 1 Mio. | 0,98 USD | 3,045 USD | 30,45 USD |
| Mittlerer Agent | 50 Mio. | 35 Mio. | 10 Mio. | 4,998 USD | 15,351 USD | 153,51 USD |
| Heavy Agent | 500 Mio. | 400 Mio. | 100 Mio. | 43,12 USD | 131,94 USD | 1.319,40 USD |
Rechenregel: (gesamter Input − Cache-Hits) × Input-Miss-Preis + Cache-Hits × Cache-Hit-Preis + Output × Output-Preis. Beispiel Pro bei 50 Mio. Input, 35 Mio. Cache-Hits und 10 Mio. Output: 15 × 0,435 + 35 × 0,0036 + 10 × 0,87 = 15,351 USD. Die früher hier genannten 19,351 USD waren ein Rechenfehler. Ein echter Cache-Treffer ist nicht garantiert; lange Sessions müssen denselben Präfix wiederverwenden.
Deutschland/EU: Die USD-Tarife sind keine zugesicherten EUR-Endpreise inklusive Umsatzsteuer. Die Preisliste verzeichnet parallel 5 USD je 1.000 Overseas-Websuche-/Parsing-Aufrufe; externe Tools und andere Gateways können zusätzlich kosten. UltraSpeed kostet beim regulären Input und Output genau 10× Pro, ist aber laut derselben offiziellen Preistabelle nicht als Batch API verfügbar.
UltraSpeed: Wann die 10× höheren Tokenpreise sinnvoll sein können
UltraSpeed ist kein „Pro Plus” mit einer eigenen, besser bewerteten Model Card. Xiaomi beschreibt es als Hochgeschwindigkeitsmodus für Pro und bewirbt bis zu 20× Inferenzgeschwindigkeit. OpenRouter beschreibt die Variante ebenfalls als aus demselben Pro-Checkpoint abgeleitet.
Der Mehrpreis ist deshalb primär ein Latenz-/Durchsatzpreis, nicht ein Preis für ein anderes Qualitätsniveau. Sinnvoll ist das bei interaktiven Agenten, Echtzeit-Code-Assistenten oder Workflows, in denen Wartezeit teurer ist als Tokenverbrauch. Für asynchrone Recherche, Batch-Verarbeitung oder große Hintergrundjobs ist der normale Pro- oder Flash-Tarif wirtschaftlich naheliegender.
Flash: der Preis-Leistungshebel der Familie
Flash ist mit 309B Gesamt- und 15B aktiven Parametern erheblich kleiner als Pro, behält aber 1M Kontext und dieselben vier Inputmodalitäten. In vielen Herstellerbenchmarks liegt es nur wenige Punkte hinter Pro. Gleichzeitig kostet es beim normalen API-Input weniger als ein Drittel und beim Output ebenfalls rund ein Drittel von Pro.
Für hohe Volumina ist das der wichtigste Unterschied. Wer hunderte Millionen Token pro Monat durch Agenten schiebt, sollte Flash nicht als „kleine Version” abtun, sondern separat auf den eigenen Aufgaben testen.
Pro: wenn die letzten Punkte wichtiger sind als der niedrigste Preis
Pro skaliert auf 1,02T Gesamtparameter bei 42B aktiven Parametern pro Token. Die veröffentlichten Resultate zeigen den größten Vorsprung gegenüber Flash bei einigen Security- und Long-Horizon-Aufgaben, während andere Tests beinahe gleichauf sind.
Das macht Pro vor allem dann interessant, wenn Fehlversuche in langen Agentenläufen teuer sind. Ein Modell, das pro Token mehr kostet, kann im Gesamtsystem günstiger sein, wenn es weniger Wiederholungen, weniger Recovery-Schritte oder weniger menschliche Nacharbeit braucht. Diese Behauptung lässt sich jedoch nicht aus der Xiaomi-Tabelle allein beweisen; dafür braucht es Workload-spezifische A/B-Tests.
Agenten-Integration: Responses API ist nicht vollständig OpenAI-kompatibel
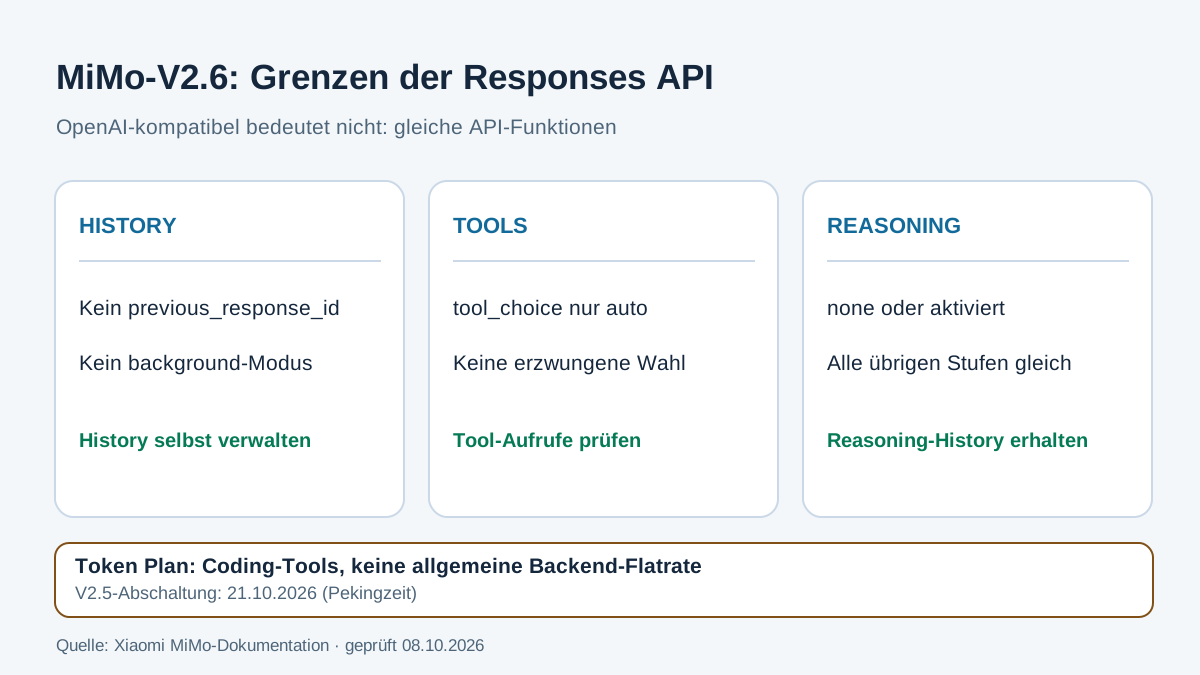
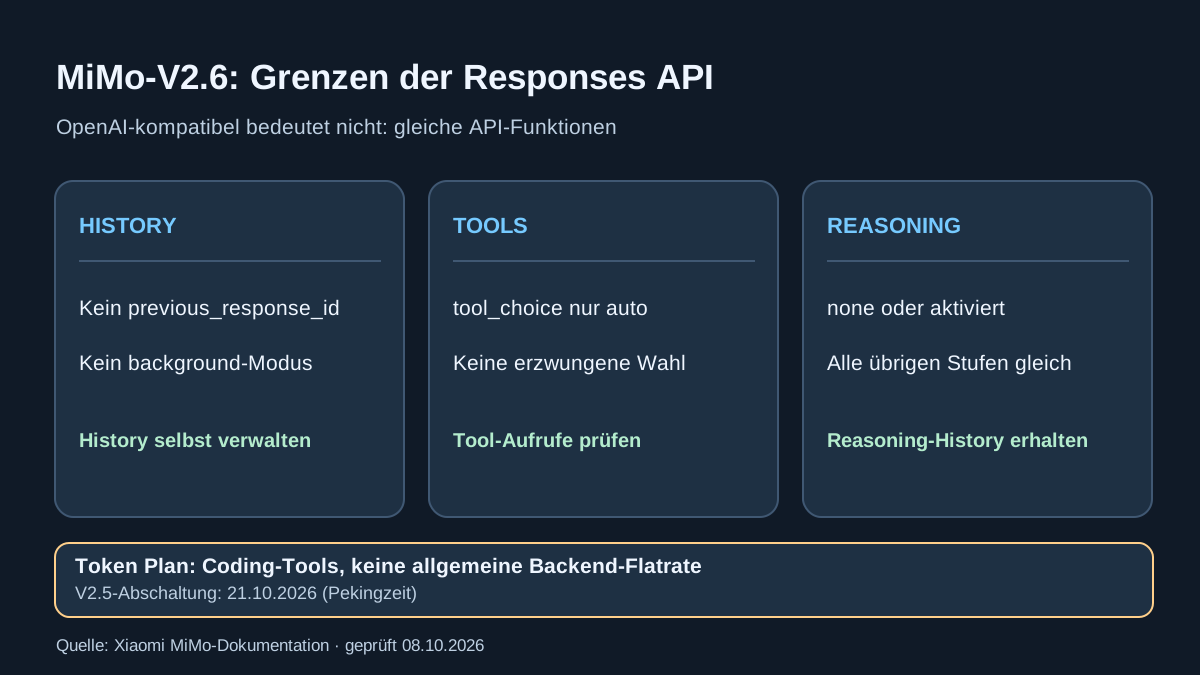
Die Responses-Dokumentation nennt den Endpoint https://api.xiaomimimo.com/v1/responses, die drei V2.6-Modell-IDs und für alle maximal 131.072 Output-Tokens einschließlich Reasoning-Tokens. Die Anbieterkompatibilität hat mehrere operative Grenzen:
background,previous_response_idundcontext_managementwerden nicht unterstützt; solche Felder können ignoriert werden oder Fehler verursachen. Agenten müssen die nötige Conversation History selbst verwalten.tool_choiceverhält sich aktuell nur wieauto. Eine erzwungene Tool-Auswahl über die Responses API ist damit nicht verlässlich.reasoning.effort=nonedeaktiviert Reasoning; alle anderen akzeptierten Stufen schalten es lediglich ein.high,xhigh,maxundultrabedeuten hier keine messbar abgestufte Rechenzeit.- In Thinking Mode werden
temperatureundtop_pauf 1,0 bzw. 0,95 gesetzt, auch wenn eine App andere Werte sendet. - Bei mehrstufigen Tool-Aufrufen die vorherige Reasoning-Historie mitliefern. Die OpenCode-Integrationsdokumentation erläutert einen möglichen HTTP-400-Fehler bei fehlendem
reasoning_content. - Structured Output ist endpunktspezifisch: Für Chat Completions dokumentiert Xiaomi
response_format: {"type":"json_object"}. Die Responses API verwendet dagegentext.format; nicht dokumentierteresponse_format-Felder keinesfalls blind zwischen Endpunkten übertragen.
Token Plan ist kein günstiger universeller Backend-API-Tarif
Der Xiaomi Token Plan ist für Coding-Werkzeuge wie OpenCode oder Claude Code ausgelegt. Er darf laut Xiaomi nicht für allgemeine Skripte oder Custom-App-Backends außerhalb von Coding-Szenarien zweckentfremdet werden. Ein Angebot mit 6 USD/Monat (Lite) steht deshalb nicht für eine unbegrenzte Pay-as-you-go-API. Die monatlichen Credits sind eine Verbrauchsquote, deren Reichweite vom Modell und Nutzungsprofil abhängt. Die aktuelle Plan-FAQ listet V2.6-Pro und Flash als unterstützte Modelle; ältere Übersichtsseiten enthalten noch V2.5-Listen. Für die Modellverfügbarkeit die aktuelle Konsole prüfen.
Migrationstermin: Xiaomi kündigt das Abschalten der MiMo-V2.5- und V2.5-Pro-Modellkennungen für 21. Oktober 2026, 10:00 Uhr Pekingzeit an. Neue Agenten sollten stattdessen die V2.6-IDs verwenden; bestehende Prompts und Tool-Parser vor der Umstellung testen.
Open Weights heißt nicht automatisch „läuft bequem lokal”
Xiaomi hat Pro und Flash unter MIT-Kennzeichnung auf Hugging Face veröffentlicht. Die eigenen Deployment-Beispiele zielen aber klar auf große GPU-Konfigurationen: Die SGLang-Beispiele nutzen für Pro u. a. Tensor Parallel 16 und zwei Nodes; Flash wird mit Tensor Parallel 8 gezeigt.
Für Mac-Nutzer ist deshalb die wichtige Aussage nicht „open = lokal einfach”, sondern: Die Gewichte sind offen, die Referenzbereitstellung ist aber Rechenzentrums-/Multi-GPU-orientiert. Quantisierungen und alternative Runtimes können das ändern, müssen für V2.6 jedoch separat gemessen werden. Dieser Artikel behauptet deshalb bewusst keine Mac-Tokens/s ohne reproduzierbaren Test.
Was hat Xiaomi beim Training anders gemacht?
Xiaomi hat sechs Tage des RL-Trainings öffentlich gestreamt. Nach Unternehmensangaben wurden Pro und Flash jeweils 30 RL-Schritte trainiert; die Kosten lagen bei ungefähr $2,62 Mio. für Pro und $0,85 Mio. für Flash. Die Runs erzeugten insgesamt ungefähr 750.000 Trajektorien.
Das Training mischte Coding-, General-Agent-, Visual- und Cybersecurity-Aufgaben in einem gemeinsamen RL-Prozess. Xiaomi beschreibt 1.568 Prompts × 16 Rollouts pro Schritt und Milliarden Token pro Update. Vor dem Release dokumentierten TechNode und NYU Shanghai RITS das Live-Dashboard; beide machten deutlich, dass die damaligen Zwischenwerte Herstellerdaten und keine unabhängigen Leaderboard-Einträge waren.
Fazit: MiMo-V2.6 als Zweimodellfamilie plus Geschwindigkeitsmodus
MiMo-V2.6 ist weniger eine Dreierfamilie als eine Zweimodellfamilie plus Geschwindigkeitsmodus. Flash priorisiert Kosten und Effizienz, Pro priorisiert maximale Modellkapazität, und UltraSpeed verkauft niedrigere Latenz bzw. höheren Durchsatz zu einem 10× höheren Tokenpreis als Pro.
Für eine reale Entscheidung empfiehlt sich der Vergleich praktischer Messgrößen neben isolierten Benchmarkwerten: Kosten pro erledigter Aufgabe, Fehlerrate, Anzahl nötiger Agent-Schritte und Gesamtlatenz. Genau dort kann sich zeigen, ob Flash trotz geringerer Modellgröße genügt, Pro Wiederholungen spart oder UltraSpeed die Wartezeit tatsächlich wirtschaftlich rechtfertigt.
Als Preis-Leistungs-Vergleich bieten sich Qwen3.8-Flash und DeepSeek V4.1 Flash an.
Häufig gestellte Fragen
Was unterscheidet MiMo-V2.6-Pro, Flash und UltraSpeed?
Flash ist mit 309B Gesamt- und 15B aktiven Parametern das Effizienzmodell, Pro das Flaggschiff mit 1,02T Gesamt- und 42B aktiven Parametern, und UltraSpeed ist nach Xiaomis Darstellung eine gehostete Hochgeschwindigkeits-Inferenzvariante der Pro-Familie — kein eigener Checkpoint.
Haben Flash und Pro beide 1M Kontext?
Ja. Die offiziellen Model Cards nennen für beide 1.048.576 Token, und Xiaomis Responses API listet für alle drei V2.6-Modell-IDs ein maximales Output-Limit von 131.072 Token.
Kann ich Xiaomis Lite-Token-Plan als unbegrenzte API nutzen?
Nein. Xiaomi begrenzt den Token Plan auf Coding-Werkzeuge und untersagt allgemeine Custom-Backends oder Non-Coding-Skripte. Credits sind endlich, und die drei V2.6-Modelle haben getrennte API-Listenpreise.
Welches Modell ist für hohe API-Volumina am günstigsten?
Flash mit 0,14 US-Dollar pro Million Input-Token und 0,28 US-Dollar pro Million Output-Token auf Xiaomis offizieller Pay-as-you-go-Rate. Pro kostet beim normalen Input etwa 3,11× so viel, UltraSpeed exakt 10× so viel wie Pro.
Sind Pro und Flash Open Source?
Die Gewichte sind auf Hugging Face veröffentlicht und die Model Cards tragen eine MIT-Lizenzkennzeichnung. Präziser ist die Formulierung 'Open Weights unter MIT-Lizenz'. Für Mac-Nutzung gibt es aktuell keine offiziellen Token-pro-Sekunde-Werte.
Ist UltraSpeed ein stärkeres Modell als Pro?
Nach den verfügbaren Quellen nein. Xiaomi und OpenRouter beschreiben UltraSpeed als schnelle Inferenzvariante der Pro-Familie, nicht als separat bewerteten Checkpoint. Der Mehrpreis ist primär ein Latenz-/Durchsatzpreis.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- mimo.mi.com token-plan / Plans&Pricing
- mimo.mi.com text-generation / structured-output
- mimo.mi.com latest / v2-6
- mimo.mi.com price / pay-as-you-go
- mimo.mi.com chat / responses
- mimo.mi.com chat / openai-api
- mimo.mi.com summary / first-api-call
- mimo.mi.com guidance / rate-limit
- mimo.mi.com faq / api-integration
- mimo.mi.com price / token-plan
- mimo.mi.com integration / codex-configuration
- mimo.mi.com integration / opencode
- mimo.mi.com integration / mimo-desktop
- huggingface.co XiaomiMiMo / MiMo-V2.6-Pro-RL
- huggingface.co XiaomiMiMo / MiMo-V2.6-Flash-RL
- huggingface.co XiaomiMiMo / mimo-v26
- github.com XiaomiMiMo / MiMo
- artificialanalysis.ai models / mimo-v2-6-pro
- artificialanalysis.ai mimo-v2-6-pro / providers
- openrouter.ai xiaomi / mimo-v2.6-pro
- openrouter.ai xiaomi / mimo-v2.6-flash
- openrouter.ai xiaomi / mimo-v2.6-pro-ultraspeed
- technode.com 18 / xiaomi-livestreams-mimo-v2-6-reinforcement-learning-runs
- rits.shanghai.nyu.edu ai / xiaomi-mimo-v2-6-live-rl-dashboard
- runtimewire.com article / xiaomi-open-sources-mimo-v2-6-rl-cost-3-47m
- deepswe.datacurve.ai deepswe.datacurve.ai
- epoch.ai deepswe / review
- programbench.com programbench.com
- tbench.ai www.tbench.ai
- cybergym.io cybergym
- github.com SEC-bench / SEC-bench-Pro
- github.com MaxIntelligenceAgency / ALE-Benchmark
- designarena.ai about
- reddit.com 1wmnw89 / xiaomimimomimov26flashrl_hugging_face
- opencode.ai xiaomi / mimo-v2-6-pro