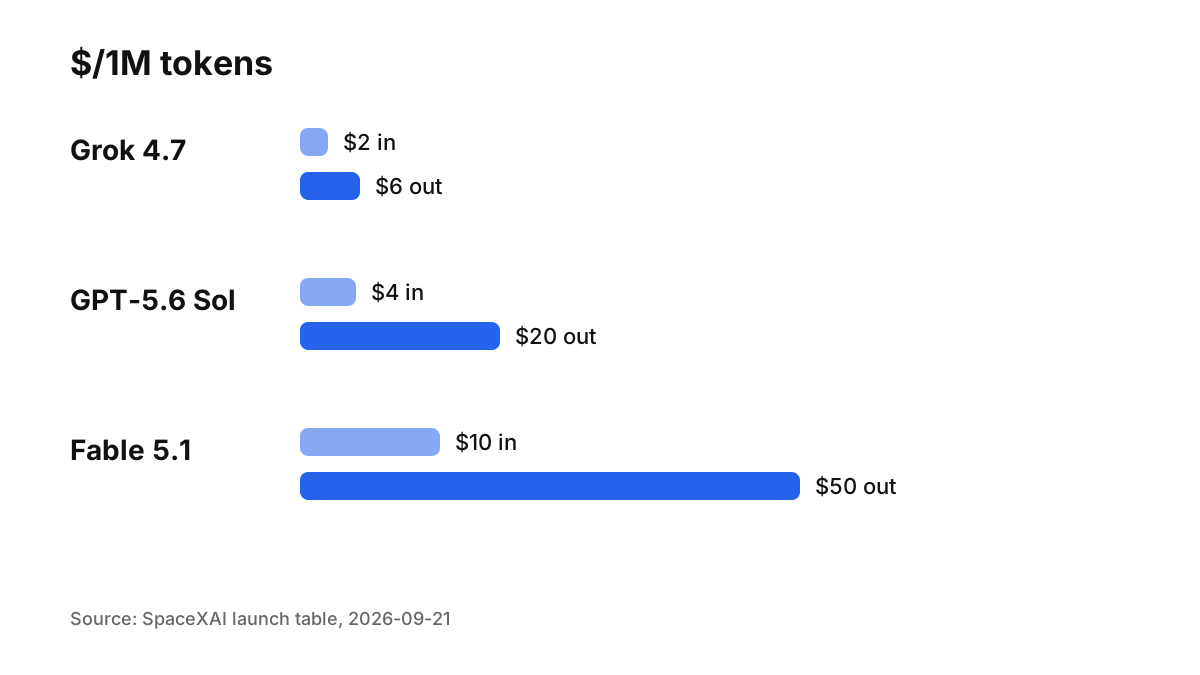
Aktualisiert am 8. Oktober 2026. Die nachfolgenden September-Benchmarkwerte bleiben historische Launch-Messungen, keine neu erhobenen unabhängigen Benchmarks. SpaceXAI hat Grok 4.7 am 21. September 2026 als neues Frontier-Modell für Coding, agentische Aufgaben und Wissensarbeit veröffentlicht. Das Modell kostet in der öffentlichen xAI-API zunächst 2 US-Dollar pro 1 Mio. Input-Tokens, 0,50 US-Dollar pro 1 Mio. gecachte Input-Tokens und 6 US-Dollar pro 1 Mio. Output-Tokens. Oberhalb von 200.000 Prompt-Tokens verdoppeln sich diese Tokenpreise. Das maximale Kontextfenster beträgt 500.000 Tokens. Grok 4.7 ist vor allem interessant, wenn lange Coding- oder Wissens-Workflows mit hohen Output-Mengen zu vertretbaren API-Kosten laufen sollen: Das Modell gewinnt Benchmarks nicht pauschal, liefert in mehreren agentischen Testläufen jedoch ein auffällig starkes Preis-Leistungs-Verhältnis.


Der wichtigste Punkt ist jedoch nicht ein einzelner Benchmarkwert. Grok 4.7 ist deutlich stärker als Grok 4.6 bei mehreren langen Agent-Aufgaben, bleibt beim Listenpreis aber auf demselben Niveau. Gleichzeitig zeigen unabhängige Evaluierungen, dass die Verbesserungen je nach Harness deutlich kleiner ausfallen können als in SpaceXAIs Launch-Tabelle. Wer das Modell bewerten will, sollte daher Herstellerwerte, unabhängige Messungen und reale Kosten pro erledigter Aufgabe getrennt betrachten.
Was ist bei Grok 4.7 neu?
SpaceXAI beschreibt Grok 4.7 als größeres Basismodell als Grok 4.6. Das Training erhielt einen längeren Reinforcement-Learning-Lauf mit stärkerem Gewicht auf Aufgaben, die viele Arbeitsschritte oder mehrere Stunden erfordern. Gleichzeitig soll das Modell Zwischenergebnisse häufiger gegenprüfen und langen Kontext zuverlässiger verwalten. Der Anbieter nennt als Einsatzfelder Coding, allgemeine Wissensarbeit und agentische Aufgaben.
Offiziell unterstützt grok-4.7 Text- und Bildeingaben sowie Textausgabe. Für API-Nutzer stehen Reasoning-Stufen low, medium, high und xhigh zur Verfügung; high ist der Standard. Die Dokumentation nennt Funktion Calling, strukturierte Ausgaben, Web Search, X Search und Code Execution als unterstützte Werkzeuge.
Ein praktisches Detail für lange Agent-Loops ist Prompt Caching. Identische Prompt-Präfixe können zu einem reduzierten Cache-Preis verarbeitet werden. SpaceXAI empfiehlt dafür einen stabilen prompt_cache_key beziehungsweise x-grok-conv-id; ein Cache-Treffer ist trotzdem nicht garantiert.
Grok 4.7: Preise und Kontextfenster
| API-Tarif | Input / 1 Mio. | Cached Input / 1 Mio. | Output / 1 Mio. | Kontext |
|---|---|---|---|---|
| Standard bis 200k Prompt-Tokens | $2.00 | $0.50 | $6.00 | bis 500k |
| Long Context über 200k Prompt-Tokens | $4.00 | $1.00 | $12.00 | bis 500k |
Datenstand: 22.09.2026. Quelle: SpaceXAI Docs.
Die Grenze bei 200k ist wichtig: 500k Kontext bedeutet nicht, dass alle 500k Tokens zum Basistarif verarbeitet werden. In Cursor wird die Staffelung anders dargestellt: Dort gilt für Grok 4.7 ein Standardfenster von 256k und ein Long-Context-Modus bis 500k, mit Cursor-spezifischer Abrechnung.
Beispielkosten: drei realistische Nutzungsszenarien
Die folgenden Werte sind eigene Berechnungen und ignorieren Tool-Aufrufe, Steuern, Währungsumrechnung und mögliche Router-Aufschläge.
| Szenario | Monatsvolumen | Ohne Cache | Bei 70 % Cache-Hit auf Input |
|---|---|---|---|
| Leicht | 15 Mio. Input + 3 Mio. Output | $48.00 | $32.25 |
| Mittel | 120 Mio. Input + 24 Mio. Output | $384.00 | $258.00 |
| Intensiv | 450 Mio. Input + 60 Mio. Output | $1,260.00 | $787.50 |
Formel ohne Cache: Input-Mio. × $2 + Output-Mio. × $6. Bei 70 % Cache-Hit wird 70 % des Inputs mit $0,50 statt $2,00 berechnet. Diese Szenarien setzen voraus, dass einzelne Requests unter der 200k-Long-Context-Schwelle bleiben.
Benchmarks: wo Grok 4.7 tatsächlich zulegt
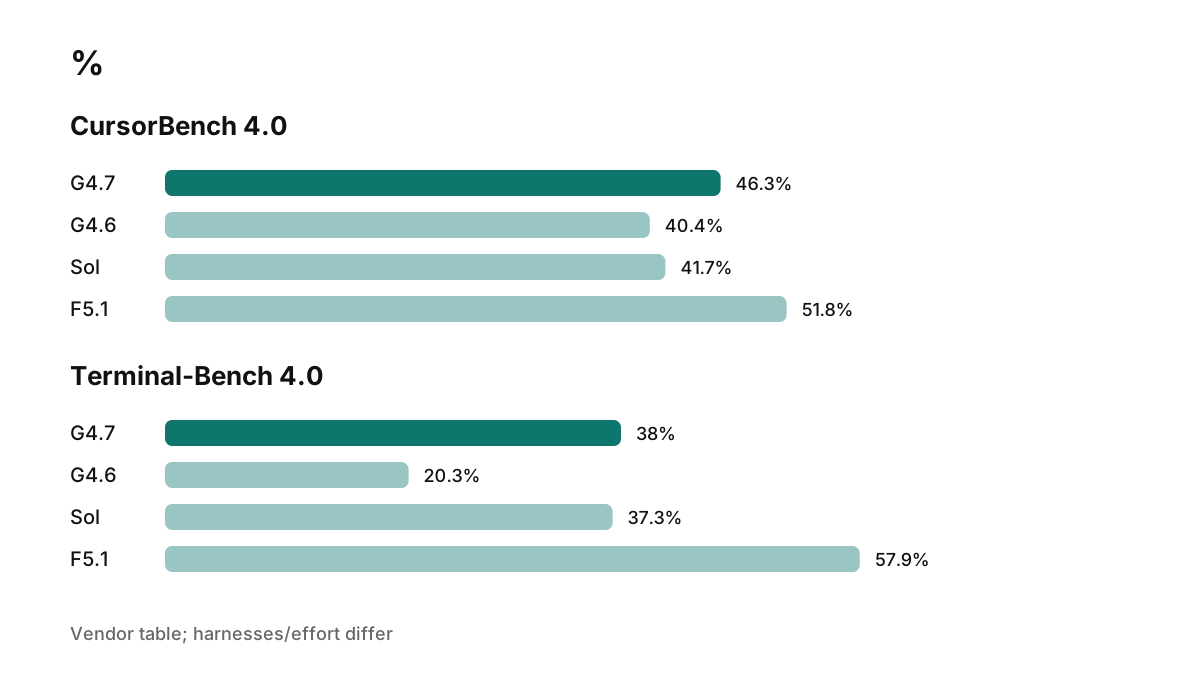
SpaceXAIs Launch-Tabelle vergleicht Grok 4.7 überwiegend bei xhigh mit Grok 4.6 bei high, GPT-5.6 Sol bei max und Fable 5.1 bei max. Schon deshalb sind die Werte keine vollständig kontrollierte Gleichbehandlung der Modelle.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3 % | 40.4 % | 41.7 % | 51.8 % |
| DeepSWE v1.1 | 71.0 %* | 65.2 % | 72.7 % | 70.0 % |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0 % | 20.3 % | 37.3 % | 57.9 % |
| Harvey Legal Agent | 19.6 % | 15.8 % | 2.5 % | 6.7 % |
| HealthBench Professional | 56.7 % | 48.5 % | 60.5 % | 62.1 % |
| EEBench | 64.0 % | 53.0 % | 39.4 % | 56.4 % |
* Der Grok-4.7-Wert für DeepSWE ist laut Launch-Tabelle bei high gemessen. Quelle der Tabelle: SpaceXAI; nicht alle Werte wurden unabhängig reproduziert.
CursorBench ist gut nachvollziehbar
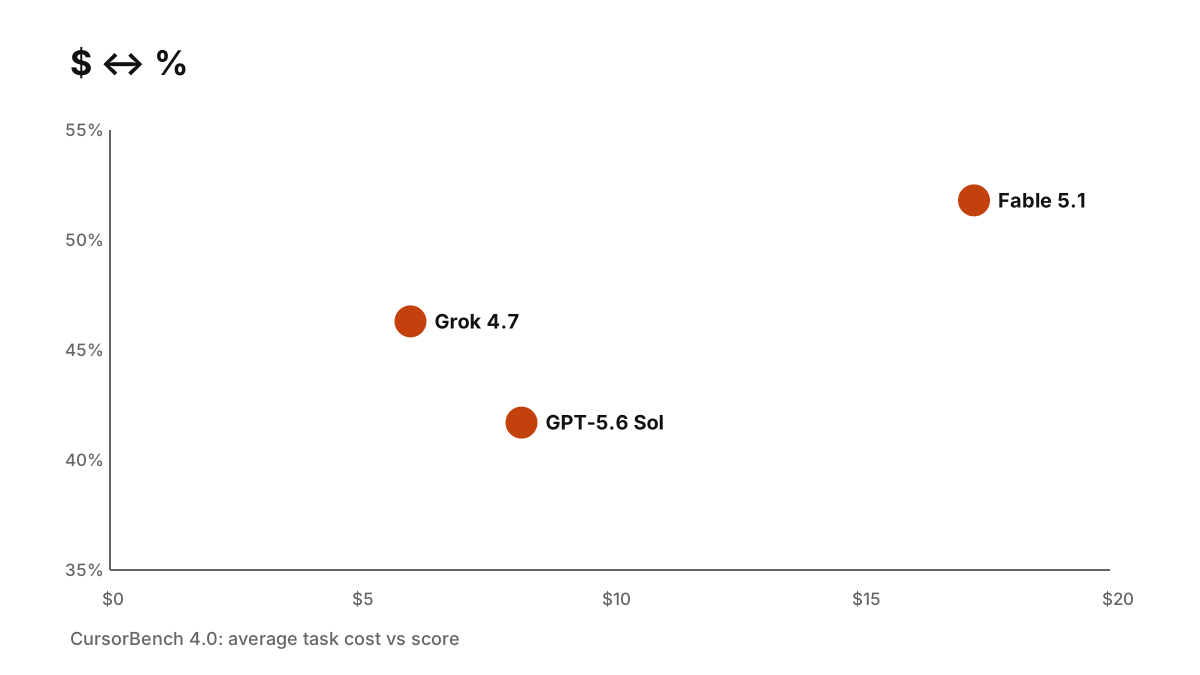
Cursor legt für CursorBench 4.0 neben Scores auch Kosten, Tokens und Schrittzahlen offen. Grok 4.7 Extra High erreicht dort 46,3 % bei durchschnittlich 6,01 US-Dollar pro Aufgabe und liegt beim Score unter Fable 5.1 Max mit 51,8 %, kostet in diesem Test aber deutlich weniger pro Aufgabe.
Unabhängige Tests bestätigen den Fortschritt – aber nicht jede Größenordnung
Artificial Analysis bewertet Grok 4.7 bei xhigh mit 46 Punkten im Intelligence Index und meldet bei AA-Briefcase 1.657 Elo. Beim eigenen Coding-Agent-Index mit Grok Build steigt der Wert gegenüber Grok 4.6 deutlich. Gleichzeitig verbrauchte Grok 4.7 in der Intelligence-Index-Auswertung deutlich mehr Output-Tokens als Grok 4.6. Das ist entscheidend: Ein günstiger Preis pro Million Tokens garantiert keine niedrigen Kosten pro abgeschlossener Aufgabe.
Bei Terminal-Bench zeigt sich die größte Warnung vor dem Vermischen von Ergebnissen. SpaceXAI nennt 38,0 %, während Artificial Analysis in einer anderen Ausführungsumgebung einen niedrigeren Wert misst. Das ist kein Beweis, dass eine Seite falsch liegt; es zeigt, wie stark Agent-Harness, Tools, Zeitbudget und Einstellungen das Ergebnis beeinflussen können.
EEBench und HealthBench brauchen zusätzliche Vorsicht
SpaceXAI meldet 64,0 % für EEBench. Beim Abruf des öffentlichen EEBench-Leaderboards am 22. September war jedoch noch keine eigene Grok-4.7-Zeile sichtbar. Der Wert sollte daher bis zu einer unabhängigen Veröffentlichung ausdrücklich als Herstellerwert bezeichnet werden.
HealthBench Professional basiert auf 525 klinischen Aufgaben aus realen ChatGPT-for-Clinicians-Konversationen und wurde mit ärztlich erstellten Rubriken aufgebaut. Eine aktuelle Methodenkritik von Epoch AI fand in einer Stichprobe jedoch zahlreiche Probleme in Aufgaben und Rubriken. Der Benchmark ist damit nützlich, aber kein Beleg dafür, dass ein Modell für unbeaufsichtigte klinische Entscheidungen geeignet wäre.
API-Betrieb: Cache, US-Region, Fast und Batch
Tarife und Zugänge nicht vermischen. Laut Grok-4.7-Modellguide ist Grok 4.7 Fast kein öffentliches API-Modell. Die schnellere Variante gibt es nur über Cursor und Grok Build mit deren Plan-Abrechnung. Sie kostet rechnerisch 2× die Standard-Tokenpreise beziehungsweise 1,5× im Long-Context-Tarif: Diese Multiplikatoren gelten nicht für den regulären API-Modellnamen grok-4.7.
Gleiche Prompt-Präfixe garantieren keinen Cache-Hit. Sende einen stabilen prompt_cache_key in der Responses API beziehungsweise x-grok-conv-id bei Chat Completions, damit Folgeturns möglichst denselben Server erreichen. Bei einem kalten Server fallen normale Input-Kosten statt $0,50/M Cache-Kosten an. Die Responses API liefert reasoning.encrypted_content automatisch; für weitere Turns die verschlüsselten Reasoning-Elemente unverändert zurückreichen. xAI-Guide.
| Zugangsweg | Tatsächlicher Umfang | Preis-/Limitfalle |
|---|---|---|
Öffentliche API grok-4.7 | Text und Bild rein, Text raus, bis 500K Kontext | Bis 200K Prompt: $2/$0,50/$6 je Mio. Input/Cache/Output; darüber $4/$1/$12 |
https://us.api.x.ai/v1 | Festgelegter US-Region-Endpunkt | 10 % Regionalaufschlag; echte Account-Konfiguration prüfen |
| Cursor / Grok Build Fast | Schnellere Bereitstellung | Keine öffentliche API-Modell-ID; Plan-Abrechnung |
| Batch API | Laut xAI-Tabelle für Grok 4.7 nicht unterstützt | Keinen erfundenen Batch-Rabatt kalkulieren |
Die Preisgrenze hängt an der Prompt-Länge je Request, nicht am gesamten Monatsverbrauch. Web-/X-Suche und Code Execution können separat kosten. Für Agentenvergleiche Cache-Hits, Region, Effort und Tool-Aufrufe zusammen auswerten statt nur $2/M Input anzusetzen.
API, Tools und Agent-Funktionen
Für neue Integrationen empfiehlt SpaceXAI die Responses API. Sie kann Konversationszustand serverseitig speichern; Responses werden laut Dokumentation standardmäßig 30 Tage vorgehalten. Grok 4.7 gibt in der Responses API verschlüsselten Reasoning-Inhalt zurück, der für mehrstufige Workflows wieder mitgesendet werden kann.
Unterstützte Werkzeuge umfassen:
- Function Calling für eigene APIs und Systeme.
- Structured Outputs mit JSON-Schema.
- Web Search für aktuelle Webquellen.
- X Search für Inhalte auf X; seit 21. September 2026 gelten neue, nutzungsabhängige Preise für abgerufene Posts beziehungsweise Profile.
- Code Execution für Python-basierte Berechnungen und Datenanalyse.
- Context Compaction für lange Agent-Verläufe, um alten Kontext zu verdichten und Eingabekosten zu reduzieren.
Datenschutz und Business-Nutzung
Für Business- und API-Kunden erklärt SpaceXAI, dass Geschäftsdaten standardmäßig nicht zum Training eigener Modelle verwendet werden. Die Consumer Privacy Policy ist ausdrücklich von der Verarbeitung im Auftrag von Business-Kunden abgegrenzt; für solche Fälle sind Enterprise Terms und Data Processing Addendum maßgeblich.
Das bedeutet nicht, dass jede API-Nutzung automatisch Zero Data Retention hat. Die konkrete Speicherung hängt vom Produkt und den gewählten API-Optionen ab. Bei der Responses API nennt die Dokumentation eine 30-tägige Speicherung, sofern der Workflow nicht entsprechend konfiguriert wird.
Für wen lohnt sich Grok 4.7?
Grok 4.7 ist besonders plausibel für Entwickler und Teams, die lange agentische Coding-Aufgaben, Recherche oder Dokumentarbeit automatisieren und dabei hohe Output-Kosten vermeiden wollen. Der Listenpreis liegt deutlich unter den in der SpaceXAI-Vergleichstabelle genannten Preisen von GPT-5.6 Sol und Fable 5.1.
Weniger eindeutig ist der Wechsel, wenn bereits Grok 4.6 zuverlässig läuft. Der neue Stand verbessert viele Long-Horizon-Aufgaben, kann bei sehr hohen Reasoning-Stufen aber auch wesentlich mehr Tokens verbrauchen. Deshalb sollte der Vergleich mit dem eigenen Prompt-Set auf Task-Erfolg, Gesamtpreis, Laufzeit und Fehlerrate erfolgen, statt allein auf Listenpreise oder isolierte Benchmark-Scores zu vertrauen.
Fazit: Grok 4.7 als Preis-Leistungs-Hebel für lange Agent-Workflows
Grok 4.7 kombiniert ein 500k-Kontextfenster, vier Reasoning-Stufen, agentische Tools und einen relativ niedrigen API-Listenpreis. Seine überzeugendsten öffentlich nachvollziehbaren Signale sind der bessere CursorBench-Wert, die starken AA-Briefcase/GDPval-AA-Ergebnisse und die niedrigen Tokenpreise. Die größte Einschränkung ist zugleich typisch für moderne Agent-Modelle: Benchmarks reagieren stark auf Harness, Tooling und Reasoning-Budget. Wer Grok 4.7 produktiv einsetzen will, sollte deshalb einen kleinen reproduzierbaren Eval-Satz aus den eigenen Aufgaben bauen und Kosten pro erfolgreich abgeschlossener Aufgabe messen.
Der vorherige Stand steht im Grok-4.6-Faktencheck.
Häufig gestellte Fragen
Was kostet Grok 4.7 pro Million Token?
Standardtarif bis 200.000 Prompt-Tokens: 2 US-Dollar pro Million Input-Token, 0,50 US-Dollar pro Million gecachte Input-Token und 6 US-Dollar pro Million Output-Token. Über 200.000 Prompt-Tokens verdoppeln sich diese Raten auf 4/1/12 US-Dollar.
Wie groß ist das Kontextfenster von Grok 4.7?
Das maximale Kontextfenster beträgt 500.000 Token. Wichtig: Bei Überschreiten der 200.000-Prompt-Token-Schwelle greift der Long-Context-Aufschlag, alle Token werden dann zum doppelten Tarif abgerechnet.
Welche Reasoning-Stufen unterstützt Grok 4.7?
Die API bietet die Stufen low, medium, high und xhigh. Standard ist high. Verschlüsselte Reasoning-Inhalte werden in der Responses API zurückgegeben und können für mehrstufige Workflows wieder mitgesendet werden.
Ist Grok 4.7 besser als Grok 4.6?
SpaceXAI nennt für Grok 4.7 bei xhigh in mehreren Long-Horizon-Agent-Tests deutliche Verbesserungen gegenüber Grok 4.6 bei high. Unabhängige Messungen wie Artificial Analysis bestätigen den Fortschritt, zeigen aber, dass der Abstand je nach Harness und Reasoning-Stufe kleiner ausfallen kann.
Werden Geschäftsdaten zum Training verwendet?
SpaceXAI erklärt in der Enterprise-FAQ, dass Business-Inputs und -Outputs standardmäßig nicht zum Training eigener Modelle verwendet werden. Die Consumer Privacy Policy ist davon ausdrücklich abgegrenzt; für Business-Kunden gelten Enterprise Terms und Data Processing Addendum.
Wie lange speichert die Responses API Inhalte?
Die Dokumentation beschreibt eine 30-tägige Speicherung von Responses, sofern der Workflow nicht abweichend konfiguriert wird. Teams mit strengen Retention-Anforderungen sollten die exakte API-Konfiguration vertraglich absichern, statt sie vom Modellnamen abzuleiten.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- x.ai news / grok-4-7
- docs.x.ai models / grok-4.7
- docs.x.ai developers / grok-4-7
- docs.x.ai developers / release-notes
- docs.x.ai developers / pricing
- docs.x.ai text / reasoning
- docs.x.ai inference / responses
- docs.x.ai text / structured-outputs
- docs.x.ai tools / function-calling
- docs.x.ai tools / web-search
- docs.x.ai tools / x-search
- docs.x.ai tools / code-execution
- docs.x.ai prompt-caching / how-it-works
- docs.x.ai prompt-caching / best-practices
- docs.x.ai model-features / context-compaction
- x.ai legal / privacy-policy
- x.ai legal / terms-of-service
- x.ai enterprise-terms
- x.ai data-processing-addendum
- cursor.com models / grok-4-7
- cursor.com blog / cursorbench-4
- cursor.com blog / cursorbench-methodology
- artificialanalysis.ai models / grok-4-7
- artificialanalysis.ai articles / grok-4-7
- artificialanalysis.ai methodology / intelligence-index
- artificialanalysis.ai methodology / coding-agent-index
- artificialanalysis.ai articles / grok-build-coding-agent-benchmark
- artificialanalysis.ai leaderboards / models
- eebench.ai leaderboard
- openai.com index / healthbench
- epoch.ai benchmarks / healthbench
- huggingface.co openai / healthbench
- tbench.ai www.tbench.ai
- github.com MaxIntelligenceAgency / ALE-Benchmark