Versionsstand (11. Oktober 2026): Im Fokus steht Grok 4.6. Grok 4.7 erschien am 21. September 2026 und ist über die xAI-API als grok-4.7 verfügbar. xAI nennt dieselben Einstiegspreise ($2 je Million Input- und $6 je Million Output-Tokens). Modellfunktionen und Zugangsbedingungen müssen dennoch getrennt geprüft werden. Die nachfolgenden 4.6-Benchmarkangaben bleiben historische Momentaufnahmen. Offizielle Ankündigung · API-Changelog.
Produktangaben geprüft am 11. Oktober 2026; ursprüngliche Recherche vom 24. August. Grok 4.6 ist seit dem 12. August 2026 verfügbar. Die aktuelle offizielle SpaceXAI-Dokumentation bestätigt die Modell-ID grok-4.6, ein Kontextfenster von 500.000 Tokens, Text- und Bildeingabe, Textausgabe sowie die Basispreise von 2 US-Dollar pro 1 Million Input-Tokens und 6 US-Dollar pro 1 Million Output-Tokens. Gecachte Input-Tokens kosten 0,50 US-Dollar pro Million; bei Prompts über 200.000 Tokens gelten höhere Input-Tarife. 12
Der gemeldete Plus von fünf Punkten gegenüber Grok 4.5 im Artificial Analysis Intelligence Index bleibt eine qualifizierte Drittquelle und kein von uns reproduzierter 4.6-Score. 3 Die finale Parameterzahl und die vollständige unabhängige Benchmarkmethodik sind weiterhin nicht sauber primär dokumentiert. Genau diese Trennung ist für eine fundierte Mac-Entscheidung wichtiger als eine scheinpräzise Spezifikation.
API-Kosten mit und ohne langen Kontext
xAI nennt für Grok 4.6 2/0,50/6 US-Dollar pro Million Input-/Cache-Read-/Output-Tokens bei normalem Kontext und 4/1/12 US-Dollar bei mindestens 200.000 Input-Tokens. Das Modell hat maximal 500.000 Kontext-Tokens. Diese Preise stammen aus xAIs Modellkarte, nicht aus einer Messung auf einem Mac.
| Anfrage ohne Cache, Batch oder Tools | Eingabe | Ausgabe | Gesamt |
|---|---|---|---|
| 100.000 Input + 10.000 Output | 0,20 $ | 0,06 $ | 0,26 $ |
| 300.000 Input + 10.000 Output | 1,20 $ | 0,12 $ | 1,32 $ |
Bei der langen Anfrage wurde der höhere Tarif für den gesamten Request angewandt. Bei produktiven Agenten entstehen durch Wiederholungen, Tool-Aufrufe und erneutes Senden von Kontext zusätzliche Kosten. Aus diesen Beispielrechnungen lässt sich keine Modellqualität ableiten.
Aktueller Stand
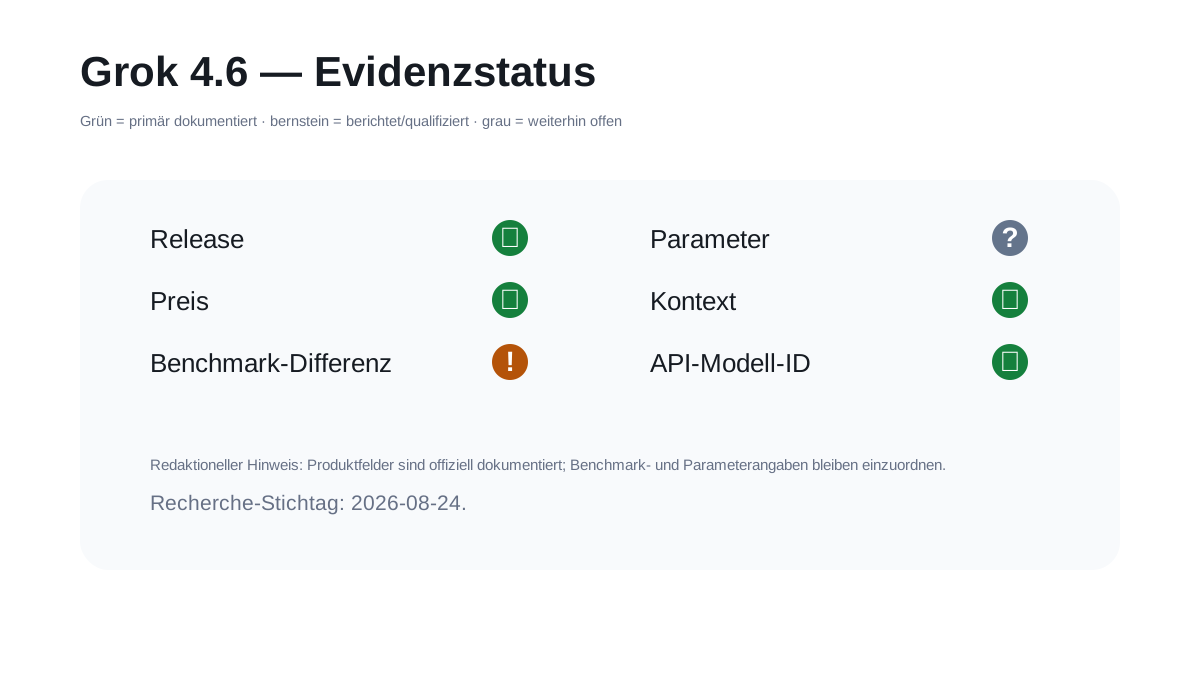
- Release: 12. August 2026; die aktuelle SpaceXAI-Doku führt Grok 4.6 als verfügbares Modell. 41
- Leistung: MarketWatch berichtet auf Basis von Artificial Analysis einen Sprung um fünf Punkte gegenüber 4.5. 3
- Preis: offiziell $2/M Input, $0,50/M gecachter Input und $6/M Output; über 200K Prompt-Kontext gelten höhere Input-Tarife. 12
- Modell-ID: offiziell
grok-4.6; die Doku zeigt Responses API und OpenAI-kompatible Nutzung. 12 - Kontext und Modalitäten: 500K Tokens, Text- und Bildeingabe, Textausgabe. 12
- Weiter offen: finale Parameterzahl und ein direkt reproduzierbarer unabhängiger 4.6-Leaderboard-Score.


Schnellerer Release-Zyklus statt reiner Namenswechsel
Die offizielle Grok-4.5-Ankündigung trägt das Datum 16. Juli 2026. Ein eigenständiger API-Freigabetermin am 8. Juli lässt sich daraus nicht belegen, daher verwenden wir hier das dokumentierte Releasedatum. Das Modell richtet sich an Coding, agentische Aufgaben und Wissensarbeit; die offizielle Ankündigung beschreibt Training über Coding, Wissenschaft, Engineering und Mathematik sowie umfangreiches Reinforcement Learning auf technischen Mehrschritt-Aufgaben. 5 Knapp vier Wochen später folgte bereits Grok 4.6.
Das macht die Versionsnummer allein allerdings wenig aussagekräftig. Für Entwickler zählt, ob die neue Version bei realen Agentenläufen bessere Ergebnisse pro Dollar und pro Zeiteinheit liefert. Genau dort liegt die interessanteste unabhängige Information: MarketWatch berichtet, dass Grok 4.6 auf dem Intelligence Index von Artificial Analysis fünf Punkte über 4.5 liegt und damit wieder in die Nähe der aktuellen Frontier-Spitze rückt. 3
Benchmark: Was bedeutet „fünf Punkte besser“?
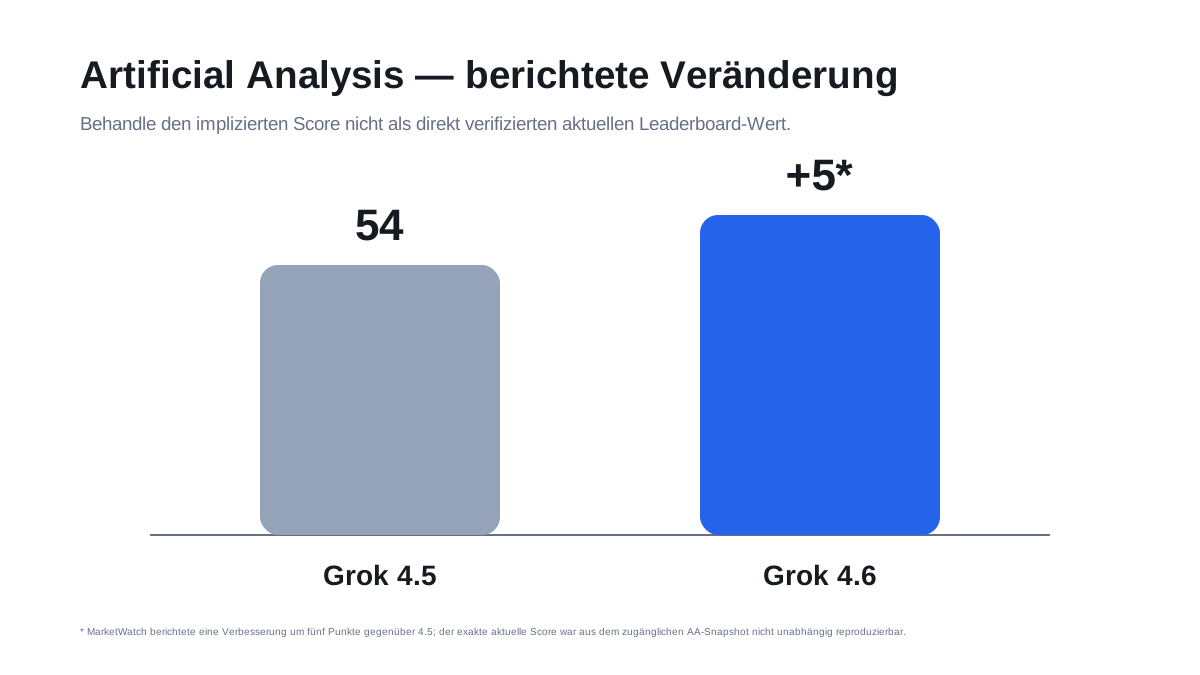
Für Grok 4.5 ist ein Artificial-Analysis-Score von 54 in den zugänglichen Juli-Snapshots direkt dokumentiert. 678 Ein Plus von fünf Punkten würde rechnerisch auf ungefähr 59 hinauslaufen. Dieser rechnerische Wert ist jedoch kein direkt verifizierter Score, solange der entsprechende 4.6-Eintrag im aktuellen AA-Snapshot nicht selbst geprüft werden kann.
Das ist keine Pedanterie. Benchmark-Indizes können ihre Methodik ändern, Modelle können mit unterschiedlichen Reasoning-Einstellungen getestet werden und ein Medienbericht kann sich auf einen späteren Snapshot beziehen als die öffentlich gecrawlte Modellseite. Die belastbare Formulierung lautet deshalb:
MarketWatch berichtet für Grok 4.6 einen Vorsprung von fünf Punkten gegenüber Grok 4.5 im Artificial Analysis Intelligence Index. 3
Nicht belastbar wäre: „Grok 4.6 hat sicher Score 59“, ohne den entsprechenden aktuellen Leaderboard-Eintrag zu sehen.
Offizieller Basistarif: $2 Input, $0,50 Cache und $6 Output
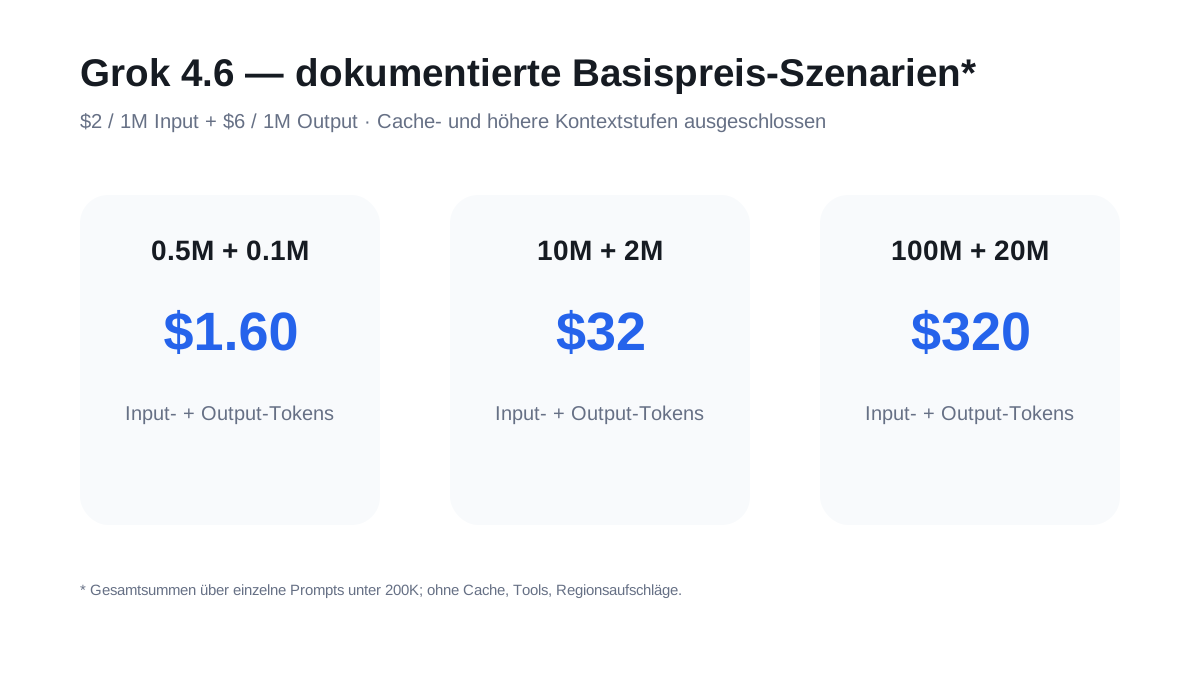
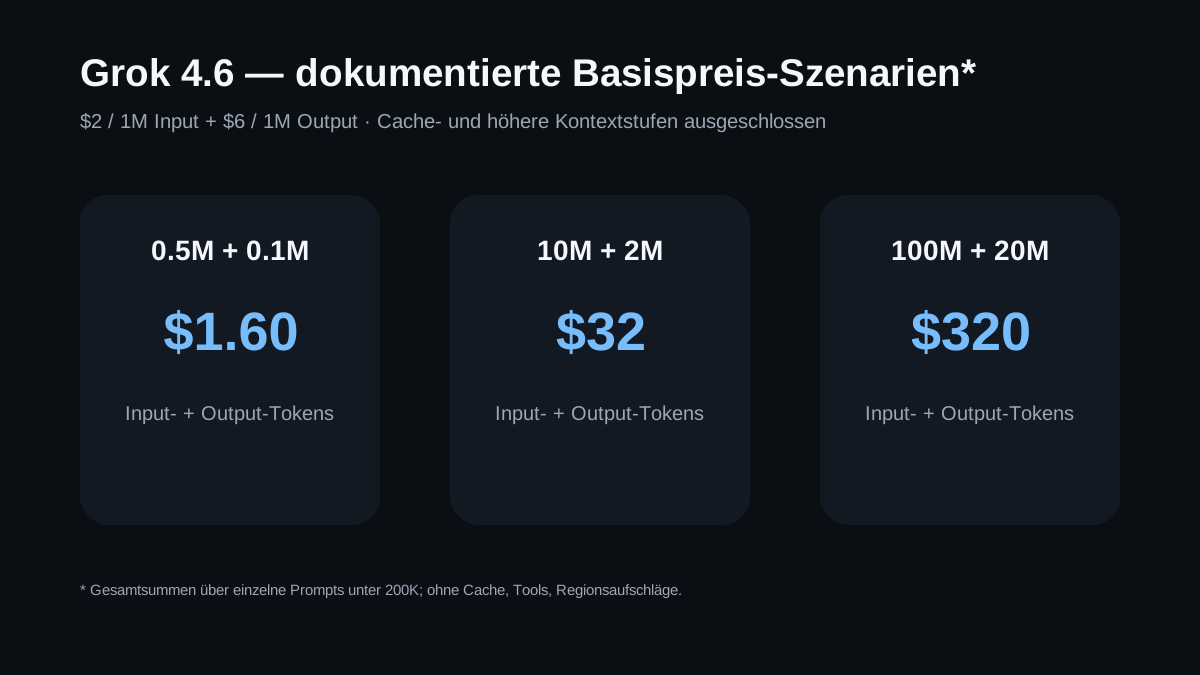
Die aktuelle SpaceXAI-Modellseite nennt für Grok 4.6 $2 pro 1 Mio. Input-Tokens, $0,50 pro 1 Mio. gecachte Input-Tokens und $6 pro 1 Mio. Output-Tokens. Für Prompts über 200.000 Tokens gelten höhere Input-Tarife; die konkrete regionale Tabelle solltest du vor dem produktiven Einsatz prüfen. 12
Für drei aggregierte Nutzungsszenarien ergibt sich bei diesem Listenpreis die folgende theoretische Rechnung. Voraussetzung: Die Tokens verteilen sich auf einzelne Requests mit jeweils weniger als 200.000 Prompt-Tokens. 0,5 oder 100 Millionen Input-Tokens sind hier Monatssummen über viele kurze Requests, keine einzelnen Kontextfenster:
| Szenario | Input | Output | Rechnung | Ergebnis |
|---|---|---|---|---|
| klein | 0,5 Mio. | 0,1 Mio. | 0,5×$2 + 0,1×$6 | $1,60 |
| mittel | 10 Mio. | 2 Mio. | 10×$2 + 2×$6 | $32 |
| intensiv | 100 Mio. | 20 Mio. | 100×$2 + 20×$6 | $320 |
Basispreis, kein garantierter Rechnungsbetrag: Überschreitet ein einzelner Prompt 200.000 Tokens, berechnet xAI den Long-Context-Tarif auf sämtliche Tokens dieses Requests (4 USD Input, 1 USD Cache-Read, 12 USD Output je Million). Die Beispiele oben setzen deshalb kurze Einzelrequests und keine Cache-Hits, Tools, Priority Processing oder Reseller-Aufschläge voraus. US-Regionalendpunkt: https://us.api.x.ai/v1 unterstützt laut xAI-Preistabelle auch grok-4.6 und berechnet 10 % mehr für alle Tokenarten als der globale Endpoint. Das ist kein Nachweis einer EU-Datenresidenz. Für Deutschland kommen gegebenenfalls Steuern und Abrechnungsbedingungen hinzu. 12
Hat Grok 4.6 1,5 oder 2 Billionen Parameter?
Hier ist die Quellenchronologie wichtiger als eine einzelne Zahl.
Ältere Berichte vom 18. bis 27. Juli griffen eine 2T-Erzählung auf. IT之家 und ComputerBase beschrieben Grok 4.6 in dieser Phase als Modell mit ungefähr zwei Billionen Parametern. 910 Kie.ai baute daraus sogar einen ausführlichen „2T“-Erklärartikel auf. 11
Spätere Berichte Ende Juli nennen dagegen 1,5 Billionen Parameter und schreiben diese Angabe Elon Musk zu. EdgeX, The Economic Times und RB.ru beschreiben in diesem späteren Stand verbessertes SFT/RL-Post-Training und stellen einen nachfolgenden Grok 4.7 in Aussicht. 121314
Die saubere Schlussfolgerung ist nicht, dass 1,5T zweifelsfrei die finale Architektur ist. Sie lautet vielmehr: Die öffentlich berichtete Vorab-Spezifikation änderte sich, und eine zugängliche post-launch Model Card, die die finale Parameterzahl eindeutig festlegt, fehlte beim Recherche-Stichtag. Deshalb gehört die Parameterzahl in eine „noch zu bestätigen“-Spalte.
Kontextfenster und Modalitäten: primär dokumentiert
Die aktuelle SpaceXAI-Modellseite nennt für grok-4.6 ein Kontextfenster von 500.000 Tokens, Text- und Bildeingabe, Textausgabe, Function Calling, Structured Outputs und Reasoning. Die Detailseite führt grok-4.6 als Modell-ID und zeigt die Nutzung über die Responses API sowie den OpenAI-kompatiblen Endpunkt. 12
| Merkmal | Grok 4.6 |
|---|---|
| Kontext | 500.000 Tokens offiziell 12 |
| Input/Output | Text + Bild → Text 12 |
| Basispreis | $2/$6; $0,50 gecachter Input 1 |
| Hoher Kontext | höhere Input-Tarife über 200K 1 |
| API-ID | grok-4.6 offiziell 2 |
| Reasoning | low, medium, high, xhigh 2 |
API: Wie Entwickler jetzt prüfen sollten
SpaceXAI dokumentiert die Modell-ID grok-4.6 und zeigt ein direktes API-Beispiel. 12 Für eine Migration solltest du zusätzlich die verfügbare Region, die aktuellen Limits und die gewünschten Tools im eigenen Account prüfen.
Für eine Migration empfiehlt sich deshalb:
- Model-Liste im eigenen SpaceXAI-Account/API-Key abrufen.
- Exakte 4.6-ID und verfügbare Region notieren.
- Einen kleinen A/B-Test gegen 4.5 mit identischem Prompt, Tools und Reasoning-Level fahren.
- Request-Kosten über die dokumentierten Cost-Tracking-Felder messen. 15
- Erst danach produktive Agenten umstellen.
- Context-Compaction, Tool Calling und Structured Outputs separat testen, statt Support nur zu vermuten. 161718
Grok-4.5-Erkenntnisse als Maßstab für den Nachfolger
SpaceXAI positionierte 4.5 klar für Coding und agentische Engineering-Arbeit. Im eigenen Launchmaterial nennt das Unternehmen unter anderem 62,0 % auf DeepSWE 1.0, 53 % auf DeepSWE 1.1, 83,3 % auf Terminal-Bench 2.1 und 64,7 % auf SWE Bench Pro. 5 Diese Werte sind Herstellerangaben beziehungsweise vom Hersteller zusammengetragene Benchmarkdaten und sollten nicht mit einem unabhängigen, identisch reproduzierten 4.6-Vergleich verwechselt werden.
Artificial Analysis bestätigte für 4.5 unabhängig einen deutlichen Sprung gegenüber 4.3 und einen Intelligence-Index-Wert von 54. 619 Wenn die post-launch gemeldete weitere Verbesserung von 4.6 Bestand hat, ist der entscheidende Test nicht „Kann Grok Code schreiben?“, sondern: Wie stabil bleibt es bei langen Agentenläufen, wie viele Tokens verbraucht es pro gelöster Aufgabe und wie oft muss ein Mensch korrigierend eingreifen?
Für wen ist Grok 4.6 besonders interessant?
Coding-Agenten und autonome Workflows
Die Kombination aus berichtetem Frontier-Niveau und niedrigem Listenpreis ist vor allem für agentische Workloads interessant, bei denen Millionen Input-Tokens schnell zusammenkommen. 320 Bei solchen Workflows zählt weit mehr als der reine Tokenpreis: Caching-Effizienz, Wiederholungen, Tool-Fehler, Abbruchraten und die Zahl der benötigten Iterationen können die tatsächlichen Gesamtkosten maßgeblich bestimmen.
Entwickler, die bereits Grok 4.5 nutzen
Hier ist der Wechsel am einfachsten zu evaluieren: identischer Harness, identische Aufgaben, identische Tool-Schemas. Die offizielle xAI-API unterstützt strukturierte Ausgaben und Function Calling; aktuelle Dokumentationsseiten zeigen, wie diese Mechaniken aufgebaut sind. 1617 Ob 4.6 im eigenen Account alle gewünschten Features unterstützt, sollte jedoch explizit über Modell-Liste und Testrequest geprüft werden.
Nutzer auf der Suche nach dem besten Modell
Dafür reicht ein einzelner Intelligence Index nicht. Ein Modell kann in einem aggregierten Benchmark vorn liegen und für den eigenen Workflow trotzdem unpassend, träge oder teuer ausfallen. Ein fundierter Test verlangt Messwerte zu Ergebnisqualität, Latenz, Tokenverbrauch, Tool-Fehlern und Kosten pro gelöster Aufgabe.
Was weiterhin offen bleibt
Die offizielle Doku schließt die wichtigsten Produktfragen, aber nicht jede Evaluationsfrage. Offen beziehungsweise nur eingeschränkt vergleichbar bleiben:
- die finale Parameterzahl;
- ein direkt reproduzierbarer unabhängiger 4.6-Leaderboard-Score;
- die vollständige Methodik hinter dem berichteten Fünf-Punkte-Sprung;
- regionale Preisdetails für lange Kontexte und Drittanbieter-Gateways;
- die Zuverlässigkeit von Tool Calling, Caching und langen Agentenläufen auf der konkreten Mac- oder Provider-Konfiguration.
Diese Punkte sind keine Belege gegen Grok 4.6. Sie markieren die Grenzen der verfügbaren Evidenz und sollten vor einer produktiven Migration mit einem eigenen Testprotokoll geprüft werden.
Fazit: Grok 4.6 ist real, offiziell dokumentiert und seit dem 12. August 2026 verfügbar. Die Primärdoku bestätigt Modell-ID, 500K-Kontext, Modalitäten, Tools und Basispreise; der berichtete Fünf-Punkte-Sprung bleibt eine qualifizierte externe Angabe. 312 Für Mac- und Agenten-Workflows zählt deshalb jetzt ein eigener A/B-Test von Kosten, Latenz, Tool-Fehlern und Ergebnisqualität: Die ungeklärte Parameterzahl tritt dahinter zurück.
Quellen und Einordnung
Modell- und Preisangaben stammen aus xAIs offizieller Dokumentation. Ältere Benchmarkwerte bleiben historische Anbieter- oder Presseangaben, nicht von AI on Mac selbst gemessene Ergebnisse.
Footnotes
Häufig gestellte Fragen
Wann wurde Grok 4.6 veröffentlicht?
Grok 4.6 wurde laut offizieller xAI-Ankündigung am 12. August 2026 veröffentlicht. Die Produktankündigung ist der Primärbeleg.
Wie gut ist Grok 4.6 im Vergleich zu Grok 4.5?
MarketWatch berichtet auf Basis von Artificial Analysis einen Vorsprung von fünf Punkten gegenüber Grok 4.5 im Intelligence Index. Der exakte aktuelle 4.6-Score war aus dem zugänglichen Leaderboard-Snapshot nicht direkt reproduzierbar.
Was kostet Grok 4.6 über die API?
Die offizielle SpaceXAI-Modellseite nennt 2 US-Dollar pro 1 Million Input-Tokens und 6 US-Dollar pro 1 Million Output-Tokens. Gecachte Input-Tokens kosten 0,50 US-Dollar pro Million; für Prompts über 200.000 Tokens gelten höhere Input-Tarife.
Wie groß ist das Kontextfenster von Grok 4.6?
Die offizielle SpaceXAI-Dokumentation nennt für Grok 4.6 ein Kontextfenster von 500.000 Tokens. Das ist das Modellmaximum; Provider, Kostenstufe und Latenz können die praktisch nutzbare Größe begrenzen.
Hat Grok 4.6 1,5 oder 2 Billionen Parameter?
Die Angaben widersprechen sich: Ältere Vorabberichte nennen 2T, spätere Musk-zugeschriebene Berichte 1,5T. Eine zugängliche finale Model Card fehlte beim Stichtag, daher gehört die Parameterzahl in eine „noch zu bestätigen“-Spalte.
Wie lautet die offizielle Grok-4.6-API-Modell-ID?
Die offizielle Modell-ID lautet `grok-4.6`. Die aktuelle Doku zeigt Beispiele für die Responses API und den OpenAI-kompatiblen Endpunkt; im eigenen Account solltest du trotzdem verfügbare Regionen und Limits prüfen.