Neuere DeepSeek-Generation: Dieser Artikel beschreibt DeepSeek V4 Pro 0813. Die neuere V4.1-Generation ist im DeepSeek V4.1 Flash-Guide eingeordnet.
Geprüft am 8. Oktober 2026. Dieser Artikel behandelt den historischen 0813-Checkpoint. Das aktuell preiswertere Flash-Modell ist inzwischen V4.1 Flash, nicht V4 Flash 0731. DeepSeek hat die Verfügbarkeit von V4 Pro nach dem angekündigten 14.-September-Wechsel ausdrücklich verlängert. Offizielles Changelog.
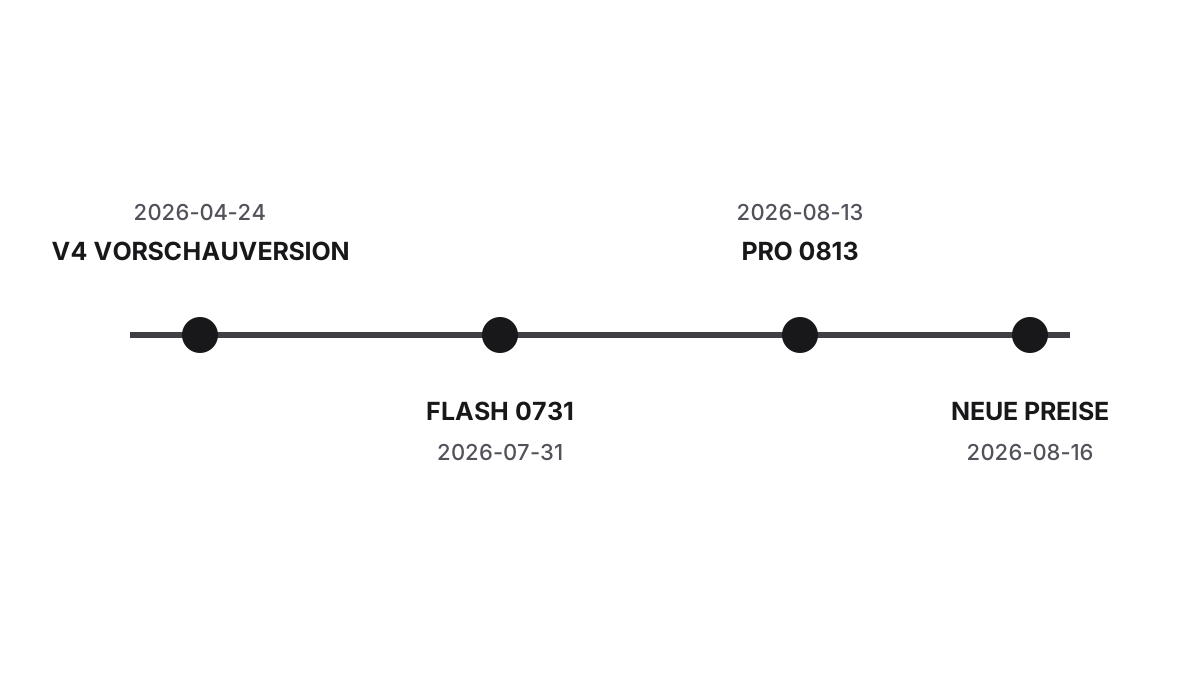
DeepSeek hat DeepSeek-V4-Pro-0813 am 13. August 2026 als GA-Version seines großen V4-Pro-Modells veröffentlicht. Die Eckdaten sind ungewöhnlich: 1,6 Billionen Gesamtparameter, 49 Milliarden aktive Parameter pro Token, ein Kontextfenster von einer Million Tokens und drei Reasoning-Stufen. Für die direkte DeepSeek-API bleibt der Modellname trotzdem schlicht deepseek-v4-pro.
Für Entwickler ist aber nicht die Namensänderung entscheidend. Interessanter ist, was sich seit dem Preview tatsächlich verbessert hat, wie sich Pro gegenüber der aktuellen V4.1-Flash-API wirtschaftlich einordnet und welche Aussagen über lokale Nutzung auf dem Mac realistisch sind.
Die Kernaussage lautet: V4 Pro 0813 ist deutlich stärker bei langen Agent- und Coding-Workflows, aber nicht automatisch die bessere Standardwahl. Der jüngere V4.1-Flash-Nachfolger kostet erheblich weniger; Vergleiche aus August mit Flash 0731 sind hingegen historische Anbieter- beziehungsweise Benchmarkstände und dürfen nicht als heutige Pro-vs.-Flash-Resultate ausgegeben werden. Und obwohl pro Token nur 49 Milliarden Parameter aktiv sind, bleibt V4 Pro wegen seiner insgesamt 1,6 Billionen Gewichte für einen normalen einzelnen Mac kein realistisches lokales Modell.
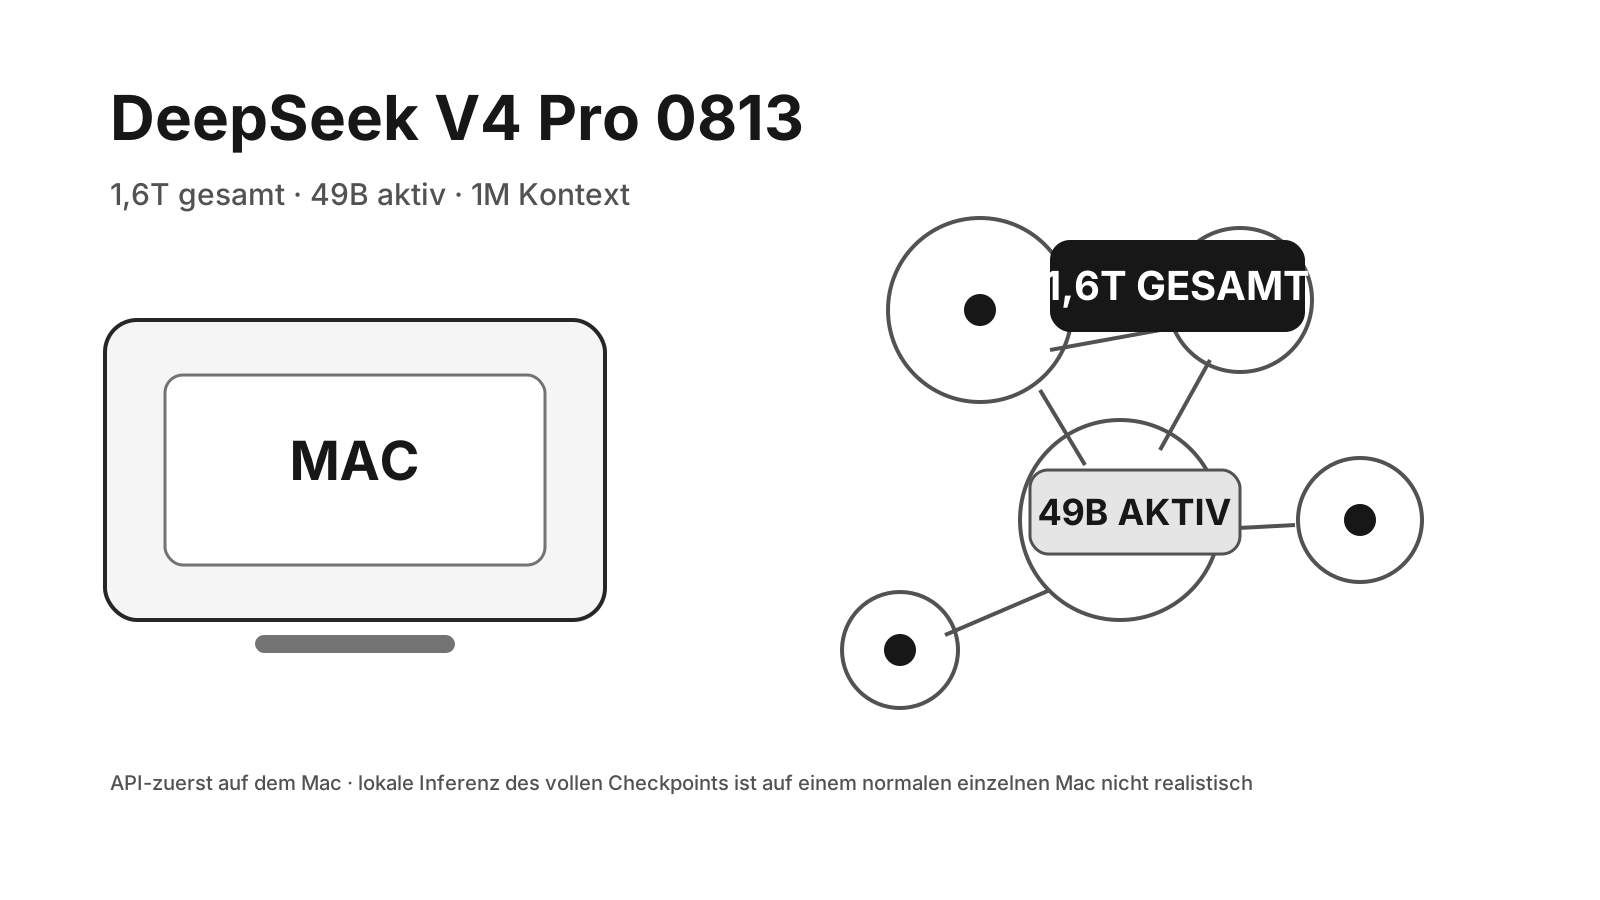
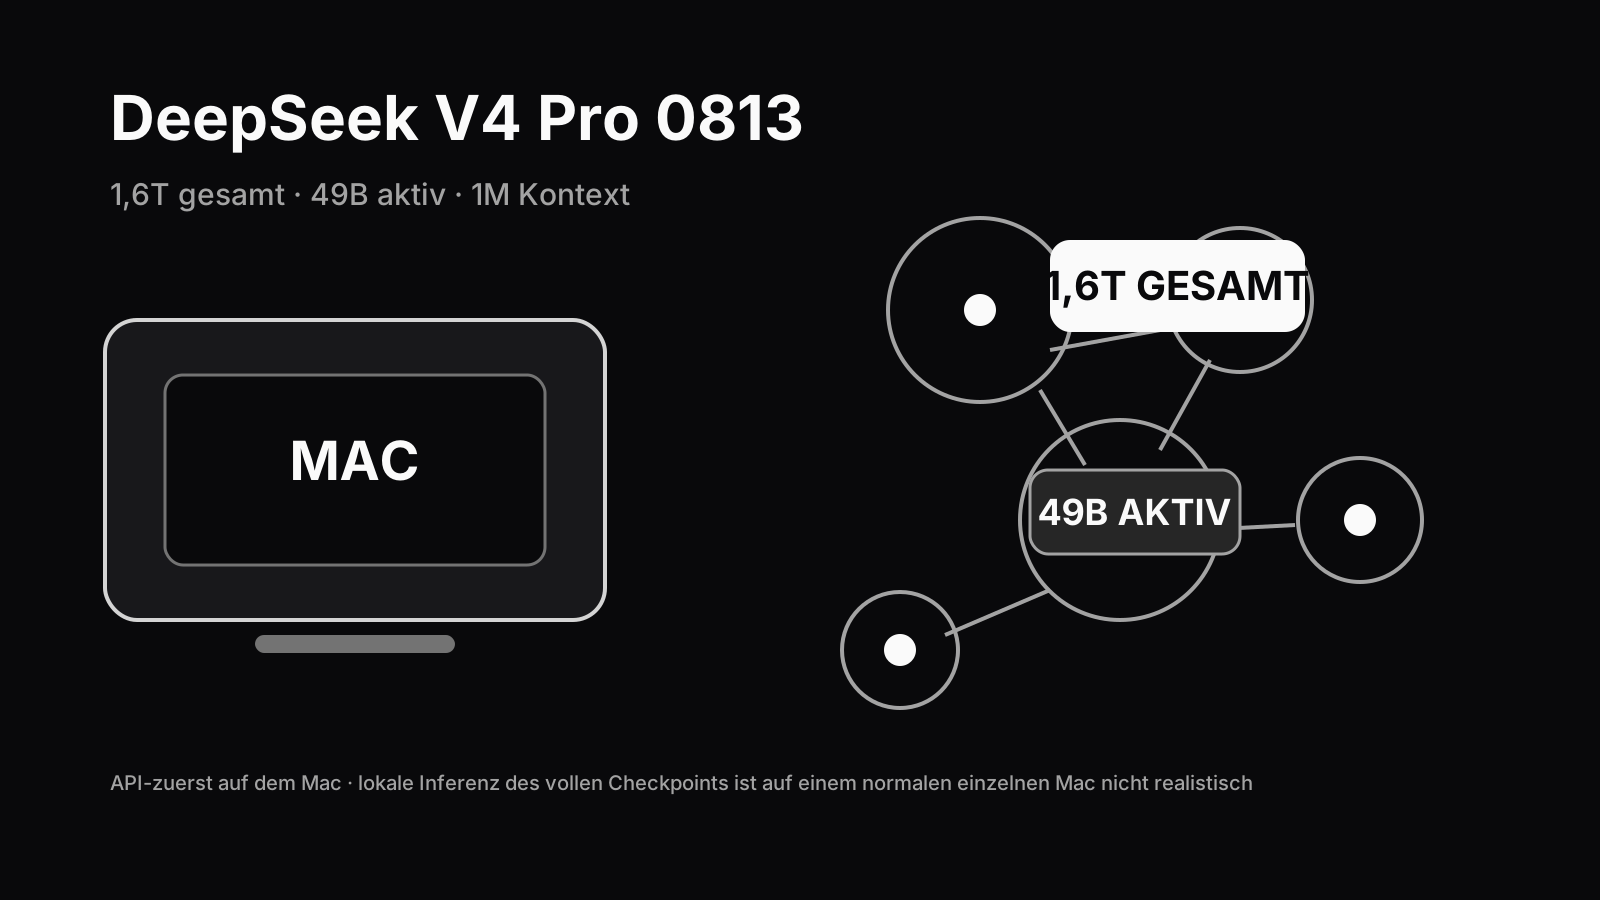
Die wichtigsten Fakten zu DeepSeek V4 Pro 0813
| Merkmal | DeepSeek V4 Pro 0813 |
|---|---|
| Veröffentlichung | 13. August 2026 |
| Direct-API-ID | deepseek-v4-pro |
| Architektur | Mixture of Experts |
| Gesamtparameter | 1,6 Billionen |
| Aktive Parameter pro Token | 49 Milliarden |
| Kontextfenster | 1 Mio. Tokens |
| Maximale API-Ausgabe | 384K Tokens |
| Reasoning | low, high, max |
| Standardmodus | Thinking, high |
| Tool Calls | ja |
| OpenAI-Responses-kompatible API | ja |
| Anthropic-kompatibler Endpoint | ja |
| Lizenz der Gewichte | MIT |
Quellen: DeepSeek GA Release, DeepSeek Models & Pricing, V4 Technical Report, Model Card.
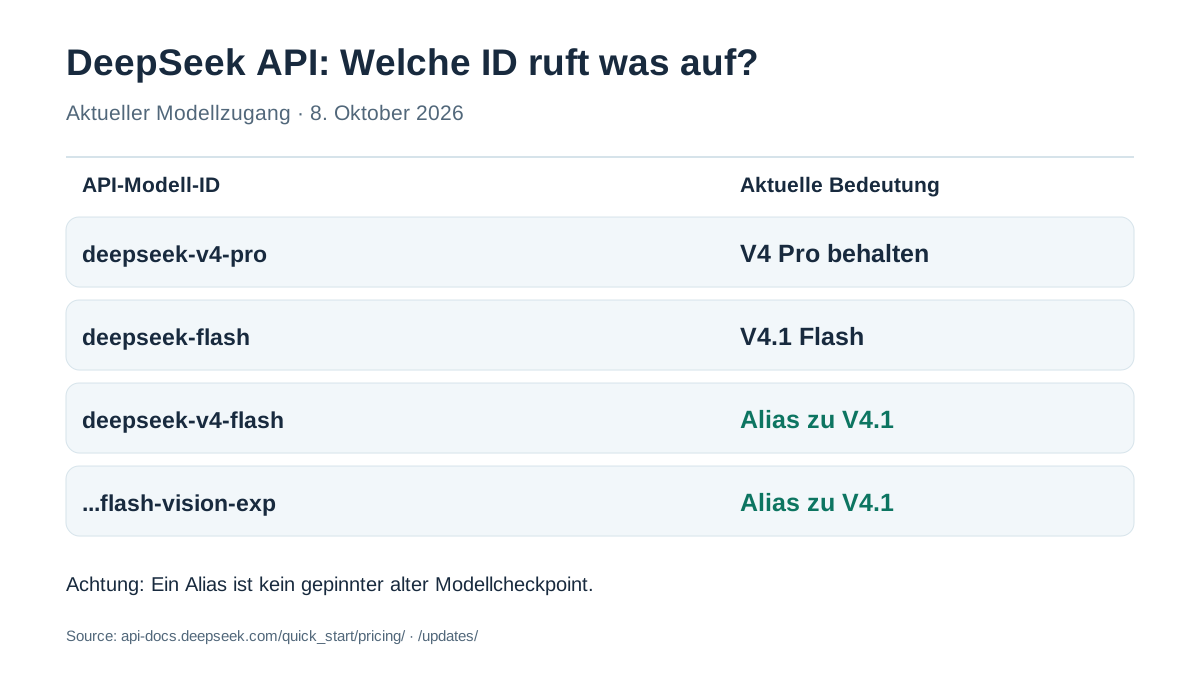
Modellnamen im Oktober: explizit statt Aliase
| API-ID | Aktuelle Bedeutung |
|---|---|
deepseek-v4-pro | V4 Pro, weiterhin als direkter API-Dienst laut Changelog |
deepseek-flash | aktuelle V4.1 Flash |
deepseek-v4-flash | eingestelltes V4 Flash; vorläufiger Alias auf V4.1 Flash |
deepseek-v4-flash-vision-exp | eingestelltes Vision-Exp; vorläufiger Alias auf V4.1 Flash |
Die historischen Benchmarks für V4 Pro 0813 bleiben als historische, modellbezogene Messungen erhalten. Sie sind jedoch kein unabhängiger Direktvergleich mit dem neuen V4.1 Flash unter identischem Harness. DeepSeek-Changelog.
0813 ist die Modellrevision – nicht der API-Name
Die Versionsbezeichnung ist leicht misszuverstehen.
Der veröffentlichte Checkpoint heißt:
DeepSeek-V4-Pro-0813Die direkte DeepSeek-API verwendet dagegen weiterhin:
deepseek-v4-proDas ist praktisch relevant. Wer aus dem Checkpoint-Namen automatisch deepseek-v4-pro-0813 als Direct-API-ID ableitet, orientiert sich nicht an der aktuellen DeepSeek-Dokumentation.
Bei Drittanbietern sieht es anders aus. Cloudflare verwendet beispielsweise:
@cf/deepseek-ai/deepseek-v4-pro-0813OpenRouter wiederum:
deepseek/deepseek-v4-pro-0813Die Modell-ID muss deshalb immer beim jeweiligen Provider geprüft werden.
1,6 Billionen Gesamtparameter – 49 Milliarden aktiv
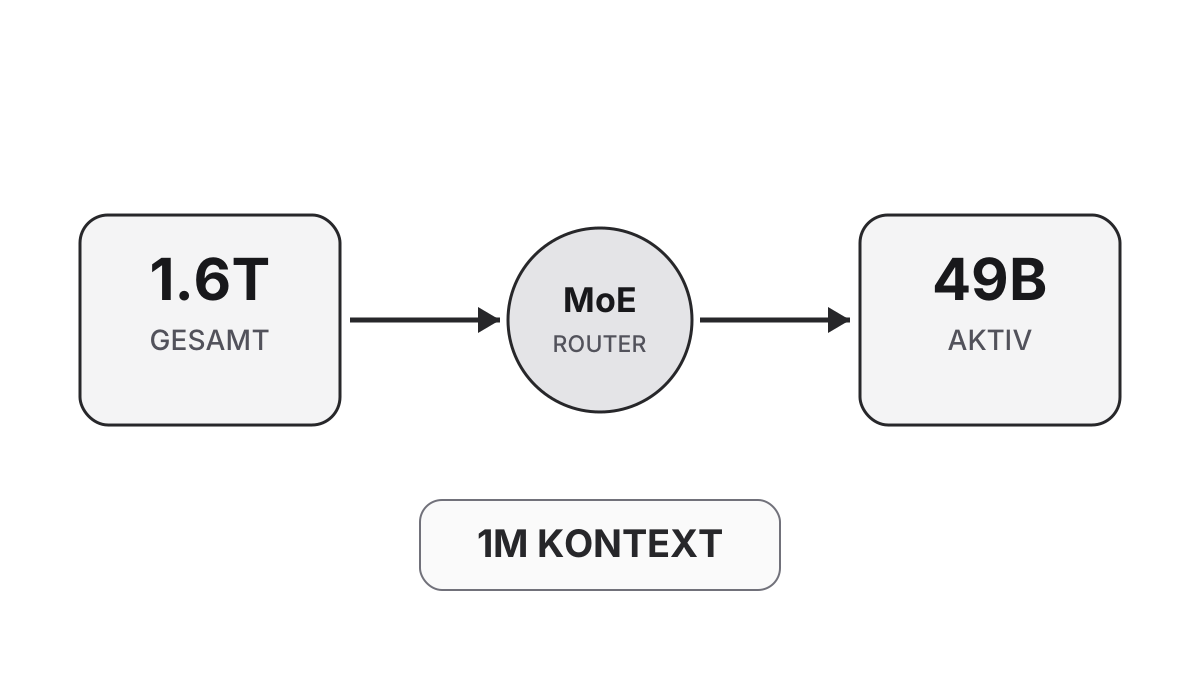
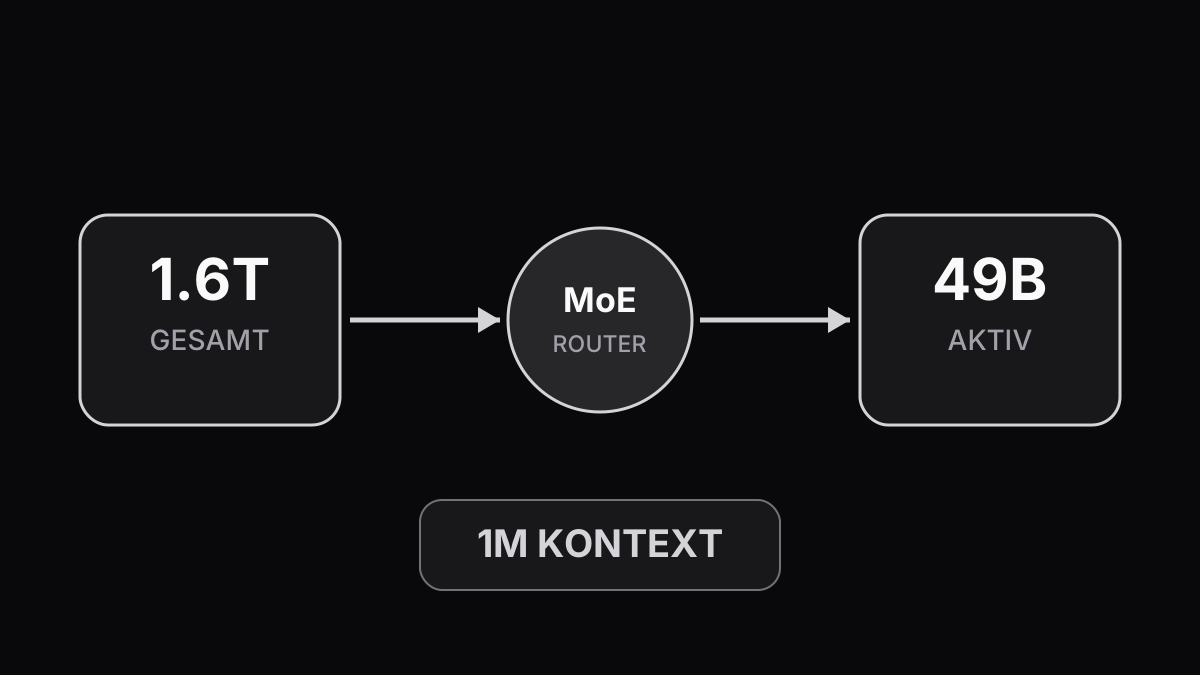
V4 Pro ist ein Mixture-of-Experts-Modell. Nicht alle Gewichte werden für jeden Token gleichzeitig benutzt. Der Router aktiviert nur einen Teil des Netzes; DeepSeek gibt 49 Milliarden aktive Parameter pro Token an.
Das senkt den Rechenaufwand im Vergleich zu einem dichten 1,6-T-Modell erheblich. Es ändert aber nicht die grundlegende Speicherfrage: Die Expertengewichte müssen für vollständige lokale Inferenz trotzdem verfügbar sein.
Genau hier entsteht häufig ein falscher Eindruck. 49B aktiv bedeutet nicht, dass V4 Pro wie ein gewöhnliches 49B-Modell geladen werden kann.
Der Technical Report beschreibt zusätzlich eine für lange Kontexte optimierte Architektur mit Compressed Sparse Attention, Heavily Compressed Attention und weiteren Änderungen. DeepSeek berichtet, dass V4 Pro bei einer Million Kontexttokens gegenüber V3.2 deutlich weniger Inference-FLOPs und KV-Cache benötigt. Das sind Angaben aus dem eigenen Technical Report und keine unabhängigen Mac-Messungen.
Was sich mit 0813 gegenüber dem Preview geändert hat
Die GA-Version ist kein bloßer neuer Dateiname. DeepSeek hat das Agent-Post-Training deutlich weiterentwickelt und DSpark integriert.
DSpark ist ein Mechanismus für spekulatives Decoding. Vereinfacht gesagt versucht das System, mehrere plausible Folgetokens vorzubereiten und anschließend in einem Verifikationsschritt mehrere davon zu akzeptieren. Im DSpark-Paper berichtet DeepSeek bei vergleichbarer Throughput-Auslastung von ungefähr 60 bis 85 Prozent höherer Generationsgeschwindigkeit pro Nutzer gegenüber der älteren MTP-1-Baseline.
Diese Zahl sollte eng ausgelegt werden. Sie beschreibt den dokumentierten Serving-Versuchsaufbau und ist kein allgemeines Versprechen, dass jede V4-Pro-API automatisch 60 bis 85 Prozent schneller antwortet.
Die größten Fortschritte liegen bei Agent- und Coding-Aufgaben
DeepSeeks eigene 0813-Evaluationen zeigen vor allem bei längeren Tool- und Coding-Workflows starke Zugewinne:
| Benchmark | Pro 0813 | Flash 0731 | Pro Preview |
|---|---|---|---|
| HLE mit Tools | 60,0 | 51,5 | 48,2 |
| Terminal-Bench 2.1 | 87,9 | 82,7 | 72,1 |
| NL2Repo | 61,5 | 54,2 | 38,5 |
| CyberGym | 83,3 | 76,7 | 52,7 |
| DeepSWE | 62,7 | 54,4 | 12,8 |
| Toolathlon-Verified | 74,1 | 70,3 | 55,9 |
| AutomationBench Public | 31,8 | 25,1 | 12,8 |
Quelle: DeepSeek V4 Pro 0813 Model Card.
Für die Coding-Agent-Aufgaben nennt DeepSeek unter anderem DeepSeek Harness, max Reasoning, temperature=1.0 und top_p=0.95 als Testbedingungen. Die Werte eignen sich deshalb vor allem für den Vergleich der DeepSeek-Varianten unter ähnlichen Bedingungen. Sie sind kein Ersatz für unabhängige Cross-Model-Tests.
Trotzdem ist das Muster klar: 0813 verbessert genau die Aufgaben, bei denen ein Agent über viele Schritte hinweg konsistent arbeiten muss.
Unabhängige Benchmarks zeichnen ein engeres Bild
Historischer Benchmarkstand vom 18. August 2026: Artificial Analysis meldete damals 53 Punkte für V4 Pro 0813 Max und 52 für V4 Flash 0731 Max. Daraus lässt sich die Leistung von V4.1 Flash im Oktober nicht ableiten.
Das ist wichtig, weil Launch-Berichte noch deutlich größere Abstände nannten. Benchmark-Dashboards ändern sich, wenn neue Läufe oder aktualisierte Auswertungen hinzukommen. Für einen aktuellen Artikel ist deshalb die laufend gepflegte Benchmark-Seite relevanter als ein wenige Tage alter Newswert.
Die praktische Einordnung lautet damit:
- Pro zeigt einen deutlichen Vorsprung bei bestimmten Agent- und Coding-Aufgaben.
- Im allgemeinen Composite-Score ist der Abstand zu Flash klein.
- Wer Flash pauschal als deutlich schwächer behandelt, vereinfacht die Lage zu stark.
Quelle: Artificial Analysis – DeepSeek V4 Pro, Artificial Analysis – DeepSeek V4 Flash.
Direkte DeepSeek-API im Oktober: V4 Pro gegenüber V4.1 Flash
Aktualisiert am 8. Oktober 2026. Der alte Vergleich mit V4 Flash 0731 ist als historische Messung weiterhin interessant, aber keine aktuelle Kaufentscheidung. Seit 10. September 2026 heißt das neue preiswertere Modell DeepSeek V4.1 Flash und wird direkt über deepseek-flash aufgerufen. Die API-Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp sind nur noch vorübergehende Aliase auf V4.1 Flash. DeepSeek hat nach einer zunächst geplanten Umstellung angekündigt, V4 Pro auf Nutzerwunsch weiter anzubieten und dessen Abrechnung unverändert zu lassen. Das ist keine Garantie für einen lebenslangen Pro-Zugang oder jede Drittanbieterroute. DeepSeek-Changelog vom 10. September · Modell- und Preisübersicht.
Die folgenden USD-Listenpreise je Million Tokens gelten für die direkte DeepSeek API, nicht automatisch bei OpenRouter oder anderen Hostern:
| Modell / Tokenklasse | Off-Peak | Peak |
|---|---|---|
| V4 Pro · Cache Hit | 0,022 USD | 0,044 USD |
| V4 Pro · Cache Miss | 0,66 USD | 1,32 USD |
| V4 Pro · Output | 1,98 USD | 3,96 USD |
| V4.1 Flash · Cache Hit | 0,003 USD | 0,006 USD |
| V4.1 Flash · Cache Miss | 0,15 USD | 0,30 USD |
| V4.1 Flash · Output | 0,60 USD | 1,20 USD |


Pro ist bei gleichem Tokenumfang 4,4× so teuer für ungecachten Input, 7,33× für Cache-Hits und 3,3× für Output. Diese Quoten sind keine Qualitätsurteile; ein Modell kann teure Wiederholungen sparen oder zusätzliche Tool-Schritte benötigen.
Peak-Fenster gelten ausschließlich Montag bis Freitag von 01:00–04:00 und 06:00–10:00 UTC. In Deutschland entspricht das am 8. Oktober (MESZ) 03:00–06:00 und 08:00–12:00 Uhr. Nach der Zeitumstellung auf MEZ im Winter sind es 02:00–05:00 und 07:00–11:00 Uhr. An Wochenenden und außerhalb der Fenster gelten Off-Peak-Tarife. DeepSeek Pricing.
Deutschland/EU: US-Dollar-API-Raten sind keine deutschen Euro-Bruttoendpreise. Rechnung, Umsatzsteuer und eventuelle Wechselkurskosten hängen von deinem Vertrags- und Zahlungsmodell ab. API-Betrieb bedeutet, dass Anfragen das lokale Gerät verlassen; auch ein deutschsprachiger Prompt erzwingt keine EU-Datenresidenz. Prüfe bei vertraulichem Code den Anbieter, das DPA, Aufbewahrung und den tatsächlich aktiven Endpunkt.
Was kostet das in der Praxis?
Ein Preis pro Million Tokens ist abstrakt. Drei Beispielrechnungen zeigen besser, wie groß der Unterschied tatsächlich ist.
Leichte Nutzung
Annahme:
- 1 Mio. nicht gecachte Inputtokens
- 2 Mio. Cache-Hit-Tokens
- 0,25 Mio. Outputtokens
Pro Off-Peak
1 × 0,66
+ 2 × 0,022
+ 0,25 × 1,98
= 1,199 USD
Gerundet: $1,20
Peak kostet dieselbe Nutzung $2,40.
Mittlere Nutzung
Annahme:
- 10 Mio. Cache-Miss-Inputtokens
- 10 Mio. Cache-Hit-Tokens
- 3 Mio. Outputtokens
Ergebnis:
- $12,76 Off-Peak
- $25,52 Peak
Intensive Nutzung
Annahme:
- 50 Mio. Cache-Miss-Inputtokens
- 50 Mio. Cache-Hit-Tokens
- 15 Mio. Outputtokens
Ergebnis:
- $63,80 Off-Peak
- $127,60 Peak
Die Rechnungen enthalten keine Steuern, Wechselkurse oder mögliche Provideraufschläge.
Für automatisierbare Batch-Jobs ist die neue Preisstruktur besonders interessant: Wer seine Jobs außerhalb der Peak-Fenster plant, halbiert bei der direkten DeepSeek-API die Tokenkosten.
Provider unterscheiden sich bei Preis und Geschwindigkeit
V4 Pro 0813 wird inzwischen von mehreren Anbietern gehostet, darunter DeepSeek selbst, Baseten, Fireworks, DeepInfra, Novita, Cloudflare und OpenRouter.
Artificial Analysis misst diese Provider getrennt. Solche Werte ändern sich schnell, aber sie zeigen einen wichtigen Punkt: Der günstigste Endpoint ist nicht automatisch der schnellste.
Für produktive Agenten empfiehlt sich ein ganzheitlicher Vergleich relevanter Faktoren neben dem reinen Tokenpreis:
- Time to First Token
- Outputtokens pro Sekunde
- Fehlerrate und Stabilität
- Cache-Abrechnung
- Tool-Calling-Verhalten
- Region und Datenverarbeitung
- providerabhängige Zusatzfunktionen
Aktuelle Providerwerte: Artificial Analysis – V4 Pro Providers.
Unterstützt V4 Pro Bilder? Die Antwort hängt vom Provider ab
Hier widersprechen sich die Dokumentationen.
DeepSeeks eigene Responses-API-Dokumentation sagt ausdrücklich, dass Image- und File-Inputs nicht unterstützt werden. Auch die offizielle Codex-Konfiguration beschreibt den Input als textbasiert.
Cloudflare markiert seine Workers-AI-Version von V4 Pro 0813 dagegen mit Vision: Yes.
Die saubere Schlussfolgerung ist deshalb:
Für die direkte DeepSeek-API sollte V4 Pro 0813 derzeit als textbasiertes Modell behandelt werden. Einzelne Provider können zusätzliche multimodale Serving-Pfade anbieten.
Das ist ein typisches Beispiel dafür, warum sich Eigenschaften eines gehosteten Modells nicht blind von einem Anbieter auf den nächsten übertragen lassen.
Quellen: DeepSeek Responses API, Cloudflare Workers AI.
OpenAI-Responses-kompatibel heißt nicht OpenAI-featurekompatibel
DeepSeek unterstützt eine OpenAI-Responses-kompatible Schnittstelle. Dadurch lässt sich das Modell mit dem OpenAI-SDK ansprechen:
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.responses.create(
    model="deepseek-v4-pro",
    instructions="You are a careful coding assistant.",
    input="Review this function for correctness.",
    reasoning={"effort": "high"},
)

print(response.output_text)
Das erleichtert Migrationen, bedeutet aber keine vollständige Funktionsgleichheit mit OpenAI.
DeepSeek dokumentiert mehrere nicht unterstützte Responses-Funktionen, darunter unter anderem:
backgroundstoreconversationprevious_response_idfile_searchcode_interpretercomputer_use- allgemeine MCP-Tools
Einige nicht unterstützte Parameter können still ignoriert werden. Wer bestehende Agenten umstellt, sollte deshalb über reine Syntaxprüfungen hinaus kontrollieren, ob die tatsächlich benötigten Features semantisch vorhanden sind.
Quelle: DeepSeek Responses API.
Claude Code und Anthropic-kompatibler Endpoint
DeepSeek bietet zusätzlich einen Anthropic-kompatiblen Endpoint unter:
https://api.deepseek.com/anthropicDie dokumentierte Modellzuordnung ist interessant:
claude-opus*→deepseek-v4-proclaude-sonnet*→ V4 Flashclaude-haiku*→ V4 Flash
Damit lässt sich V4 Pro in Workflows einsetzen, die für die Anthropic-API gebaut wurden, ohne jede Integration von Grund auf neu zu schreiben.
Auch hier gilt: Kompatible API-Oberfläche bedeutet nicht automatisch vollständige Verhaltensgleichheit.
Quelle: DeepSeek Anthropic API.
Kann DeepSeek V4 Pro 0813 lokal auf einem Mac laufen?
Für einen normalen einzelnen Mac lautet die praktische Antwort: nein.
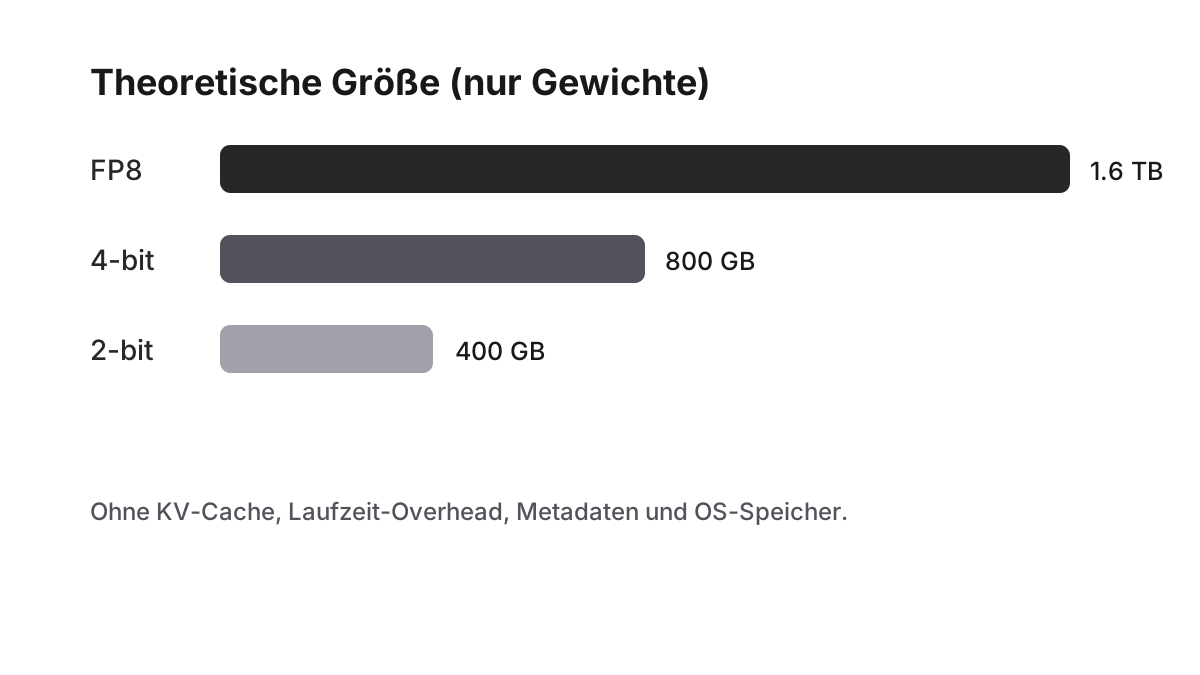
Die entscheidende Größe sind nicht die 49 Milliarden aktiven Parameter, sondern die 1,6 Billionen Gesamtgewichte.
Theoretische Untergrenze für die Gewichte
Eigene Rechnung:
| Darstellung | theoretischer reiner Gewichtsbedarf |
|---|---|
| FP16/BF16 | ~3,2 TB |
| FP8 | ~1,6 TB |
| 4 Bit | ~800 GB |
| 2 Bit | ~400 GB |
Berechnung:
1,6 Billionen Parameter × Bits pro Parameter ÷ 8Das ist nur der theoretische Speicher für die Gewichte. Nicht enthalten sind unter anderem:
- Quantisierungsmetadaten
- KV-Cache
- Runtime-Overhead
- temporäre Tensoren
- Betriebssystem
- andere laufende Anwendungen
Selbst eine aggressive 4-Bit-Rechnung landet damit bei ungefähr 800 GB, bevor der eigentliche Arbeitsbedarf berücksichtigt ist.
MoE-Sparsity reduziert die Rechenmenge pro Token. Sie macht aus 1,6 Billionen Gewichten aber kein 49B-Dateipaket.
DeepSeeks eigene vLLM-Anleitung demonstriert V4 Pro 0813 auf einem 4×GB300-Knoten. Das beschreibt die Zielklasse der Hardware deutlich besser als ein einzelner Consumer-Mac.
Quelle: DeepSeek V4 Pro 0813 Model Card.
Und was ist mit Ollama?
Ollama führt V4 Pro 0813 unter anderem als:
ollama run deepseek-v4-pro:0813-cloudDer entscheidende Teil ist cloud.
Dieses Angebot zeigt nicht, dass Ollama die vollständigen 1,6-T-Gewichte lokal in Apple Unified Memory lädt. Es ist ein Cloud-Modell.
Quelle: Ollama – DeepSeek V4 Pro 0813 Cloud.
Für echte lokale Nutzung auf Apple Silicon bleiben wesentlich kleinere Modelle die sinnvollere Klasse. Dabei sollten Modellgröße, Quantisierung, gewünschter Kontext und verfügbarer Unified Memory gemeinsam betrachtet werden.
Pro oder Flash: Welche Variante ist sinnvoller?
Die Wahl lässt sich besser über den Arbeitsablauf als über eine einzelne Benchmarkzahl treffen.
V4.1 Flash ist die bessere erste Wahl, wenn
- der Tokenpreis wichtig ist,
- sehr viele Routine-Schritte anfallen,
- niedrige Latenz wichtiger als maximale Agententiefe ist,
- die meisten Aufgaben zuverlässig in wenigen Tool-Schritten gelöst werden,
- ein Scheitern einzelner Runs wenig kostet.
Pro 0813 ist sinnvoller, wenn
- ein Agent große Repositories bearbeitet,
- viele Tool-Schritte voneinander abhängen,
- lange Aufgaben bei einem Fehler teuer neu gestartet werden müssten,
- Terminal-, Repo- oder Automation-Aufgaben im Mittelpunkt stehen,
- maximale Reasoning-Tiefe wichtiger ist als Tokenkosten.
Für Agentensysteme bietet sich deshalb eine gestufte Strategie an:
Flash für Routinepfade, Pro für schwierige Eskalationen.
Das ist oft sinnvoller, als jede Anfrage pauschal an das teuerste Modell zu schicken.
Fazit: Historischer Pro-Checkpoint, aktueller V4.1-Flash-Vergleich
DeepSeek V4 Pro 0813 ist gegenüber dem Preview vor allem dort stärker geworden, wo moderne Agenten tatsächlich scheitern: bei langen Coding-Aufgaben, Tool-Ketten, Terminalarbeit und mehrstufiger Automation.
Trotzdem ist Pro nicht automatisch die wirtschaftlich beste Default-Wahl. Bei der direkten API kostet Pro gegenüber dem aktuellen V4.1 Flash 4,4× ungecachten Input, 7,33× Cache-Hits und 3,3× Output. Die früher zitierten Benchmarkvergleiche betrafen Flash 0731, nicht V4.1 Flash.
Für Mac-Nutzer ist die Lage noch klarer. V4 Pro ist interessant als API-Modell, nicht als realistisches lokales 49B-Modell. Die 49 Milliarden aktiven Parameter sagen etwas über die Rechenmenge pro Token aus; die lokale Speicherfrage wird weiterhin von den insgesamt 1,6 Billionen Gewichten bestimmt.
Wer einen Agenten auf Kosten und Qualität optimieren will, fährt deshalb derzeit am besten mit einer einfachen Regel:
V4.1 Flash zuerst testen. V4 Pro gezielt gegenprüfen, falls ein reproduzierbarer Workflow bei dir damit weniger Fehlversuche verursacht.
Häufig gestellte Fragen
Ist DeepSeek V4 Pro 0813 lokal auf einem Mac lauffähig?
Für einen normalen einzelnen Mac: nein. Entscheidend sind die 1,6 Billionen Gesamtgewichte, nicht die 49 Milliarden aktiven Parameter. Selbst eine aggressive 4-Bit-Rechnung landet bei etwa 800 GB, bevor Laufzeit-Overhead und KV-Cache berücksichtigt sind. DeepSeek selbst demonstriert V4 Pro auf einem 4×GB300-Knoten.
Wie viel teurer ist V4 Pro im Vergleich zu Flash?
Gegenüber dem neuen V4.1 Flash kostet V4 Pro bei den direkten API-Listenpreisen 4,4× für ungecachten Input, 7,33× für Cache-Hits und 3,3× für Output. Peak-Preise sind jeweils doppelt so hoch wie Off-Peak.
Was ist der Unterschied zwischen deepseek-v4-pro und DeepSeek-V4-Pro-0813?
DeepSeek-V4-Pro-0813 ist der veröffentlichte Checkpoint. Die direkte DeepSeek-API verwendet weiterhin die kürzere ID deepseek-v4-pro. Drittanbieter wie Cloudflare oder OpenRouter verwenden eigene IDs – diese müssen je Provider geprüft werden.
Was bedeutet „49 Milliarden aktive Parameter"?
V4 Pro ist ein Mixture-of-Experts-Modell. Pro Token werden nur 49 Milliarden der 1,6 Billionen Gewichte aktiviert. Das senkt die Rechenmenge, macht aus dem Modell aber kein 49B-lokales Modell – die vollen Gewichte müssen für lokale Inferenz verfügbar sein.
Unterstützt V4 Pro Bilder?
Das hängt vom Provider ab. DeepSeeks eigene Responses-API dokumentiert Bild- und Dateieingaben ausdrücklich als nicht unterstützt; Cloudflare markiert seine Workers-AI-Version dagegen mit Vision: Yes. Die direkte DeepSeek-API sollte vorerst als textbasiert behandelt werden.
Wann sollte man Pro statt Flash nutzen?
Flash ist die bessere Standardwahl für Routinepfade, niedrige Latenz und viele einfache Schritte. Pro lohnt sich für große Repositories, abhängige Tool-Ketten und lange Aufgaben, bei denen ein Fehlschlag teuer neu gestartet werden müsste. Eine gestufte Strategie – Flash als Standard, Pro für schwere Eskalationen – ist meist effizienter.
Warum verwenden alte DeepSeek-Flash-IDs jetzt V4.1 Flash?
DeepSeek hat die früheren V4 Flash und V4 Flash Vision Exp eingestellt und leitet diese Aliase vorübergehend auf V4.1 Flash. Für neue Integrationen sollte der direkte API-Name deepseek-flash gewählt werden. DeepSeek V4 Pro bleibt laut offiziellem Changelog separat als API-Dienst verfügbar.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- api-docs.deepseek.com news / news260813
- api-docs.deepseek.com quick_start / pricing
- api-docs.deepseek.com guides / thinking_mode
- api-docs.deepseek.com guides / responses_api
- api-docs.deepseek.com guides / anthropic_api
- api-docs.deepseek.com agent_integrations / codex
- huggingface.co main / README.md
- arxiv.org abs / 2606.19348
- arxiv.org abs / 2607.05147
- artificialanalysis.ai models / deepseek-v4-pro
- artificialanalysis.ai models / deepseek-v4-flash
- artificialanalysis.ai deepseek-v4-pro / providers
- developers.cloudflare.com models / deepseek-v4-pro-0813
- ollama.com library / deepseek-v4-pro:0813-cloud
- reuters.com china / deepseek-releases-official-v4-pro-model-it-steps-up-expansion-2026-08-13