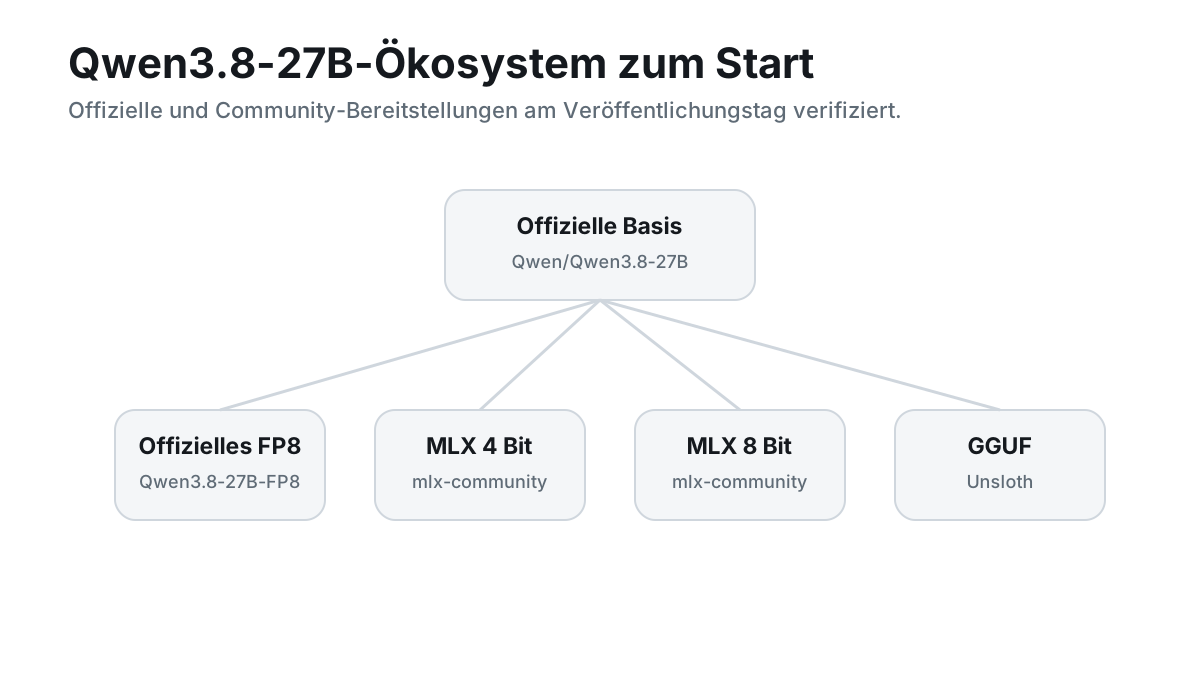
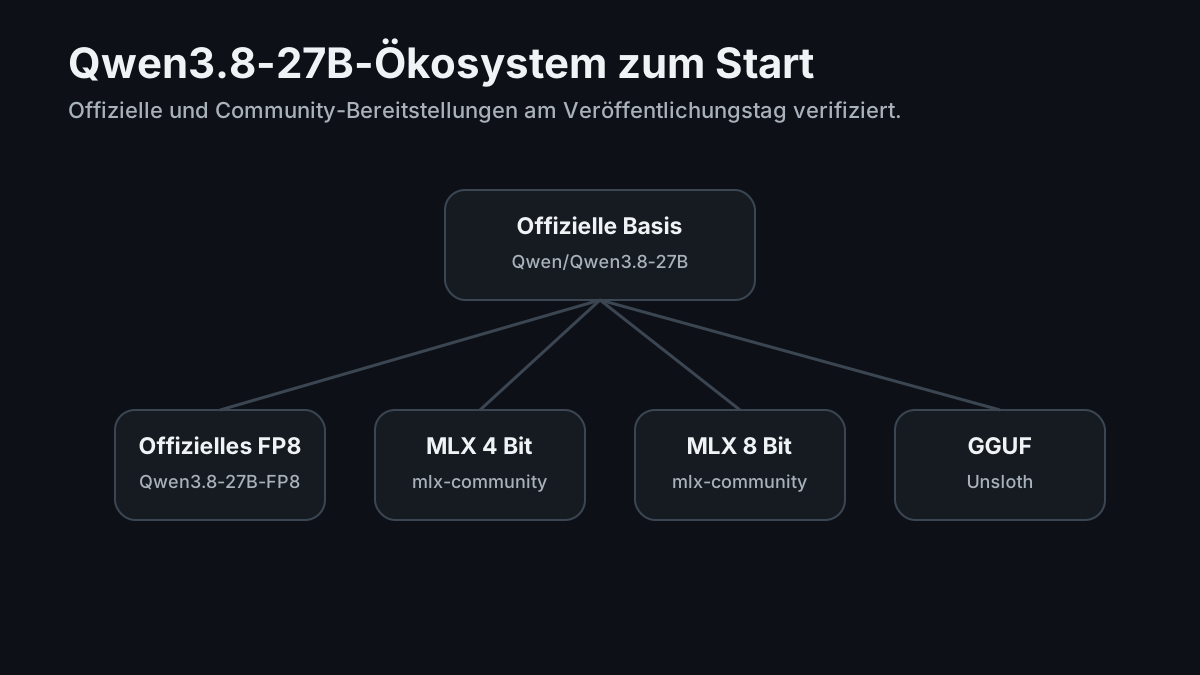
Stand: 13. Oktober 2026; Veröffentlichung am 14. August. Qwen/Qwen3.8-27B ist als offizieller, herunterladbarer Checkpoint auf Hugging Face verfügbar. Die Repo-Metadaten nennen Qwen als Autor, 27.781,4 Millionen Parameter, image-text-to-text, die Architekturkennung qwen3_5 und Apache 2.0. Gleichzeitig sind bereits eine offizielle FP8-Version sowie 4-Bit-, 8-Bit- und BF16-Konvertierungen für MLX und ein GGUF-Paket erschienen. 123456
Die offizielle Model Card enthält inzwischen eine eigene Benchmark-Tabelle und nennt 262.144 Tokens als natives Kontextlimit; eine Erweiterung bis 1.000.000 Tokens wird über RoPE/YaRN-Konfiguration beschrieben. Diese Werte gehören zum herunterladbaren Checkpoint. Die 1M-Angabe des gehosteten Qwen3.8-Angebots ist dagegen eine andere Bereitstellungsoberfläche. Unabhängige Qwen3.8-27B-Mac-Benchmarks und reproduzierbare Laufzeitvergleiche bleiben offen. 178910
Aktueller Stand
Die wichtigsten dokumentierten Eigenschaften mit Quellen:
| Frage | Veröffentlichter Stand, geprüft bis 08.10.2026 |
|---|---|
| Gibt es Qwen3.8-27B wirklich? | Ja. Offizieller Qwen-Checkpoint. 1 |
| Parameter | 27.781,4 Mio. laut Repo-Metadaten. 1 |
| Open Weight | Ja. |
| Lizenz | Apache 2.0. 12 |
| Multimodal | Ja, als image-text-to-text gekennzeichnet. 1 |
| Offizielle FP8-Version | Ja. 2 |
| MLX für Apple Silicon | Ja: 4 Bit, 8 Bit und BF16 sind bereits vorhanden. 345 |
| GGUF | Ja, Unsloth hat bereits ein Paket veröffentlicht. 6 |
| Offizielle Benchmark-Tabelle | Ja, in der Model Card; unabhängige Reproduktion offen. |
| Kontext | 262.144 nativ; bis 1.000.000 mit dokumentierter Erweiterung. |
| oMLX-Kompatibilität | Wahrscheinlich, aber noch direkt zu testen. Die Architekturkennung und MLX-Konvertierungen sprechen dafür; eine Qwen3.8-spezifische oMLX-Freigabe war bei der Prüfung noch nicht indexiert. 1345111213141516171819 |
Qwen3.8-27B ist nicht Qwen3.8-Max-Preview
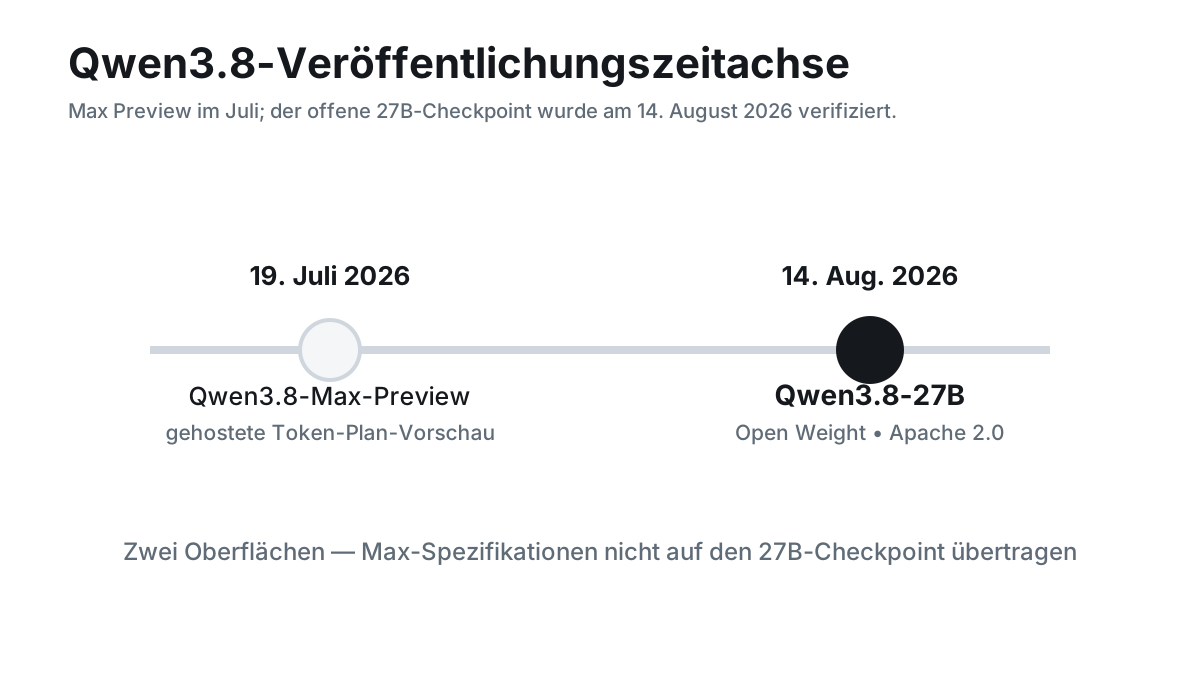
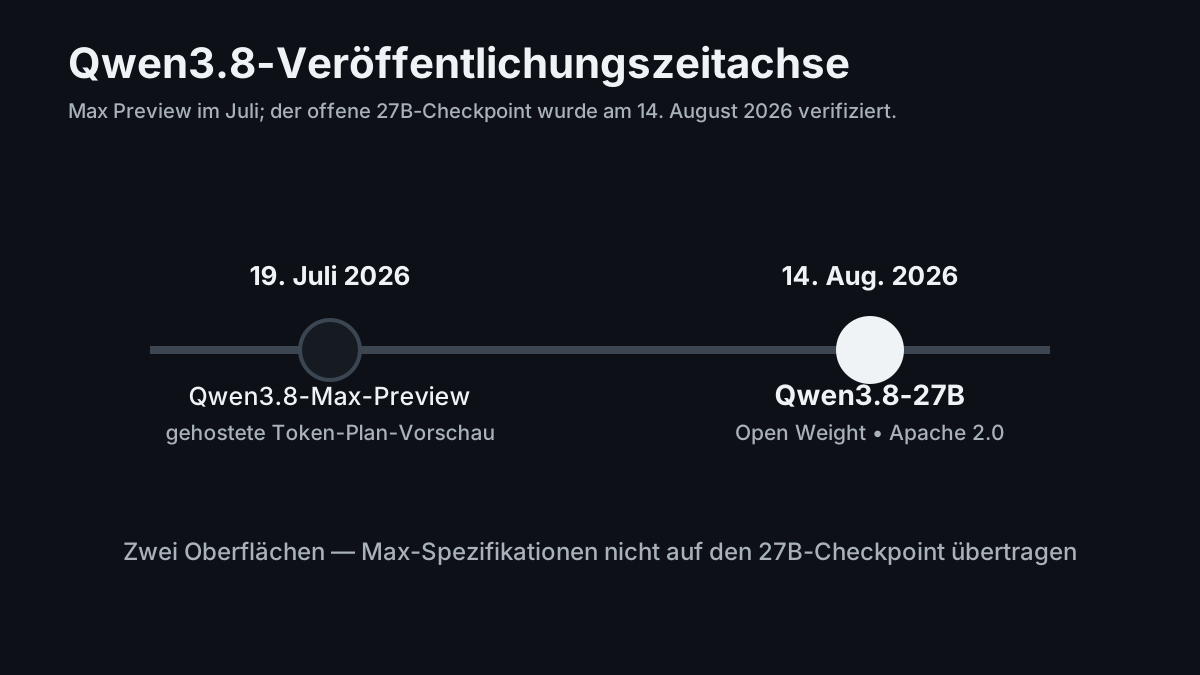
Das ist die erste Verwechslungsgefahr des Releases. Alibaba hatte am 19. Juli 2026 qwen3.8-max-preview als gehostetes Modell im Token Plan eingeführt. Der Dienst wurde als Qwen3.8-Flaggschiff mit sehr großer Modellskala beworben und ist in QwenCloud mit 1 Million Tokens Kontext gelistet. 789
Qwen3.8-27B ist ein anderer Artefakt-Typ: ein herunterladbarer 27B-Checkpoint mit Apache-2.0-Lizenz. Die Kontextlänge oder Benchmarks des Max Preview dürfen daher nicht einfach auf die 27B-Version übertragen werden.
Diese Trennung ist für lokale Nutzer entscheidend: Das Max Preview ist ein Cloud-Service; Qwen3.8-27B kann dagegen selbst gehostet, quantisiert und über lokale Inferenzserver bereitgestellt werden. 123456
Was ist gegenüber Qwen3.6-27B bereits sicher anders?
Auf Metadatenebene ist die Kontinuität auffällig. Qwen3.6-27B und Qwen3.8-27B werden beide mit rund 27,78 Milliarden Parametern und der Architekturkennung qwen3_5 geführt. 120 Das bedeutet aber nicht, dass beide Modelle identisch sind. Ein neuer Checkpoint kann Training, Datenmischung, Alignment, Tool-Use-Verhalten und Gewichte stark verändern, obwohl die Grundarchitektur gleich bleibt.
Offizielle Qwen3.8-27B-Resultate sind jetzt in der Model Card sichtbar, aber sie sind vom Anbieter berichtet und kein Ersatz für unabhängige Mac-Läufe. Genau deshalb wäre es unseriös, die bekannten Qwen3.6-27B-Werte – etwa aus SWE-bench oder Terminal-Bench – als Ersatz für Qwen3.8-Resultate zu verwenden. Frühere Reproduktionsberichte belegen, wie stark der Agent-Harness ein Resultat verschieben kann. Bei Qwen3.6-27B änderten etwa Dateieditierwerkzeuge und Testbedingungen die beobachtete SWE-bench-Pro-Leistung massiv. 2122
Wie viel Speicher braucht Qwen3.8-27B auf einem Mac?
Für einen ersten Hardware-Check kann man aus der offiziellen Parameterzahl eine theoretische Untergrenze für die reinen Gewichte berechnen.
Formel:
Speicher ≈ Parameter × Bits pro Gewicht ÷ 8
Bei 27,7814 Milliarden Parametern ergibt das:
| Präzision | Reine Gewichtsdaten, theoretisch | Praxis |
|---|---|---|
| BF16 / 16 Bit | ≈ 55,6 GB | plus Runtime, KV-Cache, Aktivierungen und macOS |
| FP8 / 8 Bit | ≈ 27,8 GB | plus Overhead |
| 8-Bit-Quantisierung | ≈ 27,8 GB | ähnlich als grobe Gewichtsschranke |
| 4-Bit-Quantisierung | ≈ 13,9 GB | plus Quantisierungsmetadaten und Runtime |
Das sind berechnete Schätzwerte, keine gemessenen RAM-Werte. Die echte Unified-Memory-Nutzung hängt unter anderem von Quantisierung, Vision-Komponenten, KV-Cache, Kontextlänge, Batchgröße und Runtime ab.
Wichtiger Abgleich mit einem echten Download: Das MLX-Community-Repository der 4-Bit-Konvertierung weist aktuell rund 16,1 GB Modell- und Begleitdateien aus. Das ist mehr als die theoretische Rohgewichtszahl von 13,9 GB, aber wiederum keine Messung der RAM-Belegung. Speicherbedarf bei geladenem Modell, Kontext und Bildverarbeitung muss auf dem eigenen Mac geprüft werden.


Grobe Mac-Einordnung
- 16 GB Unified Memory: 4 Bit liegt schon zu nah an der theoretischen Gewichtsschranke. Für einen stabilen Agentenbetrieb ist das kein attraktives Ziel.
- 24 GB: 4 Bit ist wesentlich realistischer, aber lange Kontexte und parallele Agenten können den Spielraum schnell auffressen.
- 32 GB: 4 Bit ist die naheliegende Startklasse. Für 8 Bit sind die reinen Gewichte bereits so groß, dass wenig Reserve bleibt.
- 48 GB: 4 Bit bietet viel Headroom; 8 Bit wird deutlich plausibler.
- 64 GB: 8 Bit ist hardwareseitig wesentlich entspannter. BF16 liegt mit rund 55,6 GB reinen Gewichten dagegen immer noch gefährlich nah am gesamten Speicher.
- 96 GB oder mehr: BF16 wird technisch realistischer, ist für normale lokale Nutzung aber meist unnötig teuer.
Diese Einordnung ist absichtlich konservativ. Ein Modell, das gerade eben „lädt“, ist nicht automatisch ein gutes Agenten-Setup.
Welche MLX-Version sollte man zuerst probieren?
Die MLX-Community bietet mlx-community/Qwen3.8-27B-4bit, -8bit und -bf16; für einen ersten Mac-Test ist 4 Bit meist die sinnvollste Speicherklasse. 345
Für die meisten Apple-Silicon-Nutzer ist 4 Bit der sinnvollste erste Test: Es reduziert den Gewichtsspeicher theoretisch auf ungefähr 13,9 GB und lässt mehr Unified Memory für KV-Cache, Tools, Browser, Python-Prozesse und den Agent-Harness übrig.
8 Bit ist interessanter, wenn genügend RAM vorhanden ist und du gezielt prüfen willst, ob die höhere Präzision bei deinen Aufgaben einen messbaren Vorteil bringt. Ein pauschales „8 Bit ist deutlich intelligenter“ wäre ohne Qwen3.8-spezifische Vergleichstests nicht belegt.
Und oMLX?
oMLX ist für diesen Release besonders relevant, weil es Qwen3.5-/Qwen3.6-Modelle auf Apple Silicon bereits intensiv unterstützt und auf Agent-Workloads mit Continuous Batching und SSD-Cache zielt. 111213141516171819
Der neue Checkpoint trägt wieder die Architekturkennung qwen3_5, und MLX-Konvertierungen existieren bereits. Das sind gute Kompatibilitätssignale, aber noch kein Beweis, dass alle Pfade heute fehlerfrei funktionieren.
Auf dem Vorgänger gab es in oMLX unter anderem versionsabhängige Themen bei Vision-Fallbacks, Thinking-Parametern, MTP, Quantisierung und Long-Context-Performance. 1516171819 Deshalb sollte ein sauberer Qwen3.8-27B-Test mindestens fünf Dinge separat prüfen:
- Text-Inferenz über
/v1/chat/completions - Tool Calling über mehrere aufeinanderfolgende Calls
- Vision-Eingabe, falls benötigt
- Kontextwachstum und Speicherverbrauch
- MTP/DFlash nur dann, wenn für Qwen3.8 explizit unterstützt
Nicht einfach die Qwen3.6-DFlash-Konfiguration übernehmen. oMLX dokumentiert für DFlash konkrete Draft-Checkpoints pro Zielmodell; ein Qwen3.8-Draft-Checkpoint ist in der geprüften Dokumentation noch nicht bestätigt. 13


Ist Qwen3.8-27B schon besser als Qwen3.6-27B?
Die offiziellen Model-Card-Zahlen beantworten das nicht zuverlässig für lokale Mac-Agenten. Dafür fehlen unabhängige Vergleichstests unter identischen Bedingungen.
Belegt: Qwen hat einen neuen 27B-Checkpoint veröffentlicht, er besitzt dieselbe grobe Parameterklasse und Architekturkennung wie Qwen3.6-27B, und die Infrastruktur rund um FP8, MLX und GGUF ist sofort angelaufen. 12345620
Noch offen: wie sich die offiziellen Model-Card-Werte unter unabhängigen, identischen Bedingungen reproduzieren lassen und ob der neue Checkpoint auf lokalen Macs bei Coding, Tool Use, langem Kontext, Vision, Schreiben, Faktenstabilität oder Agentenrobustheit tatsächlich besser ist – und um wie viel.
Ein sinnvoller Vergleich sollte deshalb identische Bedingungen verwenden:
- identische Quantisierungsklasse,
- identischer Systemprompt,
- identischer Agent-Harness,
- identische Tool-Schemas,
- identisches Kontextbudget,
- identische Testaufgaben,
- gleiche Temperatur/Sampling-Regeln,
- mehrere Wiederholungen bei stochastischen Tests.
Gerade bei Agenten ist der Harness kein Detail. Die Qwen3.6-Reproduktionsberichte zeigen, dass Werkzeuge und Testlogik den Endscore stark verändern können. 212322
So unterscheidest du Modelldatei und echte Mac-Leistung
Die offizielle Qwen-Modellkarte und die MLX-4-Bit-Konvertierung belegen die Existenz der Gewichte – nicht eine bestimmte Tokens/s-Leistung deines Macs. Prüfe vor einer Kaufempfehlung den tatsächlichen Speicherpeak in der Aktivitätsanzeige, Modellrevision und Quantisierung, MLX-Version, Kontextfenster und die Qualität einer wiederholten Aufgabe. Benchmarkwerte verschiedener Modelle dürfen nur bei identischen Hardware- und Kontextbedingungen als direkter Vergleich bezeichnet werden.
Welche Messungen noch fehlen
Für einen Mac-orientierten Test sind vier Kennzahlen zusätzlich zur offiziellen Model-Card-Tabelle wertvoller als eine einzelne, nicht reproduzierte Leaderboard-Zahl:
1. Decode-Geschwindigkeit
Tokens pro Sekunde bei 4 Bit und 8 Bit auf derselben Apple-Silicon-Hardware.
2. Prefill bei realistischen Kontextgrößen
Mehrere Kontextstufen wie 8K, 32K und 64K statt ausschließlich 1K. oMLX-Vorgängerberichte zeigen, dass Runtime-Versionen Long-Context-Prefill deutlich beeinflussen können. 16
3. Peak Unified Memory
Gewichte allein reichen nicht. Entscheidend ist, wie viel Speicher ein echter Agentenlauf inklusive KV-Cache und Tools verbraucht.
4. Agenten-Zuverlässigkeit
Eine kleine, reproduzierbare Suite mit Dateibearbeitung, Shell, Recherche, JSON-Tool-Calls und mehrstufigen Aufgaben wäre aussagekräftiger als ein beliebiges Chat-Beispiel.
Reproduzierbarer 4-Bit-MLX-Test auf dem Mac
Quellenstand 13. Oktober 2026: Der offizielle Qwen3.8-27B-Checkpoint und die 4-Bit-Konvertierung der MLX-Community sind verfügbar. Die Modellkarte nennt Apache 2.0, Bild- und Texteingabe, die Architekturkennung qwen3_5 und 262.144 native Kontext-Tokens. Das ist eine Fähigkeit des Checkpoints, keine Zusage für 262K Kontext auf einem 24-GB-Mac.
Für Text und Bilder nennt die MLX-Modellkarte mlx-vlm samt Vision-Prozessor. Die Befehle richten dafür eine separate virtuelle Python-Umgebung ein und verwenden den dokumentierten Modulaufruf python -m mlx_vlm.generate. Ein reiner Textlauf prüft keine Bildfunktionen. Die Modellgewichte werden beim ersten Aufruf aus dem Netz geladen; danach kann die lokale Inferenz offline geprüft werden.
python3 -m venv .venv-qwen38
source .venv-qwen38/bin/activate
python -m pip install --upgrade mlx-vlm
python -m mlx_vlm.generate --model mlx-community/Qwen3.8-27B-4bit --max-tokens 256 --temperature 0.0 --prompt "Erkläre den KV-Cache bei einem LLM."
Für einen Bildtest mit derselben Runtime verwendest du eine unkritische lokale Testdatei:
python -m mlx_vlm.generate --model mlx-community/Qwen3.8-27B-4bit --max-tokens 256 --temperature 0.0 --prompt "Beschreibe dieses Foto genau." --image ./testfoto.jpgVor dem Bildtest eine eigene, unkritische JPG-Datei als testfoto.jpg im aktuellen Ordner ablegen. Die Python-Umgebung bleibt im Ordner .venv-qwen38; dokumentiere die tatsächlich installierte Version mit python -m pip show mlx-vlm. Die Befehle folgen der Modellkarte, sind keine auf einem Mac ausgeführten Benchmarks. Protokolliere Runtime-Version, Apple-Chip, Unified Memory, Prefill-/Decode-Dauer, Speicherdruck in der macOS-Aktivitätsanzeige, Kontextbudget und Bildgröße. Die theoretische 4-Bit-Gewichtsuntergrenze von ungefähr 13,9 GB ist nicht die gesamte Speicherbelegung: Runtime-Puffer, Vision und KV-Cache benötigen Reserve. Auf Systemen mit 24–32 GB mit moderatem Kontext beginnen und 8 Bit sowie Qwen3.6 unter identischen Aufgaben vergleichen.
Eigene unabhängige Messungen von Mac-Geschwindigkeit und Agentenstabilität liegen für diesen Artikel noch nicht vor. oMLX/DFlash-Kompatibilität muss anhand aktueller Runtime-Versionen statt bloß des Release-Tags geprüft werden. Gehostetes Qwen3.8-Max und Qwen3.8-Flash sind separate API-Angebote.
Quellen und Prüfdatum
Erstrecherche 14. August 2026, aktuelle Bestätigung von Qwen-/MLX-Verfügbarkeit und Testweg am 13. Oktober 2026. Primärquellen: Qwen-Checkpoint und MLX-4-Bit-Modellkarte, mit weiteren Links unten.
Quellenhinweis
Die Fußnoten benennen die jeweils verwendeten Originalquellen und dokumentierten Issues. Die Release-Recherche begann am 14. August; der MLX-Installationsweg und die Download-Angaben wurden am 13. Oktober 2026 erneut geprüft.
Quellen und Nachweisgrenzen
Die Belege zeigen Modellkarten, Community-Konvertierungen und dokumentierte Runtime-Probleme. Eine Quellenliste ersetzt keine unabhängige Messung der Mac-Leistung.
Footnotes
Häufig gestellte Fragen
Ist Qwen3.8-27B ein offizieller Qwen-Checkpoint?
Ja. Qwen veröffentlicht das Modell unter Qwen/Qwen3.8-27B auf Hugging Face. Die Model Card nennt 27B Parameter, Apache 2.0, Bild- und Videoverständnis sowie 262.144 native Kontexttokens.
Wie viel Unified Memory braucht Qwen3.8-27B auf dem Mac?
Die reinen Gewichte liegen theoretisch bei etwa 13,9 GB in 4 Bit, 27,8 GB in 8 Bit und 55,6 GB in BF16. Runtime, KV-Cache, Vision und macOS kommen hinzu; 24–32 GB sind deshalb die realistischere Startklasse für 4 Bit.
Wie groß ist das Kontextfenster?
Die offizielle Model Card nennt 262.144 Tokens nativ. Für bis zu 1.000.000 Tokens beschreibt Qwen eine Erweiterung über RoPE/YaRN-Konfiguration; das ist nicht dasselbe wie ein automatisch verfügbares 1M-Fenster in jeder lokalen Runtime.
Ist Qwen3.8-27B besser als Qwen3.6-27B?
Die Model Card enthält eine offizielle Vergleichstabelle, aber unabhängige Mac- und Laufzeittests fehlen noch. Für eine belastbare Aussage müssen Quantisierung, Harness, Tool-Schemas, Kontext und Aufgaben identisch sein.
Läuft Qwen3.8-27B schon mit oMLX?
Die qwen3_5-Architektur und vorhandene MLX-Konvertierungen sind gute Kompatibilitätssignale. Eine Qwen3.8-spezifische oMLX-Freigabe und ein direkter Tool-/Vision-Smoke-Test müssen aber separat bestätigt werden.