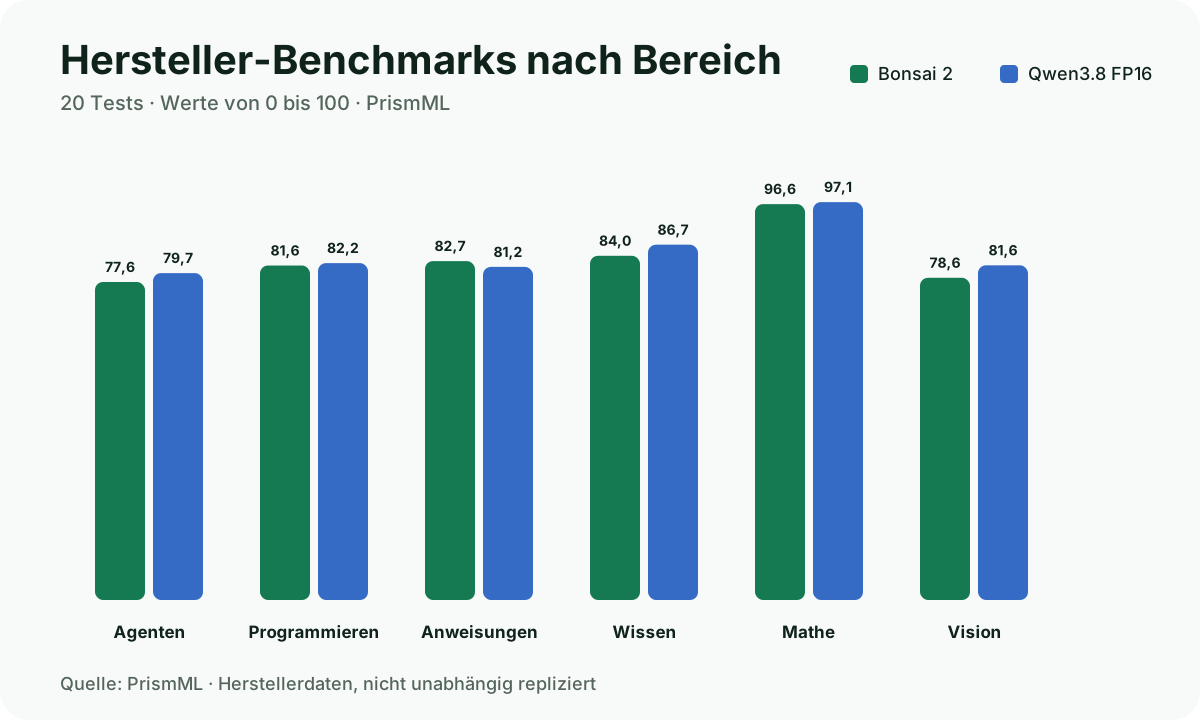
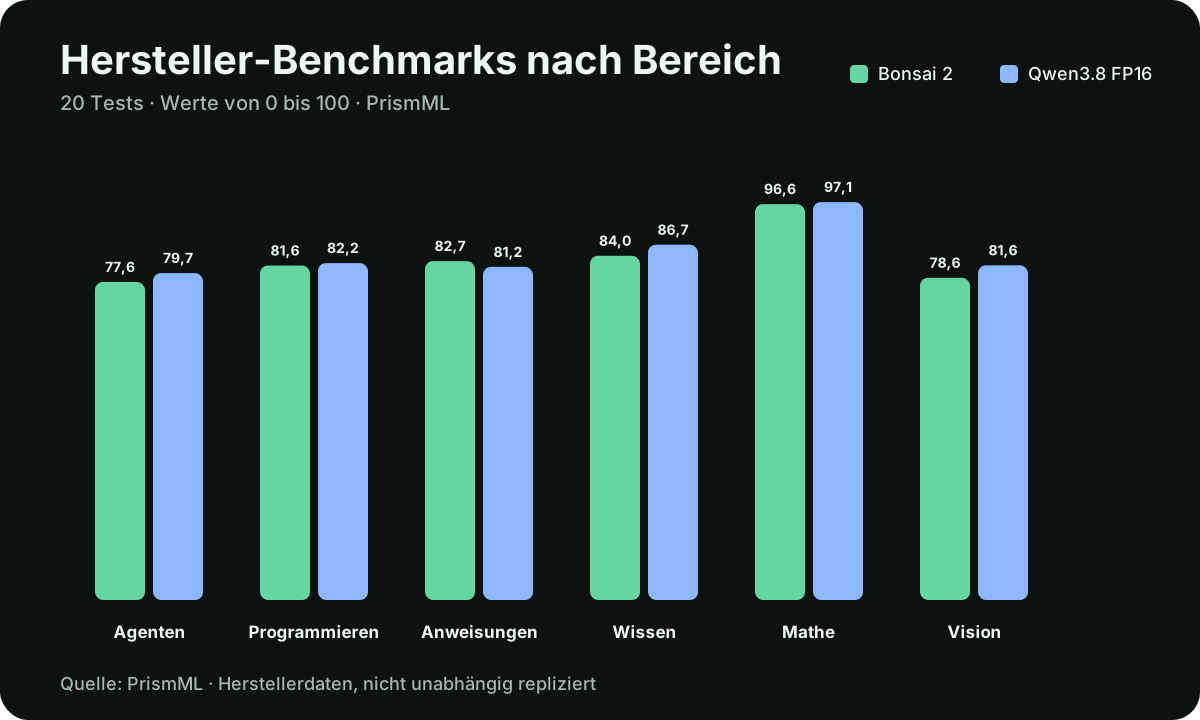
Aktualisiert am 9. Oktober 2026. PrismML hat Ternary Bonsai 2 27B am 17. September 2026 veröffentlicht. Das Modell basiert auf Qwen3.8-27B, verwendet ternäre Gewichte mit den Werten −1, 0 und +1 und soll laut PrismML bei einem drastisch kleineren Speicherformat 98,2 % der aggregierten Benchmark-Leistung des FP16-Ausgangsmodells behalten. 12
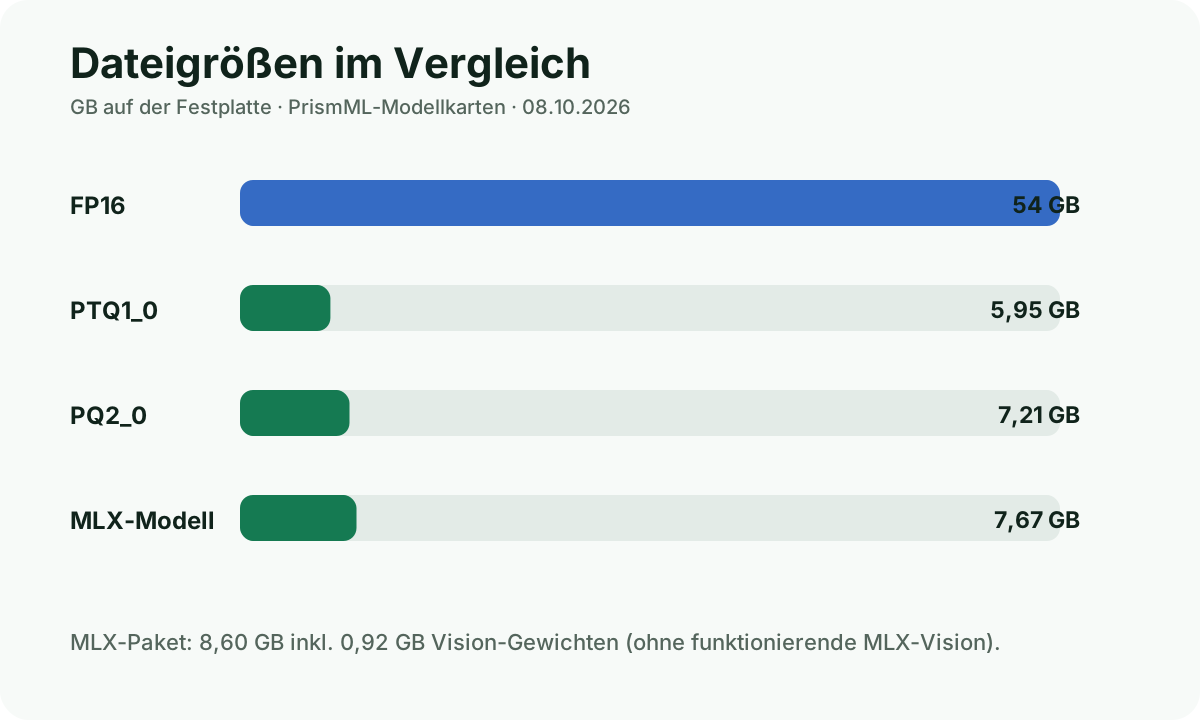
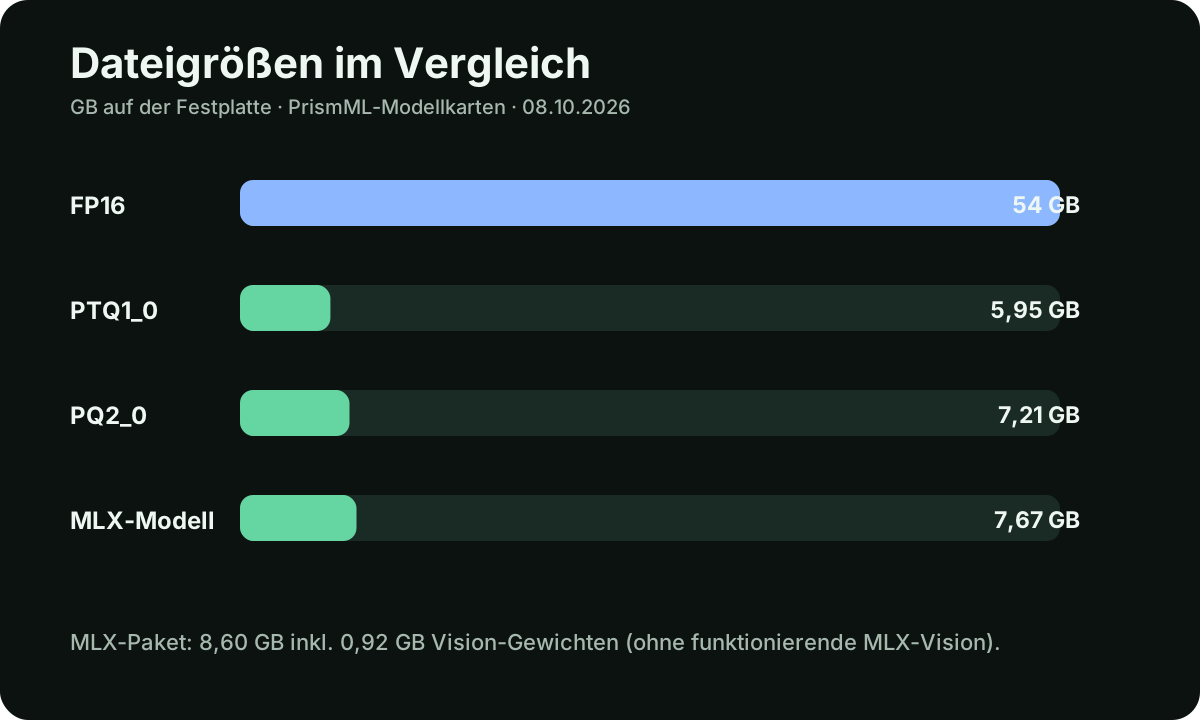
Die wichtigste Einschränkung steht jedoch nicht in der 5,9-GB-Schlagzeile: 5,9 GB sind weder der universelle Download noch der reale RAM-Bedarf. Das kleinste ausgelieferte GGUF-Sprachmodell (PTQ1_0) ist 5,95 GB groß; PQ2_0 belegt 7,21 GB, und das MLX-Paket für Apple Silicon kommt inklusive Vision-Tower auf 8,60 GB. Parallel dazu setzen die aktuellen Bonsai-2-GGUFs zwingend einen PrismML-Fork von llama.cpp voraus. Stock llama.cpp unterstützt die neuen Packings und die dazugehörige Hadamard-Aktivierungstransformation am 19. September 2026 noch nicht. 34567
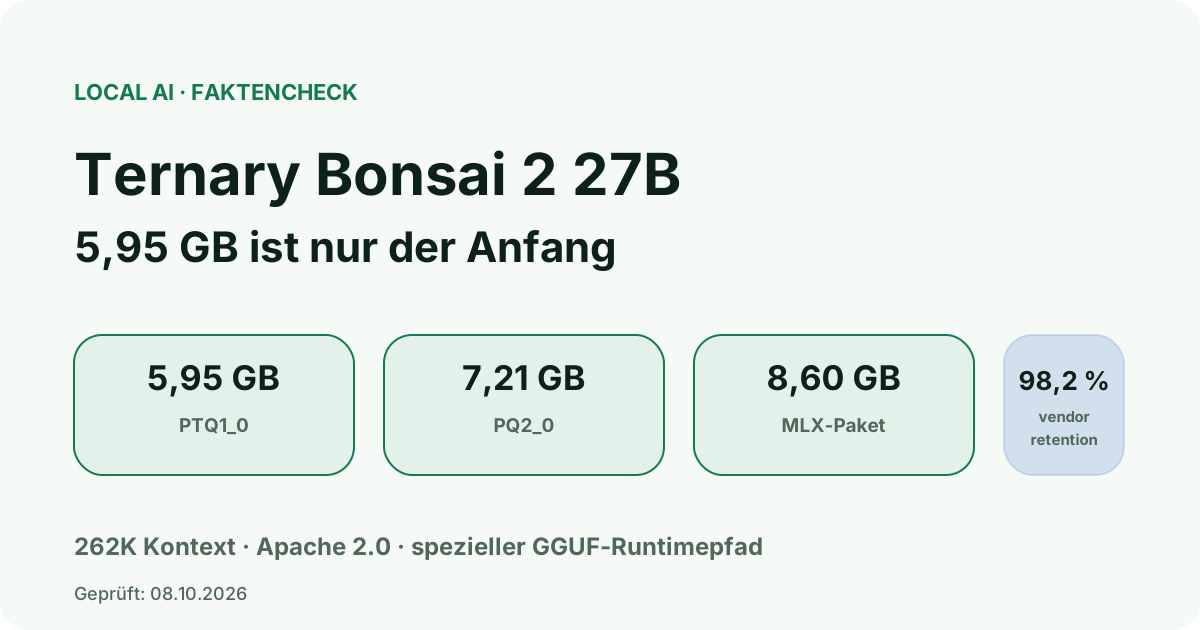
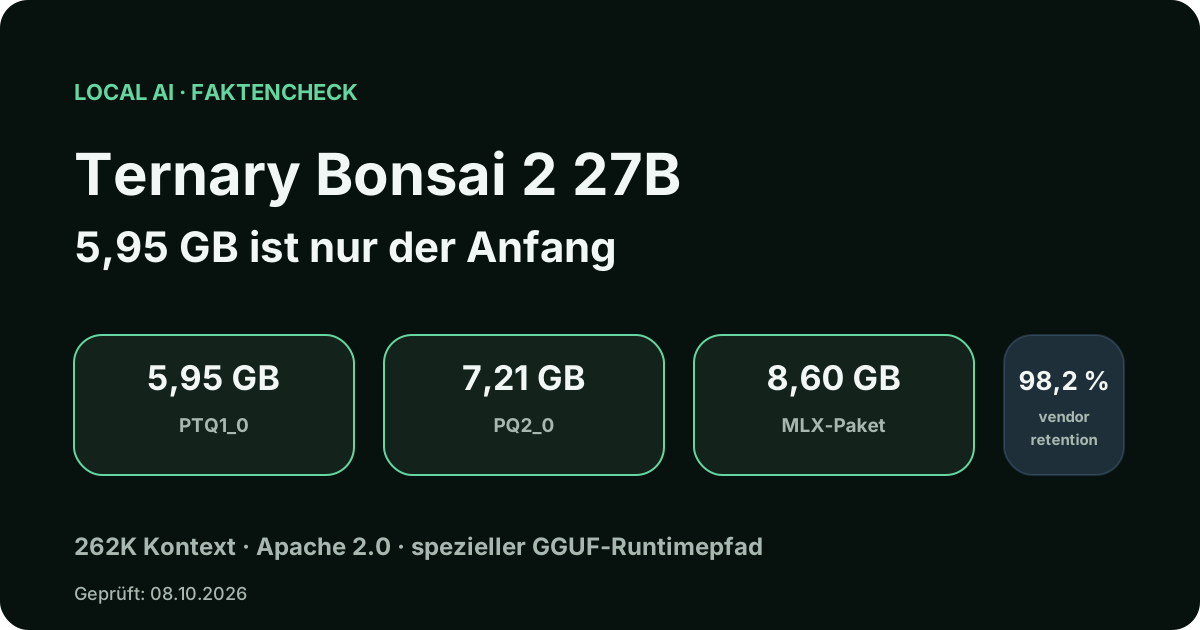
Bonsai 2 27B ist technisch ungewöhnlich attraktiv, wenn ein 27B-Klasse-Modell lokal in ein kleines Speicherbudget passen soll. Für eine problemlose Routine nach dem Muster „GGUF herunterladen und in beliebiger Standard-App starten“ kommt die Veröffentlichung verfrüht: Qualitäts- und Geschwindigkeitswerte basieren weitgehend auf Herstellerbenchmarks und warten auf unabhängige Replikation.
Die sechs wichtigsten Fakten
| Punkt | Verifizierter Stand am 19.09.2026 |
|---|---|
| Basis | Qwen3.8-27B |
| Modellklasse | 27B-Klasse, multimodal |
| Nativer Kontext | 262.144 Tokens |
| Kleinster ausgelieferter GGUF-LM-Pack | PTQ1_0, 5,95 GB |
| MLX-Paket | 8,60 GB inklusive 0,92-GB-Vision-Tower |
| Lizenz | Apache 2.0 |
| Benchmark-Retention | 98,2 % laut PrismML, noch ohne belastbare unabhängige Replikation |
| Runtime-Haken | Bonsai-2-GGUF derzeit nicht mit Stock-llama.cpp kompatibel |
Was ist Ternary Bonsai 2 27B?
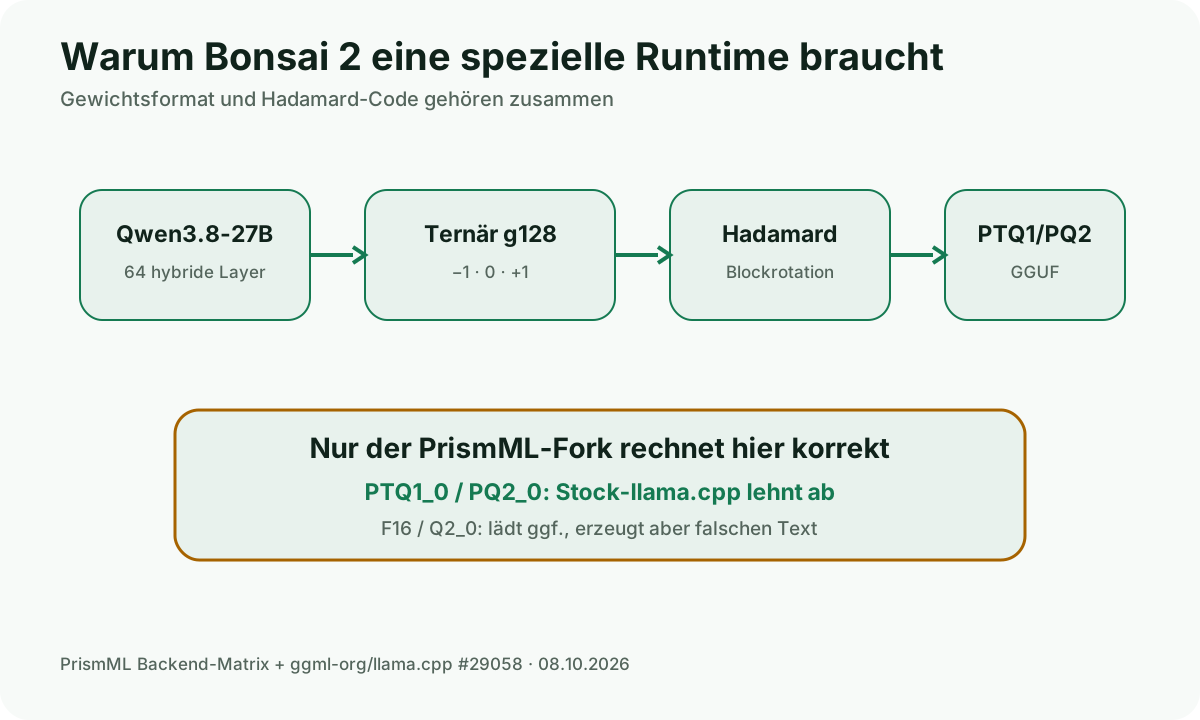
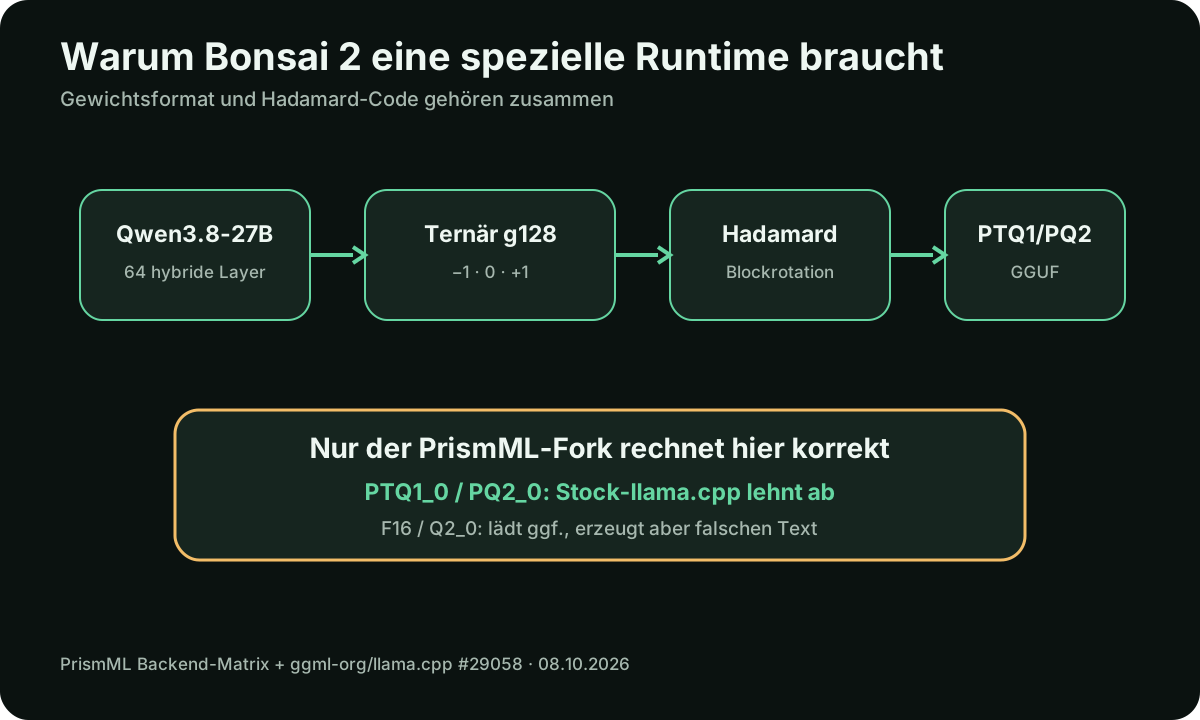
Bonsai 2 27B ist kein neu von Grund auf trainiertes 27B-Modell. PrismML leitet es von Qwen3.8-27B ab und behält die zugrunde liegende Hybrid-Attention-Architektur bei. Qwen beschreibt die Basis als 64-Layer-Modell mit einer Mischung aus Gated DeltaNet und voller Attention sowie einem nativen Kontext von 262.144 Tokens. 4810
Die Kompression verändert vor allem die Gewichtsrepräsentation. Die Sprachmodell-Gewichte werden gruppenweise ternär dargestellt: Jeder quantisierte Wert nimmt −1, 0 oder +1 an; pro 128er-Gruppe kommt ein FP16-Skalierungsfaktor hinzu. PrismML gibt für die idealisierte Repräsentation rund 1,72 Bit pro Gewicht an. Das kompakte PTQ1_0-GGUF liegt bei 1,75 Bit pro Gewicht, während PQ2_0 mit 2-Bit-Slots 2,13 Bit pro Gewicht benötigt. 34
Zusätzlich werden die Gewichtsmatrizen blockweise in eine Hadamard-Basis rotiert. Genau dieser Schritt erklärt, warum die Dateien nicht einfach eine weitere normale GGUF-Quantisierung sind: Die Inferenzruntime muss zur Laufzeit die passende Transformation auf die Aktivierungen anwenden. 347
5,9 GB: Was die Zahl wirklich bedeutet
Die „5,9-GB“-Schlagzeile bezieht sich exakt auf PTQ1_0, das kleinste der drei ausgelieferten Sprachmodell-Packs. Wer ein größeres Pack mit einfacherem Unpacking oder mit zusätzlichen Slots bevorzugt, greift zu PQ2_0 (7,21 GB) oder zum MLX-Bundle für Apple Silicon (8,60 GB auf der Platte, 0,92 GB davon entfallen auf den Vision-Tower). 3411
Gleichzeitig beziffern 5,9 GB lediglich eine Dateigröße, keinesfalls den realen Peak-RAM. Der Speicherbedarf im laufenden Betrieb hängt vom KV-Cache, von der gewählten Kontextlänge, dem Vision-Tower und dem Runtime-Overhead ab.
Wie viel RAM braucht Bonsai 2 wirklich?
Die reale Speicherlast hängt von vier Faktoren ab:
- Kontextlänge. Bei vollen 262.144 Tokens füllt der KV-Cache mehrere Gigabyte; bei 4K-Kontext bleibt er klein.
- Pack-Wahl. PTQ1_0 ist am kompaktesten, verlangt aber längere Unpack-Zeiten; PQ2_0 belegt 1,26 GB mehr Plattenplatz.
- Vision. Das MLX-Paket enthält einen Vision-Tower, PrismML dokumentiert für die 27B-MLX-Runtime bislang jedoch keinen funktionierenden Bildpfad. Für Bildverarbeitung bleibt der spezialisierte GGUF-Fork mit
mmprojPflicht. - Runtime-Overhead. llama.cpp und MLX allozieren eigene Buffer; die genauen Werte variieren mit der Runtime-Version.
Keine 8-GB-RAM-Garantie: Weder die Laufzeitbelegung noch das 64K-Vision-Szenario sind hier auf realen Macs reproduziert worden. Speicherpeak und korrekten Output gilt es stets mit dem konkreten Modellpack nachzumessen.
98,2 % Leistung: Was wurde tatsächlich gemessen?
PrismML hat in zwei hauseigenen Test-Suiten gemessen:
- 20-Suite-Aggregat (
benchmark-categories.csv): klassische Wissens-, Code- und Reasoning-Tests. - 14-Suite-Detail (
benchmark-14.csv): ein zweites, teilweise überschneidendes Aggregat.
In beiden Sammlungen erreicht Bonsai 2 laut Hersteller rund 98,2 % des FP16-Baseline-Scores. Die zwei Aggregate sind nicht identisch und dürfen nicht zusammengeführt werden: Beide Sammlungen decken unterschiedliche, teils überlappende Testreihen ab. 3412
Noch fehlt die unabhängige Replikation
Die 98,2-%-Retention stammt aus PrismML-eigenen Tests. Bis Redaktionsschluss lag keine unabhängige Replikation mit demselben Harness vor. Für einen belastbaren Wert braucht es entweder den öffentlichen benchmark-suite-Harness mit reproduzierbaren Seeds oder eine kompatible Suite wie HLE, MMMU-Pro oder DeepSWE v1.1, die von unabhängiger Stelle gefahren wird.
Wie schnell ist Bonsai 2?
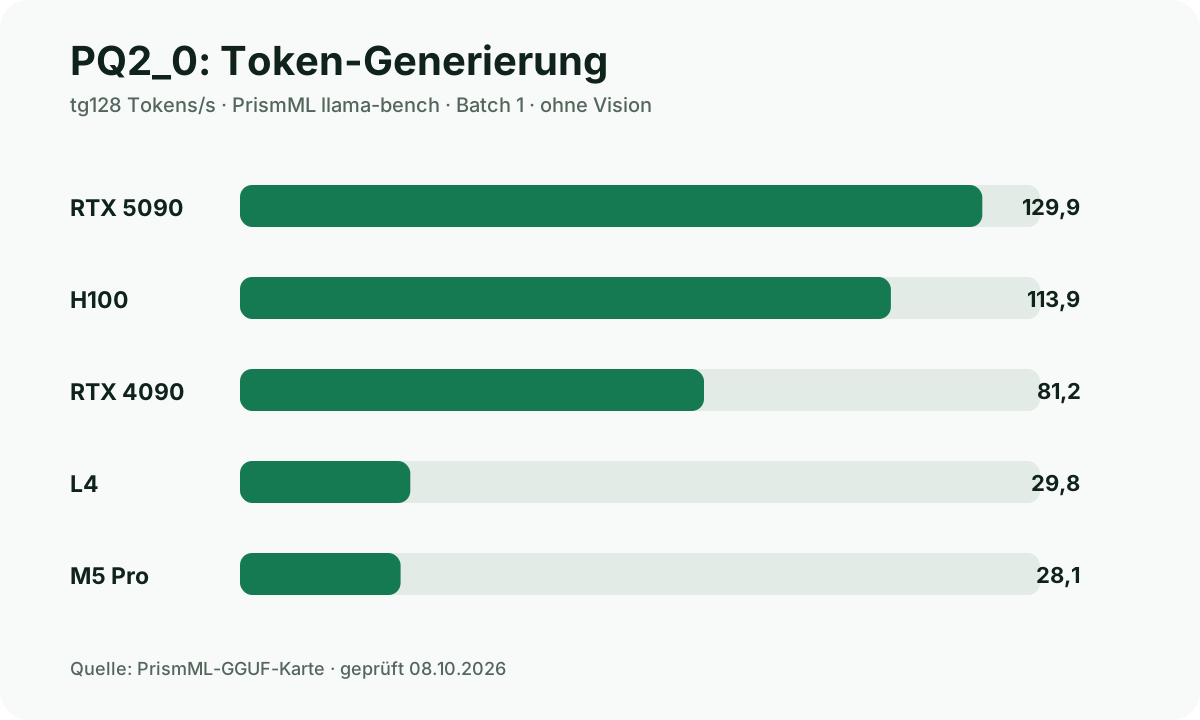
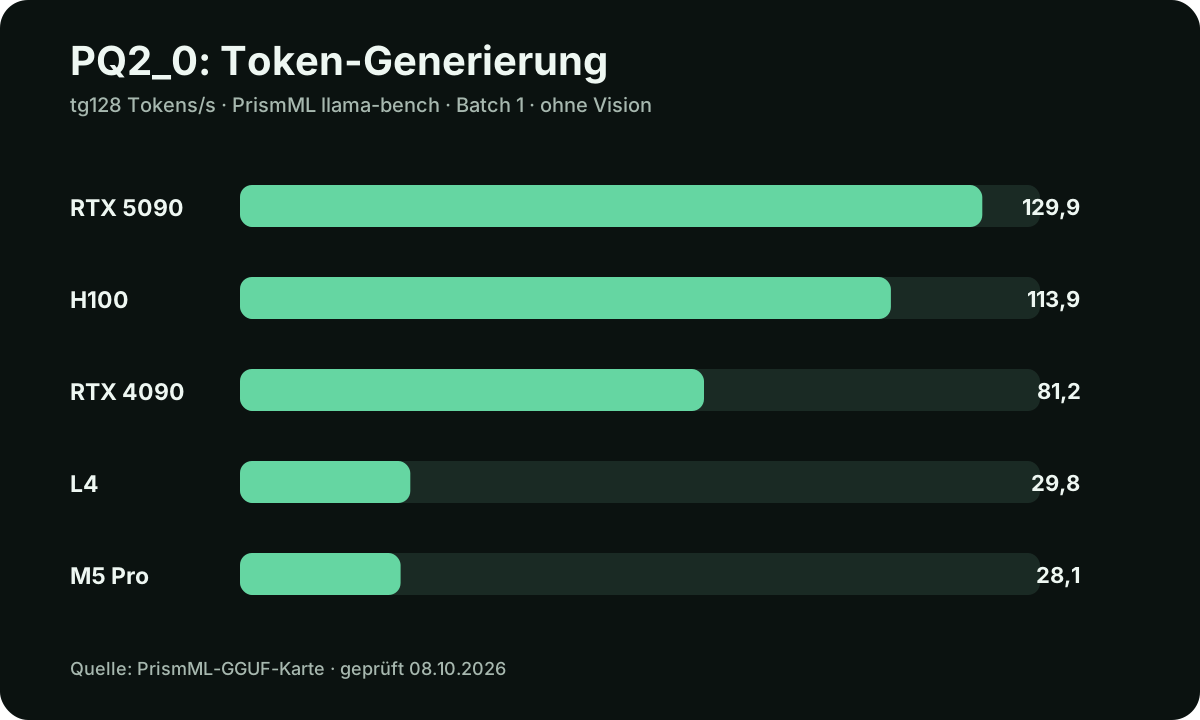
PrismML gibt für PTQ1_0 auf einer NVIDIA RTX 4090 Werte an, die zwischen 38 und 51 Tokens pro Sekunde für einzelne Streams liegen. PQ2_0 ist auf derselben GPU typischerweise 18 bis 25 % schneller, weil das Unpacking günstiger ist. 313
Auf Apple Silicon liegen für diesen Beitrag keine unabhängigen Durchsatzmessungen vor. Der Mac-Wert in der folgenden Hersteller-Grafik ist kein ai-on-mac-Benchmark und nicht ohne identische Backend- und Kontextangaben mit NVIDIA-GPUs vergleichbar.
Energie: plausibel, aber ebenfalls Herstellerdaten
Die Energieangaben stammen aus PrismML-Szenarien auf einer RTX 4090 (TDP ≈ 450 W). Für drei angenommene Auslastungen nennt der Hersteller grob 0,9 kWh, 1,6 kWh und 3,1 kWh pro Million generierter Tokens, abhängig von Prompt/Generation-Verhältnis und Kontextlänge. 14
Wichtig: Das sind Hersteller-Szenarien. Eine unabhängige Watt-Messung mit demselben Harness wurde in den geprüften Quellen nicht veröffentlicht.
Der aktuelle Runtime-Status: warum normales llama.cpp nicht genügt
PrismMLs Backend-Matrix und das weiterhin offene Upstream-Issue #29058 belegen am 8. Oktober 2026 unterschiedliche Fehlermodi:
| Bonsai-2-Datei | Stock llama.cpp, Ollama oder gewöhnliche GGUF-App | Sichere Alternative |
|---|---|---|
PTQ1_0, PQ2_0 | Neue Tensor-Typen 143/142: Datei wird abgewiesen | PrismML-Fork |
Spezielles Q2_0-GGUF im Dev-Repository | Kann laden, aber ohne Hadamard-/Sign-Flip-Transformation: unbrauchbare Antworten | PrismML-Fork |
Bonsai-2-F16 | Kann laden, aber ohne Transformation: unbrauchbare Antworten | PrismML-Fork |
Ein erfolgreiches Laden beweist keine korrekte Inferenz. Die Aussage, Stock-llama.cpp lade PTQ1_0 und produziere bloß schlechte Antworten, war falsch: bei PTQ1_0 und PQ2_0 scheitert der Load normalerweise schon an der Tensor-Kennung. Die ältere Bonsai-Generation verwendet andere Formate und ist nicht auf Bonsai 2 übertragbar.
Mac-Einrichtung mit dem tatsächlichen Hersteller-Repository
Für die GGUF-Variante auf Apple Silicon veröffentlicht PrismML einen Demo-Launcher, der passende Fork-Binaries und Modelle auswählt. Die folgenden Befehle stammen aus PrismML-Eng/Bonsai-demo:
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
./setup.sh
./scripts/start_llama_server.sh
Der Server läuft laut Demo auf http://localhost:8080. Der Setup-Prozess kann laut Known Issues rund 19 GB Modelldateien herunterladen; BONSAI_SKIP_GGUF=1 überspringt diesen Teil. Vor dem Start die gewählte Runtime, Metal-Offloading, verfügbaren RAM und Kontext prüfen. Ein zweizeiliger Installationsbefehl ist kein Nachweis, dass das Modell auf jedem Mac mit 8 oder 16 GB stabil läuft.
Der andere Apple-Weg heißt prism-ml/Ternary-Bonsai-2-27B-mlx-2bit. Die MLX-Dateien erfordern den mitgelieferten Bundle-Loader: Laut Hersteller laden generische MLX-Programme und LM Studio (MLX) die Spezialstruktur derzeit nicht korrekt. Das früher genannte Repository prismml/Bonsai-2-27B-mlx und der vermeintliche generate.py-Befehl waren nicht belegbar und sind hier entfernt.
Mac-RAM-Aussagen und 262K-Kontext
5,95 GB sind eine GGUF-Dateigröße, keine garantierte Peak-RAM-Anforderung. Dazu kommen KV-Cache, Runtime-Buffers, Kontext und eventuell Vision-Projektor. Die vorherige Tabelle, wonach etwa 24 GB Unified Memory 32K plus Vision ohne Swap oder 48 GB 262K plus Vision sicher bewältigen, war nicht durch reproduzierbare eigene Messungen abgesichert und wurde gestrichen. Für einen Hardwarekauf müssen Pack, Runtime-Commit, KV-Cache-Format, Speicherpeak, Prompt-Länge und Korrektheit gemeinsam getestet werden.
Vision-Sonderfall: Das MLX-Paket enthält zwar ein Vision-Tower-Artefakt; die offiziellen Known Issues melden aber keine funktionierende 27B-Vision-Unterstützung über MLX. Für Bilder empfiehlt der Hersteller den PrismML-GGUF-Server mit mmproj. Eine Distribution mit Vision-Gewichten ist nicht automatisch eine funktionierende Vision-Runtime.
Warum Agenten trotzdem scheitern können
PrismML nennt konkrete Fehlerbilder: reasoning_effort: "high" kann HTTP 500 erzeugen (bekannt sind low, medium, xhigh); eine Ausgabegrenze von nur -n 256 kann während des internen Denkens enden; mehrere Systemnachrichten können die Chatvorlage überfordern; ungültige tool_calls und Wiederholungsschleifen sind dokumentiert. Für die Fehlersuche empfiehlt PrismML ausreichende Output-Budgets, z. B. max_tokens: 16384, und bei passender RAM-Reserve -c 65536. Nicht als Standard auf knappen Macs übernehmen. Auch ein setup.sh-Problem mit macOS 27 / Xcode 26.5 ist vermerkt. Vor produktivem Einsatz die Known Issues und die verwendete Release-Version prüfen.
Die PrismML-Tool-Dokumentation zeigt native OpenAI-artige tool_calls und MCP, belegt aber keine beliebige Agentenzuverlässigkeit. Tool-Antworten validieren, Tool-Rechte beschränken und Schreibaktionen bestätigen lassen.
Lizenz und Preis
Die Gewichte werden kostenlos unter Apache 2.0 bereitgestellt. 23413 Wir haben keinen offiziellen, separaten PrismML-Inference-API-Preis für Bonsai 2 als Produktgrundlage gefunden. Wer lokal ausführt, bezahlt daher primär vorhandene oder neu gekaufte Hardware und Strom.
Die Alibaba-Cloud-Preise für qwen3.8-27b betreffen die gehostete Qwen-Basis und dürfen nicht als Bonsai-2-API-Preis dargestellt werden. 15
Prüfprotokoll für einen echten Mac-Vergleich
Status am 9. Oktober 2026: Im PrismML-Repository und in der Backend-Matrix steht weiterhin, dass Bonsai 2 für die GGUF-Ausführung PrismMLs llama.cpp-Fork benötigt. Ein Format, das von Stock-llama.cpp eingelesen wird, kann wegen fehlender Hadamard-/Sign-Flip-Transformationen trotzdem unbrauchbare Ausgabe liefern. „Datei lädt“ ist deshalb kein korrekter Kompatibilitätstest.
Für die eigene Prüfung: Versionsstand oder Commit des Forks notieren, exakten GGUF-Dateinamen und Digest erfassen, PTQ1_0 gegen PQ2_0 mit identischen Aufgaben vergleichen und mindestens ein erwartbares Testergebnis automatisch kontrollieren. Zusätzlich das tatsächliche RAM-/Swap-Maximum, Prefill- und Ausgabetempo, Mac-Chip, Kontextgröße und gegebenenfalls Vision-Projektor aufschreiben. Die oft zitierten 98,2 % stammen aus PrismMLs Benchmark-Aggregat und belegen weder eine unabhängige Replikation noch eine gemessene Mac-Eignung.
Für wen ist Bonsai 2 interessant?
Starkes Einsatzprofil: lokale Coding- oder Rechercheassistenten, private Dokumentanalyse, Multimodalität und Agenten-Experimente, wenn 27B-Klasse bei sehr begrenztem Gewichts-Footprint gefragt ist.
Noch unbequem: Nutzer, die heute ein beliebiges GGUF in Ollama oder LM Studio ziehen und ohne spezielle Runtime starten möchten.
Noch offen: Wie gut die 98,2-%-Retention in unabhängigen Tests, langen Agentenläufen und realen Multimodal-Workflows hält.
Fazit: Bonsai 2 als Spezialisten-Modell, nicht als universelles GGUF
Ternary Bonsai 2 27B ist vor allem wegen der Kombination interessant: 27B-Klasse, 262K nativer Kontext, Vision, Agentik und ein Sprachmodell-Packing ab 5,95 GB. Die Architektur ist dabei nicht bloß eine normale 2-Bit-Quantisierung, sondern nutzt ternäre Gewichte plus gruppenweise Skalierung und eine passende Hadamard-Transformation. 34
Die zwei wichtigsten Vorbehalte sind ebenso konkret. Erstens ist 5,9 GB keine universelle RAM-Zahl. Zweitens sind die eindrucksvollen Qualitäts-, Speed- und Energieangaben derzeit weitgehend Herstellerdaten. Dazu kommt die noch junge Runtime-Unterstützung: Für Bonsai-2-GGUF ist am 19. September 2026 der PrismML-Fork der verifizierte Weg.
Wer das Modell heute testet, sollte über isolierte Modellvergleiche hinausgehen und Packing, Runtime-Version, Kontextlänge, Prompt-Processing, Token-Generation, Vision und Speicherpeak lückenlos protokollieren. Genau dann wird aus der 5,9-GB-Schlagzeile ein reproduzierbarer Local-AI-Test.
Wie Speicherbedarf, Quantisierung und Kontext zusammenhängen, erklärt der Unified-Memory-Guide.
Quellen zu den technischen Angaben
Die Links führen zu den jeweils genannten Original-, Community- oder journalistischen Belegen. Die Zitierung ersetzt keine unabhängige Messung; die Kompatibilitätslage ist zeitabhängig.
Footnotes
Häufig gestellte Fragen
Was bedeutet „ternär“ bei Bonsai 2?
Die Gewichte werden gruppenweise in drei Werte (-1, 0, +1) abgebildet; pro 128er-Gruppe kommt ein FP16-Skalierungsfaktor hinzu. Zusätzlich rotiert eine Hadamard-Transformation die Gewichtsmatrizen blockweise, damit die Aktivierungen zur Laufzeit wieder transformiert werden können. Das ist der Grund, warum Stock-llama.cpp die neuen GGUFs nicht ohne weiteres ausführt.
Sind 5,9 GB die reale RAM-Anforderung?
Nein. 5,95 GB ist die PTQ1_0-Dateigröße. Peak-RAM hängt von KV-Cache, Kontext und Runtime ab und wurde für typische Mac-Konfigurationen hier nicht unabhängig gemessen. Das MLX-27B-Paket enthält Vision-Gewichte, unterstützt laut Known Issues derzeit aber keine funktionierende Bildverarbeitung.
Was sagt die 98,2-%-Benchmark-Retention wirklich aus?
PrismML hat in zwei eigenen Testbatterien (20-Suite-Aggregat und 14-Suite-Aggregat) gemessen, dass das ternäre Modell rund 98,2 % des FP16-Benchmarks hält. Beide Aggregate sind Herstellerbenchmarks; unabhängige Replikationen mit demselben Harness liegen aktuell nicht vor. Die Zahlen sind ein Ausgangspunkt, kein Beweis für reale Workload-Qualität.
Kann ich Bonsai 2 27B heute auf einem Mac laufen lassen?
Ja, aber GGUF erfordert den offiziellen PrismML-Fork mit Metal-Unterstützung. MLX benötigt den mitgelieferten Bundle-Loader; die 27B-MLX-Version unterstützt laut PrismML derzeit keine Bildverarbeitung. Wir geben keine unbelegten Mac-RAM-Garantien.
Werden Bonsai-2-Eingaben zum Training verwendet?
Bonsai-2-Gewichte stehen unter Apache 2.0, aber für die Inferenz via PrismML-Fork oder MLX-Bundle existiert kein zentrales Inference-API-Produkt mit dokumentiertem Retention-Verhalten. Wer eine Trainingssperre braucht, sollte sie gegen den lokalen Runtime-Betreiber oder gegen Drittanbieter-APIs explizit vertraglich absichern.
Wo finden sich die Originalquellen für die genannten Zahlen?
Die primären technischen Quellen sind die drei Hugging-Face-Karten (PTQ1_0-GGUF, PQ2_0-GGUF, MLX), das PrismML-Fork-Repository von llama.cpp und das Issue im Stock-llama.cpp-Repo. Benchmark-Zahlen kommen aus dem PrismML-Benchmark-Repository, sind aber als Herstellerwerte gekennzeichnet.