Für ein performantes lokales Sprachmodell auf einem Apple-Silicon-Mac sind 16 GB Unified Memory das absolute Minimum, 24 bis 32 GB der vernünftige Einstieg, 48 bis 64 GB der Bereich für größere Modelle und anspruchsvollere Workflows und 96 bis 128 GB oder mehr sinnvoll, wenn 70B-Modelle, sehr lange Kontexte, multimodale Modelle oder mehrere parallele Prozesse geplant sind. 8 GB eignen sich ausschließlich für kleine, stark quantisierte Modelle und kurze Kontexte. Stand dieser Planungswerte: 16. August 2026.
Wenn du speziell ein Notebook kaufst, vergleicht der Guide MacBook für KI-Entwicklung 2026 die verfügbaren M1- bis M5-Konfigurationen und zeigt, wann Air, Pro oder Max die sinnvollere RAM-Stufe bietet.
Entscheidend ist nicht allein die Parameterzahl. Der tatsächliche Speicherbedarf folgt der architektonischen Grundformel:
$$\text{Unified Memory} = \text{Modellgewichte} + \text{KV-Cache} + \text{Quant-Metadaten} + \text{Runtime-Overhead} + \text{macOS/Apps} + \text{Sicherheitsbuffer}$$
Ein Modell, das gerade noch startet, kann ohne ausreichenden Puffer swap-lastig oder instabil sein.
Auf Apple Silicon teilen sich CPU und GPU denselben physischen Speicherpool. Apple bezeichnet das als Unified Memory. Dadurch muss ein Modell nicht wie auf einem klassischen PC zwischen separatem Arbeitsspeicher und Grafikspeicher kopiert werden. Der Speicher bleibt aber endlich und wird zugleich von macOS, Browser, IDE, Datenbank, RAG-Index und anderen Prozessen genutzt.
Unified-Memory-Stufen und passende Modellgrößen
| Unified Memory | Passende Modellgrößen in der Praxis |
|---|---|
| 8 GB | 1B- bis 3B-Modelle in 4 Bit; nur zum Ausprobieren |
| 16 GB | 7B- bis 8B-Modelle in 4 oder 5 Bit; 12B bis 14B nur knapp |
| 24 GB | 12B- bis 14B-Modelle komfortabel; 20B bis 24B in 4 Bit mit begrenztem Kontext |
| 32 bis 36 GB | 20B bis 32B in 4 Bit; brauchbar für Entwicklung und RAG |
| 48 GB | 32B höher quantisiert; mehr Reserve für Tools und lange Prompts |
| 64 GB | 70B in einer guten 4-Bit-Quantisierung mit moderatem Kontext |
| 96 bis 128 GB | 70B in 5 bis 8 Bit oder Modelle um 100B bis 120B in 4 Bit |
| 192 bis 256 GB | sehr große Modelle, mehrere Instanzen oder hohe Präzision |
| 512 GB | 405B-Klasse in 4 Bit mit realer Reserve; nur in aktuellen Ultra-Konfigurationen |
Diese Werte sind Planungsbereiche, keine Garantien. Sie folgen aus den nachvollziehbaren Modellierungsformeln für Gewichte und KV-Cache mit Stand 16. August 2026. Architektur, Quantisierungsformat, Kontext, Batch-Größe und Runtime können den Bedarf deutlich verändern.
Für dein konkretes Modell: Der Mac LLM RAM-Rechner berechnet Modellgewichte, KV-Cache, macOS-Reserve und passende Macs.
RAM-Bedarf beliebter Modelle 2026
Die Stufen oben sind allgemein. Für konkrete Modelle ergibt die Rechnung diese theoretischen Planungswerte (Q4_K_M-Gewichtsschätzungen, F16-KV-Cache, eine Session, berechnet mit dem Mac LLM RAM-Rechner am 4. Oktober 2026). Achtung: gpt-oss wird offiziell mit MXFP4 ausgeliefert; seine Zeilen sind keine gemessenen Q4_K_M-Ollama-Dateien. „Knapp“ heißt 8K Kontext mit etwa 5 GB für macOS und wenige Apps; „komfortabel“ heißt 32K Kontext mit 8 GB App-Reserve und höchstens 85 % Auslastung.
| Modell | Erschienen | Q4-Gewichte | KV-Cache bei 32K | Mac knapp | Mac komfortabel |
|---|---|---|---|---|---|
| Qwen 3.5 9B | Feb. 2026 | 5,1 GB | 1,0 GB | 16 GB | 24 GB |
| Gemma 4 12B | Juni 2026 | 6,8 GB | 0,6 GB | 16 GB | 24 GB |
| gpt-oss 20B (MoE) | Aug. 2025 | 11,9 GB | 0,8 GB | 24 GB | 32 GB |
| Gemma 4 26B A4B (MoE) | März 2026 | 14,8 GB | 0,5 GB | 24 GB | 32 GB |
| Qwen 3.8 27B | Aug. 2026 | 15,4 GB | 2,1 GB | 24 GB | 36 GB |
| Muse Glimmer 30B | Aug. 2026 | 16,0 GB | 0,5 GB | 24 GB | 32 GB |
| Gemma 4 31B | März 2026 | 17,5 GB | 2,0 GB | 32 GB | 48 GB |
| Qwen 3.6 35B A3B (MoE) | Apr. 2026 | 19,9 GB | 0,7 GB | 32 GB | 48 GB |
| Llama 3.1 70B | Juli 2024 | 39,9 GB | 10,0 GB | 64 GB | 96 GB |
| gpt-oss 120B (MoE) | Aug. 2025 | 66,6 GB | 1,1 GB | 96 GB | 96 GB |
Zwei Dinge fallen auf. Erstens unterscheiden sich die geschätzten KV-Caches in dieser Tabelle um Faktor 5 bis 20: Bei 32K Kontext sind es etwa 10 GB für Llama 3.1 70B, etwa 2 GB für Gemma 4 31B und Qwen 3.8 27B sowie etwa 0,5 GB für Muse Glimmer 30B. Das folgt aus den hinterlegten Attention-Architekturen, Sliding-Window-/State-Konfigurationen und angenommenem F16-Cache – nicht aus einem gemessenen Mac-Benchmark. Zweitens reduzieren Mixture-of-Experts-Modelle die aktive Rechenarbeit, aber nicht automatisch den Speicherbedarf oder die Antwortzeit: Gemma 4 26B A4B aktiviert pro Token nur etwa 4B Parameter. Für eine flüssige Inferenz muss der deutlich größere quantisierte Expertensatz trotzdem verfügbar sein. Runtime, Cache und Speicherbandbreite bestimmen mit, wie schnell das Modell wirklich antwortet. gpt-oss erscheint im MXFP4-Format statt Q4_K_M; Ollama listet die 120B-Datei mit 65 GB, etwas unter der Q4-Schätzung. Die Release-Daten der neueren Modellklassen lassen sich direkt anhand der Google-Gemma-Releases (Gemma 4 26B/31B: 31. März; 12B: 3. Juni 2026), des offiziellen Qwen3.8-Repositories (27B: 14. August) und der Meta-Muse-Glimmer-Modellkarte (August) überprüfen. Diese Quellen belegen die Modellversionen, nicht die berechneten Mac-RAM-Schwellen. Letztere hängen vom jeweiligen Modell-Tag, der Quantisierung, dem Kontext und laufenden Programmen ab.
RAM, VRAM und Unified Memory auf dem Mac
Klassischer RAM
RAM ist der schnelle Arbeitsspeicher, in dem das Betriebssystem, Programme und aktive Daten liegen. Auf einem PC mit diskreter Grafikkarte liegen CPU-Daten meist im System-RAM, während die GPU einen eigenen VRAM besitzt. Ein Modell kann deshalb in den System-RAM passen, aber trotzdem nicht vollständig in den VRAM.
Dedizierter VRAM
VRAM ist Speicher direkt an einer diskreten GPU. Für LLM-Inferenz ist er häufig der harte Engpass, weil Modellgewichte, KV-Cache und Arbeitsbereiche möglichst nah an der GPU liegen sollen. Reicht der VRAM nicht, müssen Teile über PCIe aus dem System-RAM übertragen oder auf der CPU berechnet werden.
Unified Memory bei Apple Silicon
Apple-Silicon-Macs nutzen einen gemeinsamen Speicherpool für CPU und GPU. Apple dokumentiert ausdrücklich, dass beide auf denselben physischen Speicher zugreifen. Das reduziert Kopien und ermöglicht, dass eine integrierte GPU auf deutlich mehr Speicher zugreifen kann als viele diskrete Consumer-GPUs.
Das bedeutet jedoch nicht:
- dass der gesamte Unified Memory dem Modell gehört;
- dass die Neural Engine automatisch jede LLM-Runtime beschleunigt;
- dass 64 GB auf jedem Mac gleich schnell sind;
- dass ein Modell, das in 64 GB passt, automatisch interaktiv schnell läuft.
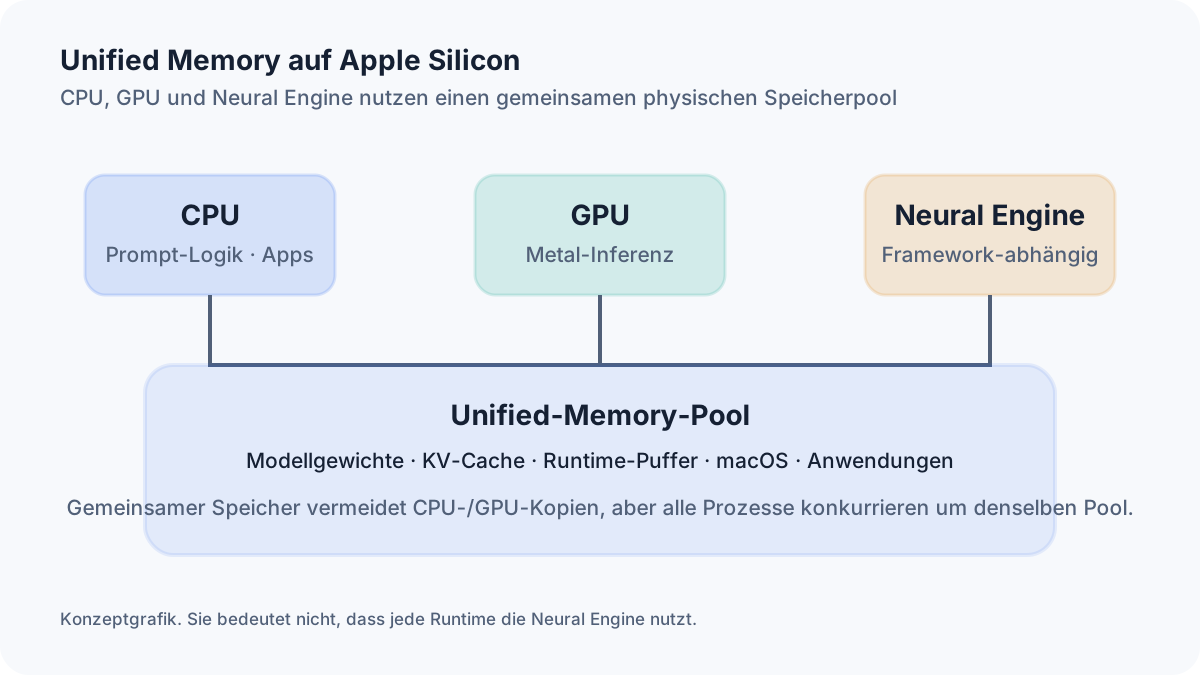
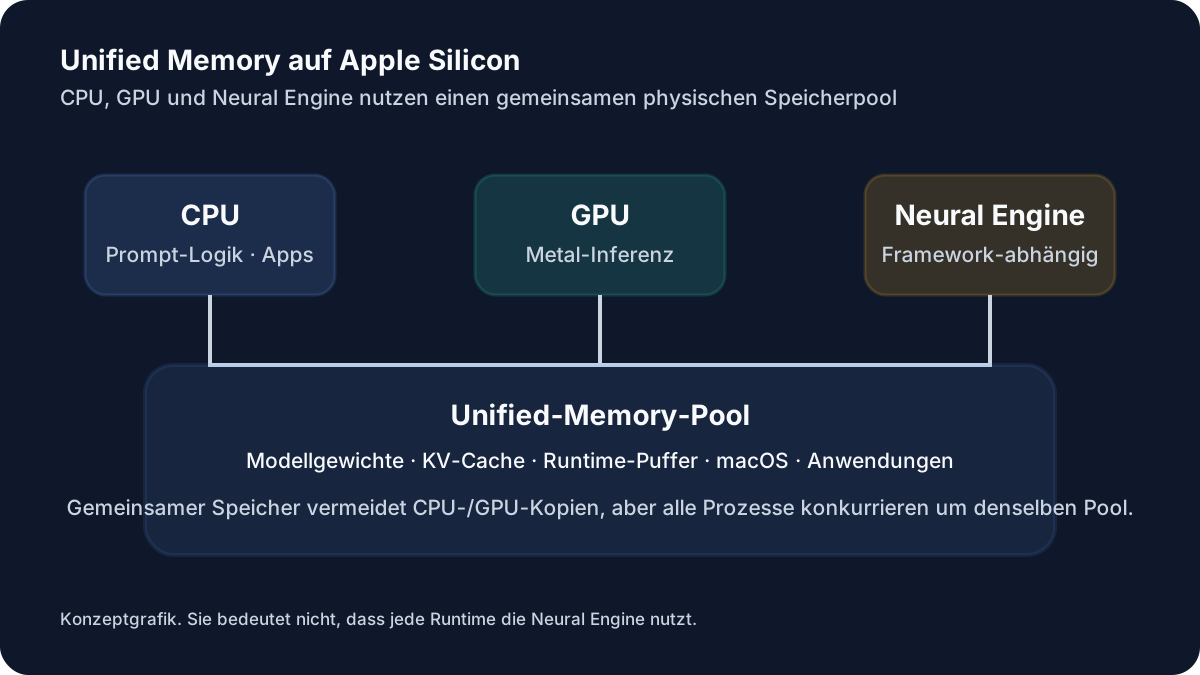
*Abbildung 1: CPU und GPU greifen bei Apple Silicon auf denselben physischen Unified-Memory-Pool zu, statt getrennten System-RAM und VRAM zu verwenden. *
Fünf unterschiedliche Zustände
- Passt in den Speicher: Gewichte und Laufzeitdaten können allokiert werden.
- Läuft vollständig GPU-beschleunigt: Die gewählte Runtime hält die relevanten Tensoren auf dem Metal-Backend.
- Teilweises Offloading: Einige Layer oder Operationen laufen auf CPU oder einem anderen Backend.
- Kompression und Swap: macOS komprimiert Speicher und lagert inaktive Seiten auf die SSD aus.
- Technisch startbar, praktisch ungeeignet: Sehr lange Ladezeiten, hohe Time to First Token, niedrige Tokens pro Sekunde oder ständiges Nachladen.
Woraus setzt sich der Speicherbedarf zusammen?
1. Modellgewichte
Die Gewichte sind der größte feste Block. Ihre Idealgröße hängt von Parameterzahl und Bitbreite ab.
2. Quantisierungsdaten
Eine „4-Bit-Datei“ enthält nicht zwangsläufig exakt vier Bit pro Parameter. Blockskalierungen, Nullpunkte, Metadaten, unquantisierte Tensoren und gemischte Präzision erhöhen die reale Bits-per-Weight-Zahl. Das llama.cpp-Projekt dokumentiert beispielsweise für Q4_K_M reale Dateien von 4,9 GB bei 8B, 43,1 GB bei 70B und 249,1 GB bei 405B – jeweils größer als die ideale 4-Bit-Rechnung.
3. KV-Cache
Der Key-Value-Cache speichert für bereits verarbeitete Tokens Zwischenergebnisse der Attention-Layer. In der Näherung wächst er linear mit Tokenzahl, Layerzahl, KV-Head-Zahl, Head-Dimension, Batch-Größe und Datentyp.
4. Runtime-Overhead
Dazu gehören Graphen, Buffer, Tokenizer, Sampler, Metal-Kernels, Threadpools und Verwaltungsdaten. Der Wert ist runtime- und architekturabhängig.
5. Temporäre Tensoren
Prefill, Attention und Matrixmultiplikationen benötigen Arbeitsbereiche. Flash Attention oder optimierte Kernel können diesen Bedarf verändern.
6. macOS und Anwendungen
Finder, WindowServer, Browser, Terminal, IDE, Docker, Datenbanken und RAG-Komponenten nutzen denselben Speicherpool. Apple zeigt in der Aktivitätsanzeige getrennt App-Speicher, verdrahteten Speicher, komprimierten Speicher und Swap an.
7. Mehrere Modelle und parallele Anfragen
Zwei gleichzeitig geladene Modelle benötigen ungefähr die Summe ihrer Gewichte plus getrennte Caches und Arbeitsbereiche. Mehrere parallele Sequenzen vervielfachen den KV-Cache weitgehend mit der Batch- beziehungsweise Sequenzzahl.
8. Multimodale Komponenten
Vision Encoder, Audio Encoder, Projektoren und zusätzliche Tokenrepräsentationen kommen zum Sprachmodell hinzu. Bei GGUF-Modellen kann beispielsweise eine separate Multimodal-Projektordatei geladen werden.
9. Mixture of Experts
Bei MoE-Modellen werden pro Token nur einige Experten berechnet, aber oft müssen deutlich mehr oder alle Expertengewichte im Speicher liegen. Aktive Parameter sind daher nicht dasselbe wie gespeicherte Gesamtparameter.
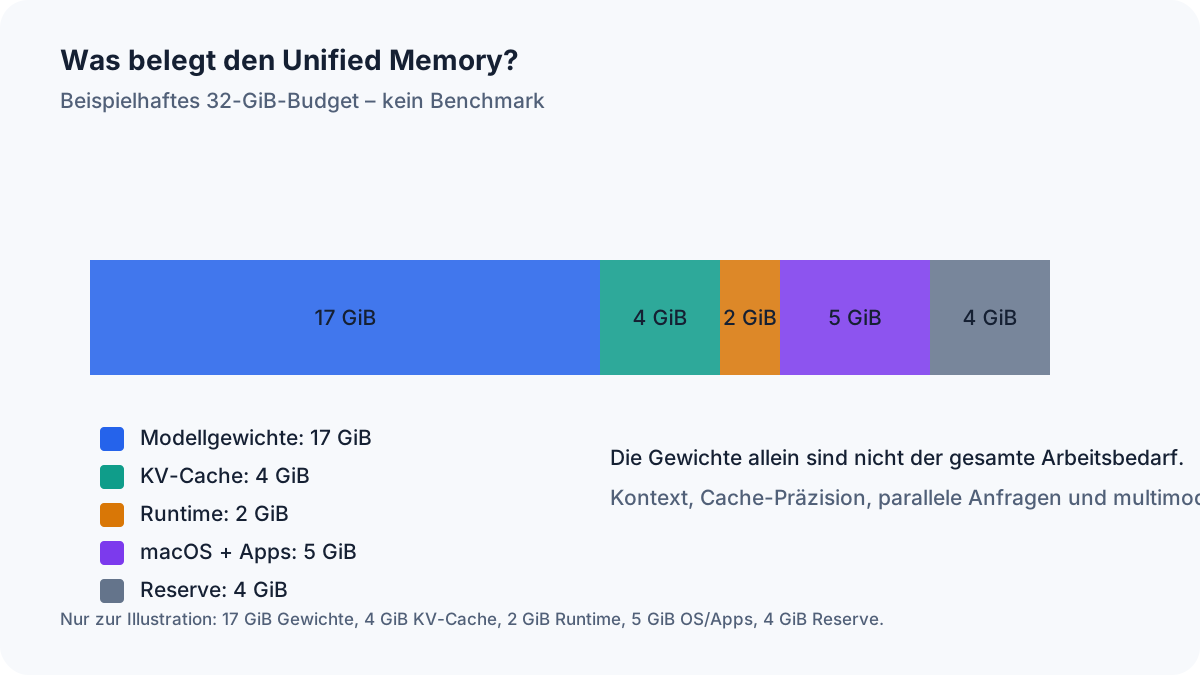
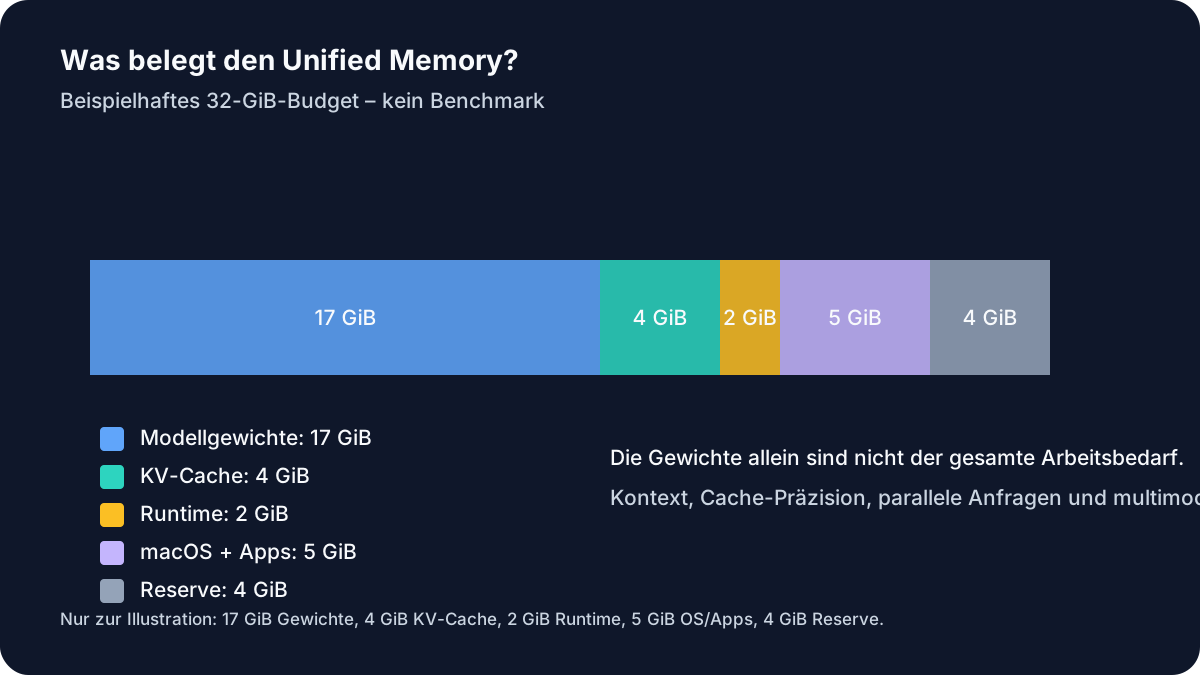
Abbildung 2: Beispielhafte Speicherbestandteile. Annahmen stehen direkt in der Grafik; kein Benchmark.
Modellparameter und Datentypen
Die vereinfachte Grundformel lautet:
Gewichtsspeicher in Byte ≈ Parameterzahl × Bits pro Parameter ÷ 8Für eine Modellgröße in Milliarden Parametern ergibt sich die dezimale Größe besonders einfach:
Gewichtsspeicher in GB ≈ Parameterzahl in Milliarden × Bits ÷ 8Beispiel für ein 8B-Modell in idealen 4 Bit:
8 Milliarden × 4 Bit ÷ 8 = 4 Milliarden Byte = 4,0 GB
4,0 GB ÷ 1,073741824 = 3,73 GiB
GB und GiB
- 1 GB = 1.000.000.000 Byte
- 1 GiB = 1.073.741.824 Byte
Hersteller und Downloadseiten verwenden häufig GB. Betriebssysteme und technische Tools können GiB anzeigen oder die Begriffe uneinheitlich verwenden. Deshalb werden beide Einheiten angegeben.
Theoretische Gewichtsgrößen
| Modellklasse | FP16 | 8 Bit | 6 Bit | 5 Bit | 4 Bit |
|---|---|---|---|---|---|
| 1B | 2.0 GB / 1.9 GiB | 1.0 GB / 0.9 GiB | 0.8 GB / 0.7 GiB | 0.6 GB / 0.6 GiB | 0.5 GB / 0.5 GiB |
| 3B | 6.0 GB / 5.6 GiB | 3.0 GB / 2.8 GiB | 2.2 GB / 2.1 GiB | 1.9 GB / 1.7 GiB | 1.5 GB / 1.4 GiB |
| 8B | 16.0 GB / 14.9 GiB | 8.0 GB / 7.5 GiB | 6.0 GB / 5.6 GiB | 5.0 GB / 4.7 GiB | 4.0 GB / 3.7 GiB |
| 14B | 28.0 GB / 26.1 GiB | 14.0 GB / 13.0 GiB | 10.5 GB / 9.8 GiB | 8.8 GB / 8.1 GiB | 7.0 GB / 6.5 GiB |
| 22B | 44.0 GB / 41.0 GiB | 22.0 GB / 20.5 GiB | 16.5 GB / 15.4 GiB | 13.8 GB / 12.8 GiB | 11.0 GB / 10.2 GiB |
| 32B | 64.0 GB / 59.6 GiB | 32.0 GB / 29.8 GiB | 24.0 GB / 22.4 GiB | 20.0 GB / 18.6 GiB | 16.0 GB / 14.9 GiB |
| 70B | 140.0 GB / 130.4 GiB | 70.0 GB / 65.2 GiB | 52.5 GB / 48.9 GiB | 43.8 GB / 40.7 GiB | 35.0 GB / 32.6 GiB |
| 120B | 240.0 GB / 223.5 GiB | 120.0 GB / 111.8 GiB | 90.0 GB / 83.8 GiB | 75.0 GB / 69.8 GiB | 60.0 GB / 55.9 GiB |
| 405B | 810.0 GB / 754.4 GiB | 405.0 GB / 377.2 GiB | 303.8 GB / 282.9 GiB | 253.1 GB / 235.7 GiB | 202.5 GB / 188.6 GiB |
Diese Tabelle listet mathematische Idealwerte. Eine konkrete GGUF- oder MLX-Datei fällt durch Blockmetadaten, Skalierungswerte und gemischte Quantisierungsmethoden real oft größer aus. Die Inferenz beansprucht zusätzlich KV-Cache, Runtime-Overhead und Systempuffer.
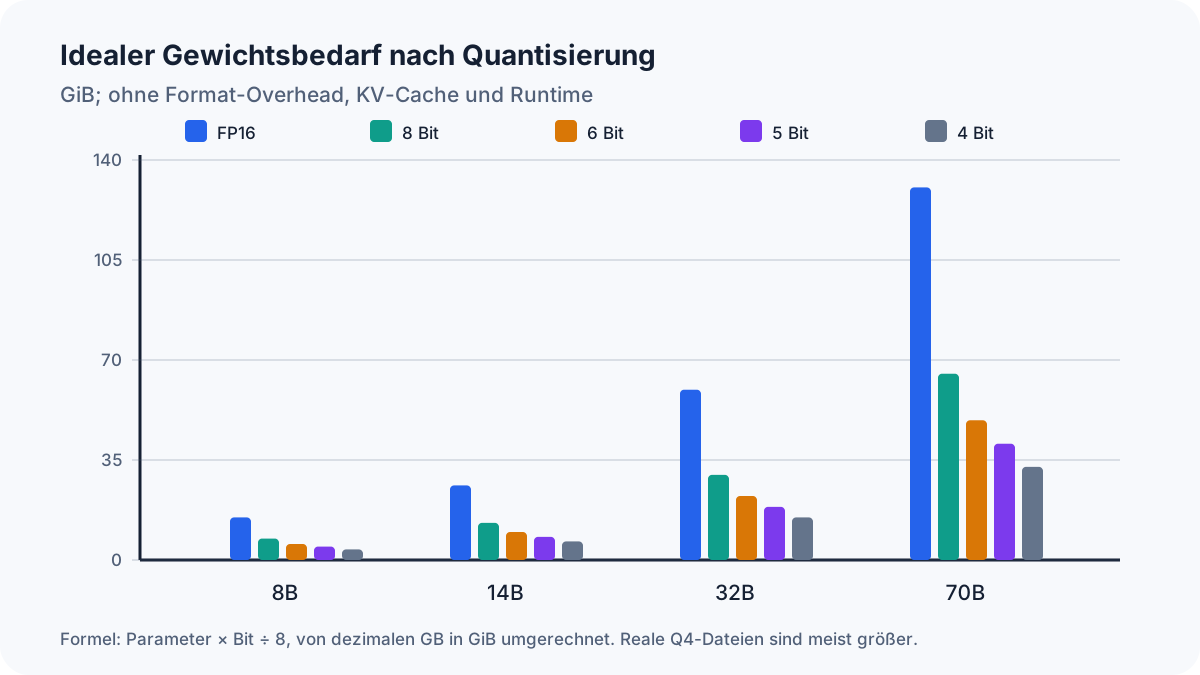
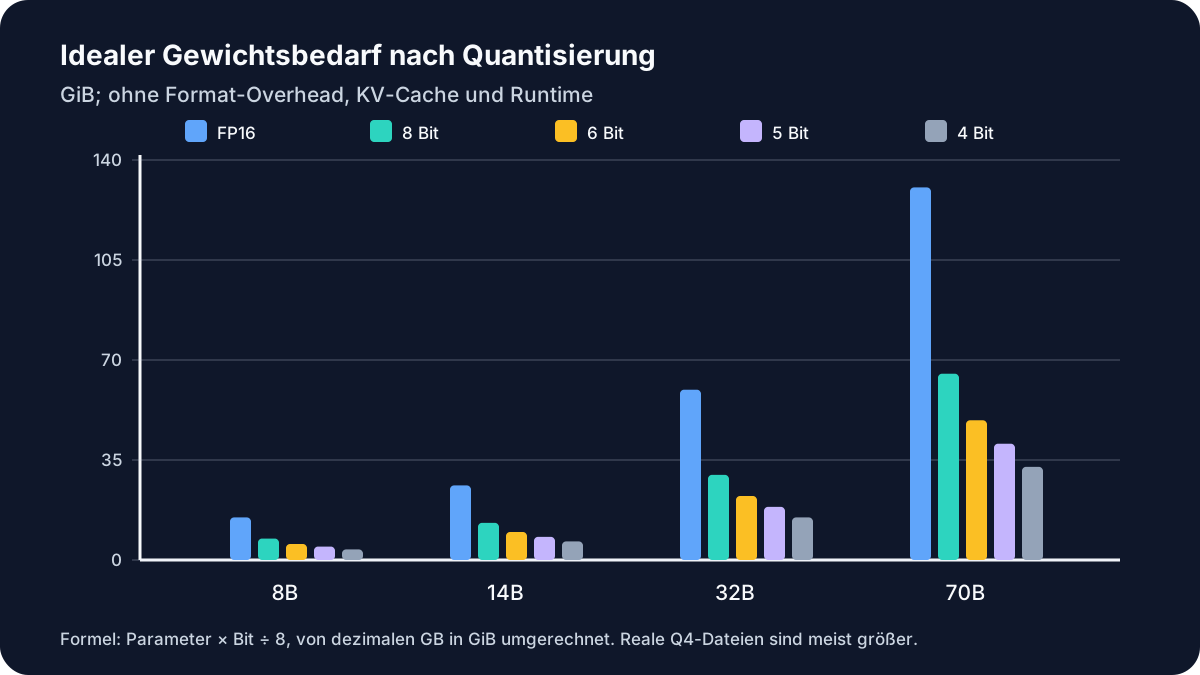
Abbildung 3: Idealwerte nach Parameterzahl und Bitbreite; reale Quantisierungen sind meist größer.
Konkrete Beispielrechnungen
1B-Klasse
- FP16:
1 × 16 / 8 = 2,0 GB = 1,86 GiB - 8 Bit:
1,0 GB = 0,93 GiB - 4 Bit:
0,5 GB = 0,47 GiB
Mit Runtime, kleinem KV-Cache und Systemanteil ist ein 1B-Modell auf 8 GB gut machbar. Die Modellqualität und nicht der Speicher ist hier meist die größere Grenze.
3B-Klasse
- FP16:
6,0 GB = 5,59 GiB - 6 Bit:
2,25 GB = 2,10 GiB - 4 Bit:
1,5 GB = 1,40 GiB
3B in 4 bis 6 Bit ist die realistische Oberklasse für einen 8-GB-Mac, sofern der Kontext kurz bleibt und keine schweren Anwendungen parallel laufen.
7B- bis 8B-Klasse
Für 8B:
- FP16:
16,0 GB = 14,90 GiB - 8 Bit:
8,0 GB = 7,45 GiB - 6 Bit:
6,0 GB = 5,59 GiB - 5 Bit:
5,0 GB = 4,66 GiB - 4 Bit ideal:
4,0 GB = 3,73 GiB - Q4_K_M-Beispiel aus llama.cpp: 4,9 GB reale Datei
Auf 16 GB ist ein 8B-Q4/Q5-Modell mit 4k bis 8k Kontext meist sinnvoll. FP16 lässt praktisch zu wenig Platz für macOS und Cache.
12B- bis 14B-Klasse
Für 14B:
- FP16:
28,0 GB = 26,08 GiB - 8 Bit:
14,0 GB = 13,04 GiB - 6 Bit:
10,5 GB = 9,78 GiB - 5 Bit:
8,75 GB = 8,15 GiB - 4 Bit ideal:
7,0 GB = 6,52 GiB
16 GB können ein 14B-Q4-Modell laden, aber lange Kontexte, Browser und Entwicklungsumgebung machen die Konfiguration schnell eng. 24 GB sind die deutlich robustere Wahl.
20B- bis 24B-Klasse
Für 22B:
- FP16:
44,0 GB = 40,98 GiB - 8 Bit:
22,0 GB = 20,49 GiB - 6 Bit:
16,5 GB = 15,37 GiB - 5 Bit:
13,75 GB = 12,81 GiB - 4 Bit ideal:
11,0 GB = 10,24 GiB
24 GB reichen für Q4 mit begrenztem Kontext. 32 GB erlauben mehr Cache und parallele Anwendungen.
27B- bis 32B-Klasse
Für 32B:
- FP16:
64,0 GB = 59,60 GiB - 8 Bit:
32,0 GB = 29,80 GiB - 6 Bit:
24,0 GB = 22,35 GiB - 5 Bit:
20,0 GB = 18,63 GiB - 4 Bit ideal:
16,0 GB = 14,90 GiB
Ein 32B-Q4-Modell ist auf 32 GB möglich, aber die reale Datei, ein großer KV-Cache und eine IDE können den Speicher aufbrauchen. 36 oder 48 GB sind komfortabler.
70B- bis 72B-Klasse
Für 70B:
- FP16:
140,0 GB = 130,39 GiB - 8 Bit:
70,0 GB = 65,19 GiB - 6 Bit:
52,5 GB = 48,89 GiB - 5 Bit:
43,75 GB = 40,75 GiB - 4 Bit ideal:
35,0 GB = 32,60 GiB - Q4_K_M-Beispiel aus llama.cpp: 43,1 GB reale Datei
Diese Differenz zeigt, warum die Idealformel allein keine Kaufentscheidung tragen darf. Auf 64 GB ist 70B Q4 mit moderatem Kontext realistisch. 48 GB ist in vielen Fällen zu knapp, weil für Cache, Runtime und macOS kaum Reserve bleibt.
Oberhalb von 100B
Für 120B:
- FP16:
240,0 GB = 223,52 GiB - 8 Bit:
120,0 GB = 111,76 GiB - 6 Bit:
90,0 GB = 83,82 GiB - 5 Bit:
75,0 GB = 69,85 GiB - 4 Bit ideal:
60,0 GB = 55,88 GiB
Auf 96 GB ist 120B Q4 denkbar, sofern die reale Quantisierung nicht deutlich größer ist und der Kontext moderat bleibt. 128 GB ist für produktive Nutzung wesentlich plausibler.
Für 405B ergibt die ideale 4-Bit-Rechnung 202,5 GB beziehungsweise 188,6 GiB. Das dokumentierte Q4_K_M-Beispiel ist jedoch 249,1 GB groß. Ein 256-GB-System hätte damit praktisch keine Reserve; 512 GB sind die realistische Klasse.
Der Einfluss des Kontextfensters
Was ist das Kontextfenster?
Das Kontextfenster ist die maximale Zahl von Tokens, die das Modell in einer Anfrage und im bisherigen Dialog berücksichtigen kann. Tokens sind Wortteile, Satzzeichen oder kurze Wörter. Ein beworbenes 128k-Fenster bedeutet nicht, dass 128.000 Tokens auf jeder Hardware schnell oder sinnvoll sind.
KV-Cache-Formel
Für eine klassische Transformer-Architektur mit getrennten Key- und Value-Tensoren kann man näherungsweise rechnen:
KV-Cache-Byte =
Batch × Tokens × Layer × 2 × KV-Heads × Head-Dimension × Byte pro Element
Der Faktor 2 steht für Key und Value.
Beispiel A: mittelgroßes GQA-Modell
Annahmen:
- 32 Layer
- 8 KV-Heads
- Head-Dimension 128
- FP16-KV-Cache: 2 Byte
- Batch 1
pro Token = 32 × 2 × 8 × 128 × 2 Byte
          = 131.072 Byte
          = 128 KiB
Daraus folgen:
- 4k Tokens: 0,5 GiB
- 8k Tokens: 1,0 GiB
- 32k Tokens: 4,0 GiB
- 64k Tokens: 8,0 GiB
- 128k Tokens: 16,0 GiB
Beispiel B: großes GQA-Modell
Annahmen:
- 80 Layer
- 8 KV-Heads
- Head-Dimension 128
- FP16-KV-Cache
- Batch 1
pro Token = 80 × 2 × 8 × 128 × 2 Byte
          = 327.680 Byte
= 320 KiB- 4k Tokens: 1,25 GiB
- 8k Tokens: 2,5 GiB
- 32k Tokens: 10 GiB
- 64k Tokens: 20 GiB
- 128k Tokens: 40 GiB
| Kontext | Beispiel A: 32 Layer, 8 KV-Heads | Beispiel B: 80 Layer, 8 KV-Heads | Praktische Bedeutung |
|---|---|---|---|
| 4k | 0,5 GiB | 1,25 GiB | Kurzer Chat / kleine Dokumente |
| 8k | 1,0 GiB | 2,5 GiB | Normaler Chat und Coding |
| 32k | 4,0 GiB | 10,0 GiB | Große Dokumente / RAG |
| 64k | 8,0 GiB | 20,0 GiB | Agenten- und Repository-Workflows |
| 128k | 16,0 GiB | 40,0 GiB | Nur mit viel Speicher |
Die Werte sind berechnete Architekturbeispiele, keine Messwerte eines bestimmten Produkts. Ein 8-Bit-KV-Cache halbiert den Rohspeicher gegenüber FP16 ungefähr. 4 Bit reduziert ihn weiter, kann aber zusätzliche Metadaten und Qualitäts- oder Geschwindigkeitsfolgen haben. Ollama weist darauf hin, dass größere Kontexte mehr Speicher benötigen und unterstützt bei kompatiblen Backends Flash Attention sowie quantisierte K/V-Caches.
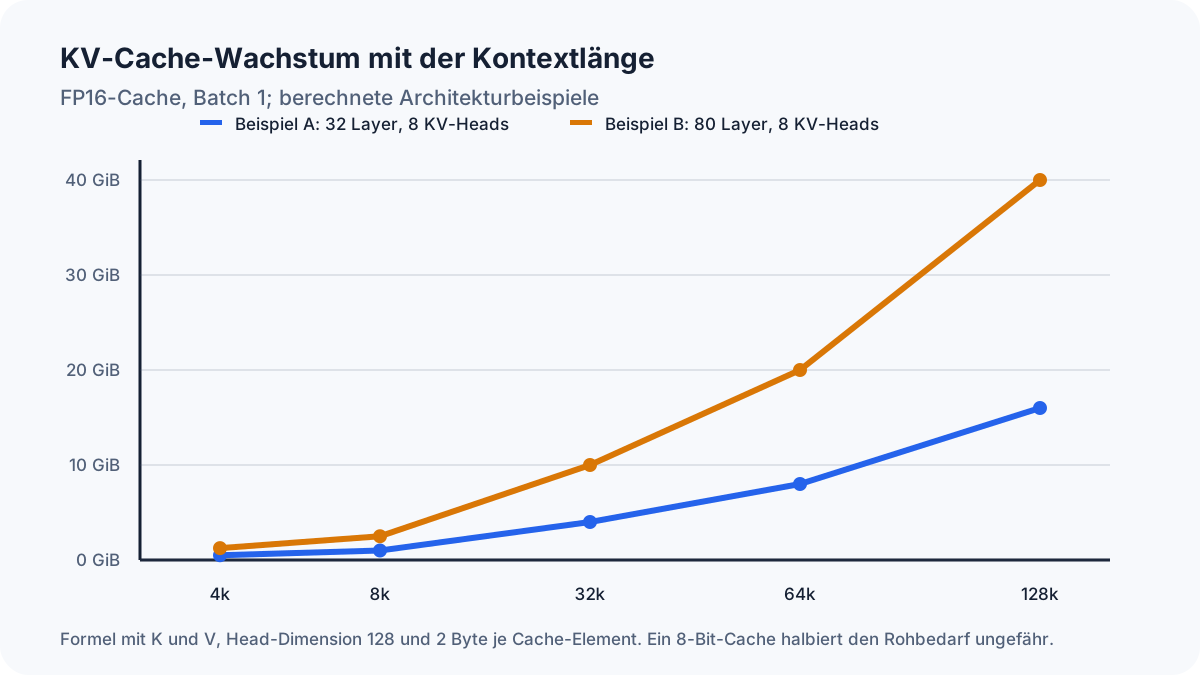
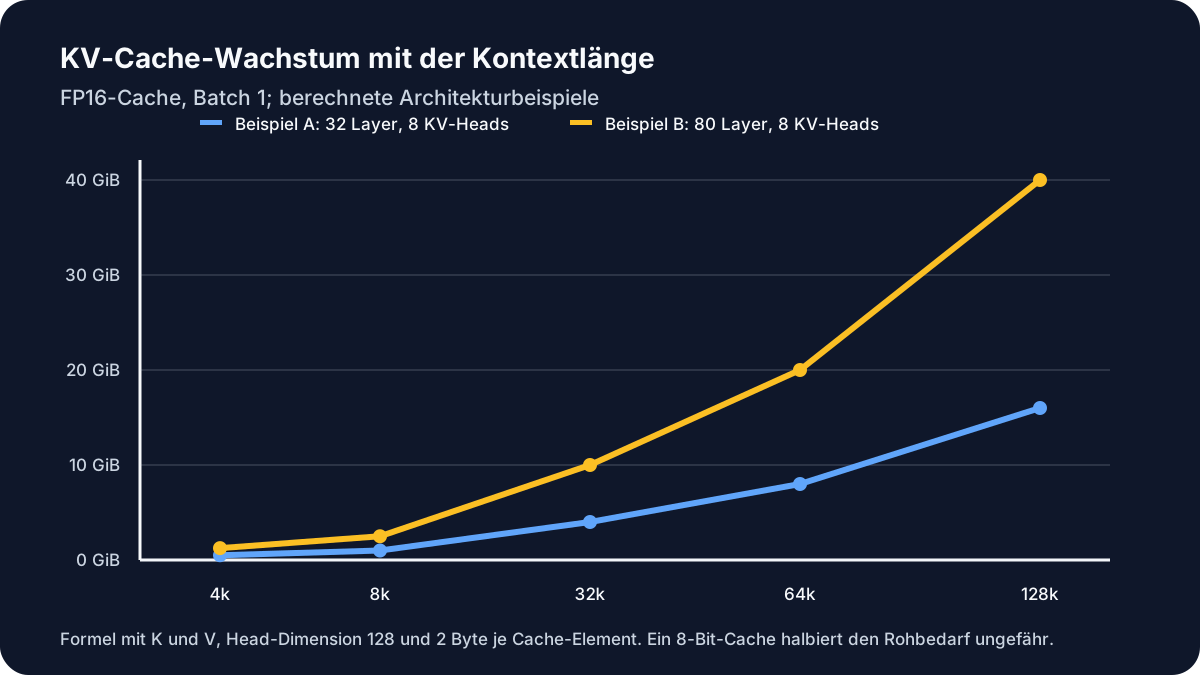
Abbildung 4: Berechnetes KV-Cache-Wachstum bei FP16, Batch 1 und acht KV-Heads.
GQA und MQA
Bei Multi-Head Attention hat jeder Query-Head eigene Key- und Value-Heads. GQA teilt Key/Value-Heads zwischen Gruppen von Query-Heads; MQA nutzt einen gemeinsamen Key- und Value-Head. Dadurch sinkt der KV-Cache deutlich.
Batch-Größe und parallele Nutzer
Batch 2 verdoppelt den Cache in einer einfachen Näherung. Ein lokaler Server mit vier parallelen langen Chats kann daher viel mehr Speicher benötigen als ein einzelner Chat mit demselben Modell.
Empfohlene Modellgrößen nach Unified Memory
| Unified Memory | Realistische Modellklasse | Typischer Kontext | Einordnung | Freie Reserve |
|---|---|---|---|---|
| 8 GB | 1–3B, meist 4 Bit | 2k–4k | Nur Experimente; Browser/IDE schließen | 3–4 GiB |
| 16 GB | 7–8B Q4/Q5; 12–14B Q4 nur knapp | 4k–8k | Chat, Zusammenfassen, leichte Codehilfe | 5–7 GiB |
| 18 GB | 8B Q5/Q6; 12–14B Q4 | 4k–8k | Etwas mehr Reserve als 16 GB | 6–7 GiB |
| 24 GB | 12–14B Q4/Q5; 20–24B Q4 knapp | 8k–16k | Guter Einstieg für lokale KI | 7–9 GiB |
| 32 GB | 20–24B Q4/Q5; 27–32B Q4 | 8k–32k | Entwicklung, RAG, mittlere Modelle | 8–10 GiB |
| 36 GB | 27–32B Q4 komfortabler | 8k–32k | Pro/Max-Konfigurationen mit Reserve | 9–11 GiB |
| 48 GB | 32B Q5/Q6; 70B nur sehr niedrig quantisiert/knapp | 16k–32k | Code, RAG, mehrere Tools | 10–13 GiB |
| 64 GB | 70B Q4 mit moderatem Kontext; 32B höherpräzise | 8k–32k | Große Einzelmodelle, ernsthafte Entwicklung | 12–16 GiB |
| 96 GB | 70B Q5/Q6; ~100–120B Q4 | 16k–64k | Lange Kontexte, multimodal, Forschung | 14–20 GiB |
| 128 GB | 70B Q8 oder 120B Q4/Q5 | 32k–128k modellabhängig | Professionelle lokale Workflows | 16–24 GiB |
| 192 GB | 120B Q8; ~200B Q4; mehrere große Modelle | 32k–128k | Mac Pro/ältere Ultra-Klasse | 20–30 GiB |
| 256 GB | 200–300B Q4; 405B nur niedrigere Bits/knapp | 32k–128k | Sehr große Modelle und Parallelbetrieb | 24–40 GiB |
| 512 GB | 405B Q4 mit Reserve; große MoE- und Mehrmodell-Setups | 64k+ | Extrem große lokale Inferenz | 32–64 GiB |
Die Reservewerte sind Planungsannahmen, keine technischen Limits. Bei einem reinen Headless-Server kann die Reserve geringer sein; bei Xcode, Docker, Browser und RAG-Datenbank sollte sie höher ausfallen.
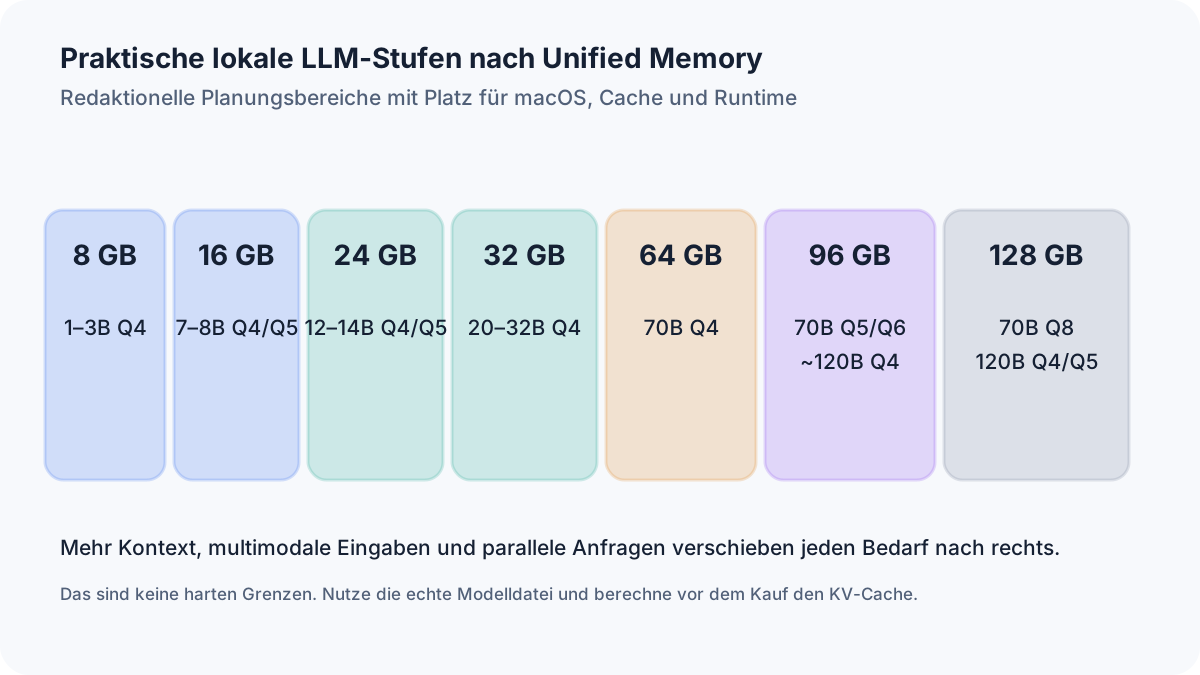
Abbildung 5: Planungsbereiche, keine harten Kompatibilitätsgrenzen.
Empfehlungen nach Anwendungsfall
| Anwendungsfall | Sinnvolle Speicherausstattung | Typische Modellklasse | Warum |
|---|---|---|---|
| Gelegentliches Chatten | 16–24 GB | 7B–14B Q4/Q5 | Kurzer Kontext, eine Instanz |
| Zusammenfassungen | 24–32 GB | 14B–24B Q4 | Dokumente erhöhen Kontextbedarf |
| Programmierassistent | 32–64 GB | 14B–32B, ggf. 70B Q4 | Repository-Kontext und IDE laufen parallel |
| RAG | 32–64 GB | 14B–32B | Modell, Embeddings, Vektordatenbank und Dokumente |
| Lange Dokumente | 64–128 GB | 32B–70B | KV-Cache wird zum Hauptfaktor |
| Lokale Agenten | 48–128 GB | 24B–70B | Lange Historie, Tools, mehrere Prozesse |
| Multimodal/Bildverständnis | 32–96 GB | 12B–32B plus Vision-Komponenten | Encoder und Bildtokens benötigen Zusatzspeicher |
| Mehrere Modelle | 96 GB aufwärts | Zwei oder mehr 14B–70B | Gewichte und Caches addieren sich |
| Forschung/Entwicklung | 128–512 GB | 70B bis mehrere hundert B | Hohe Präzision, lange Kontexte, Parallelität |
Reale Mac-Klassen im Jahr 2026
MacBook Air
Apples MacBook-Air-Spezifikationen listen für die aktuelle M5-Generation 16 GB Unified Memory als Standard, konfigurierbar auf 24 GB oder 32 GB; die Speicherbandbreite gibt Apple mit 153 GB/s an. Der Air ist lüfterlos. Für 7B bis 14B ist er gut geeignet; 20B bis 24B in 4 Bit ist auf 24 oder 32 GB möglich, aber längere Dauerlast kann wegen passiver Kühlung weniger konstant sein als auf aktiv gekühlten Macs.
MacBook Pro
Die MacBook-Pro-Spezifikationsseite führt das aktuelle 14- und 16-Zoll-Lineup mit M5, M5 Pro und M5 Max auf. Apple nennt 307 GB/s Speicherbandbreite für M5 Pro und bis zu 614 GB/s für M5 Max; 128 GB Unified Memory werden für das M5-Max-40-Core-GPU-Topmodell als Konfigurationsoption gelistet. Damit können zwei MacBook-Pro-Modelle mit gleicher Speichermenge bei LLMs deutlich unterschiedliche Tokenraten erreichen.
Mac mini
Apples Mac-mini-Spezifikationen (Stand Oktober 2026) beschreiben das aktuelle Lineup mit M6 oder M5 Pro. Der M6 kommt mit 16 GB Unified Memory, konfigurierbar bis 32 GB, und 170 GB/s Speicherbandbreite. Der M5 Pro startet bei 24 GB, geht bis 64 GB und erreicht 307 GB/s. Für 20B- bis 32B-Klassen ist der M5 Pro deutlich interessanter, weil Kapazität und Bandbreite zusammen zählen.
Mac Studio
Apples Mac-Studio-Spezifikationen (Stand Oktober 2026) führen die aktuelle Generation mit M5 Max und M5 Ultra. Der M5 Max liefert 460 GB/s (32-Core-GPU) oder 614 GB/s (40-Core-GPU) und 36 bis 128 GB Unified Memory. Der M5 Ultra erreicht 1,2 TB/s und wird mit 96 GB bis 512 GB Unified Memory angeboten. Damit bleibt der Mac Studio die einzige Mac-Plattform für Modelle im Bereich mehrerer hundert Milliarden Parameter.
Mac Pro
Der aktuelle Apple-Silicon-Mac-Pro nutzt laut Apple-Support-Dokument 111343 den M2 Ultra mit 800 GB/s Speicherbandbreite und bis zu 192 GB Unified Memory. Für reine lokale LLM-Inferenz ist der Mac Studio mit neuerem Ultra-Chip und höherer Maximalkapazität häufig die logischere Klasse; der Mac Pro richtet sich zusätzlich an Workflows, die PCIe-Erweiterung benötigen.
Warum gleiche Speichermenge nicht gleiche Leistung bedeutet
Die Geschwindigkeit hängt ab von:
- Speicherbandbreite;
- GPU-Kernzahl und GPU-Architektur;
- thermischer Kühlung;
- Runtime und Kernelqualität;
- Quantisierungsformat;
- Modellarchitektur;
- Promptlänge;
- Ausgabelänge;
- Cache-Datentyp;
- parallelen Prozessen.
Ein 64-GB-Mac mit Max-Chip kann ein speicherbandbreitenlimitiertes Modell deutlich schneller dekodieren als ein 64-GB-System mit niedrigerer Bandbreite, sofern beide Konfigurationen existieren beziehungsweise verglichen werden.
Welche Modelle passen ungefähr auf welchen Mac?
| Arbeitsbudget für das Modell | Modellklasse | Quantisierung | Kontext | Realistische Bewertung |
|---|---|---|---|---|
| 2–4 GiB | 1B–3B | Q4–Q8 | 2k–8k | Komfortabel auf 8 GB |
| 5–9 GiB | 7B–8B | Q4–Q6 | 4k–16k | Gut auf 16 GB |
| 8–15 GiB | 12B–14B | Q4–Q6 | 8k–32k | Gut auf 24 GB |
| 14–24 GiB | 20B–32B | Q4–Q5 | 8k–32k | 32–48 GB |
| 40–52 GiB | 70B | Q4–Q5 | 8k–32k | 64 GB knapp bis gut; 96 GB komfortabler |
| 60–90 GiB | 100B–120B | Q4–Q6 | 16k–64k | 96–128 GB |
| 120–220 GiB | 200B–400B | niedrige bis mittlere Bits | modellabhängig | 192–512 GB |
| ca. 232 GiB reale Datei | 405B Q4_K_M-Beispiel | Q4_K_M | Zusatzspeicher nötig | 512 GB empfohlen |
Ollama, LM Studio, MLX und llama.cpp
| Runtime | Typisches Format | Mac-Beschleunigung | Speichersteuerung | Geeignet für |
|---|---|---|---|---|
| Ollama | meist GGUF-basierte Modelle im eigenen Modellmanagement | Metal über Backend | Kontext, Flash Attention, KV-Cache-Quantisierung je nach Support | Einfache CLI/API und lokale Dienste |
| LM Studio | GGUF und eigene Engines/Modelle | GPU-Offload auf Apple Silicon | Kontextlänge, Offload, Lade-/Entladeverwaltung | GUI, Modellvergleich, lokaler API-Server |
| MLX-LM | MLX/Safetensors-Modelle | nativ für Apple Silicon und Unified Memory | Quantisierung, rotierender KV-Cache, Prompt-Cache | Python, Forschung, Apple-spezifische Optimierung |
| llama.cpp | GGUF | Metal standardmäßig verfügbar beim passenden Build | GPU-Layer, Kontext, Cache-Typen, mmap/mlock | maximale Kontrolle, CLI und Server |
GGUF
GGUF ist ein Container für Tensoren und Metadaten. Die Dateigröße ist ein guter Ausgangspunkt für die Gewichte, aber nicht der gesamte Laufzeitspeicher.
MLX-Modelle
MLX ist um das Unified-Memory-Modell von Apple Silicon gebaut. MLX-LM bietet Quantisierung, Prompt-Caching und einen rotierenden KV-Cache. Ein kleiner max-kv-size spart Speicher, kann aber Qualität kosten, weil ältere Cache-Einträge verworfen werden.
Metal und GPU-Offloading
llama.cpp aktiviert Metal auf macOS beim entsprechenden Build standardmäßig; GPU-Inferenz kann auch deaktiviert oder über Layersteuerung beeinflusst werden. LM Studio bietet beim Laden eine GPU-Offload-Konfiguration und nennt als Systemanforderung aktuell 16 GB Unified Memory oder mehr unter macOS, während 8-GB-Macs auf kleine Modelle und bescheidene Kontexte verwiesen werden.
Memory Mapping
llama.cpp kann GGUF-Dateien per mmap abbilden. Das verbessert typischerweise Ladeverhalten und überlässt Seitenverwaltung dem Betriebssystem. Es verwandelt die SSD jedoch nicht in schnellen Unified Memory: Werden Modellseiten ständig ein- und ausgelagert, leidet die interaktive Leistung.
Keine pauschale Rangliste
Keine Runtime ist für jedes Modell, jede Version und jeden Mac stets schneller oder sparsamer. Ein fairer Vergleich benötigt:
- exakt dieselbe Modellversion;
- dasselbe Quantisierungsformat;
- gleiche Kontextlänge;
- gleiche Prompt- und Ausgabetokens;
- gleiche Cache-Präzision;
- dokumentierte Runtime-Version;
- mehrere Wiederholungen nach Warm-up.
Swap und Speicherkomprimierung
macOS komprimiert inaktive Speicherseiten, wenn der Druck steigt. Reicht der physische Speicher nicht, werden Seiten auf das Startvolume ausgelagert. Die Aktivitätsanzeige zeigt Speicherbelastung, komprimierten Speicher und Swap-Nutzung.
Swap kann helfen, dass ein Modell lädt. Er ist aber kein gleichwertiger Ersatz für Unified Memory:
- SSD-Latenz und Bandbreite sind für wiederholte LLM-Zugriffe schlechter;
- Time to First Token kann stark steigen;
- Tokenrate kann einbrechen, wenn aktive Gewichte oder Cache-Seiten wechseln;
- parallele Anwendungen reagieren träger;
- der nutzbare Kontext wird unberechenbarer.
Permanenter Swap verursacht zusätzliche SSD-Schreibvorgänge. Daraus folgt nicht automatisch ein kurzfristiger SSD-Ausfall; alarmistische Lebensdauerprognosen ohne Messdaten sind nicht seriös. Praktisch entscheidend ist die schlechte und schwankende Leistung.
Inferenzgeschwindigkeit: Speicherbandbreite bestimmt den Token-Durchsatz
Time to First Token
Zeit vom Absenden bis zum ersten Ausgabetoken. Sie enthält Modellladen, Promptverarbeitung und Initialisierung.
Prefill oder Prompt Processing
Das Modell verarbeitet den vollständigen Prompt. Lange Dokumente belasten Rechenleistung und Speicher stärker als ein kurzer Chat.
Decode oder Tokens pro Sekunde
Nach dem ersten Token wird autoregressiv generiert. Bei großen quantisierten Modellen auf Apple Silicon ist Decode häufig stark von Speicherbandbreite abhängig.
Thermik
Ein MacBook Air hat keinen Lüfter. Bei langen Läufen kann die nachhaltige Leistung anders ausfallen als bei MacBook Pro, Mac mini oder Mac Studio.
Ein Modell kann passen und trotzdem langsam sein
Ein 70B-Q4-Modell kann in 64 GB passen. Auf einem Chip mit geringerer Speicherbandbreite kann es dennoch nur eine niedrige Tokenrate liefern. Mehr Speicher entscheidet über Machbarkeit; Chip und Bandbreite entscheiden wesentlich über Tempo.
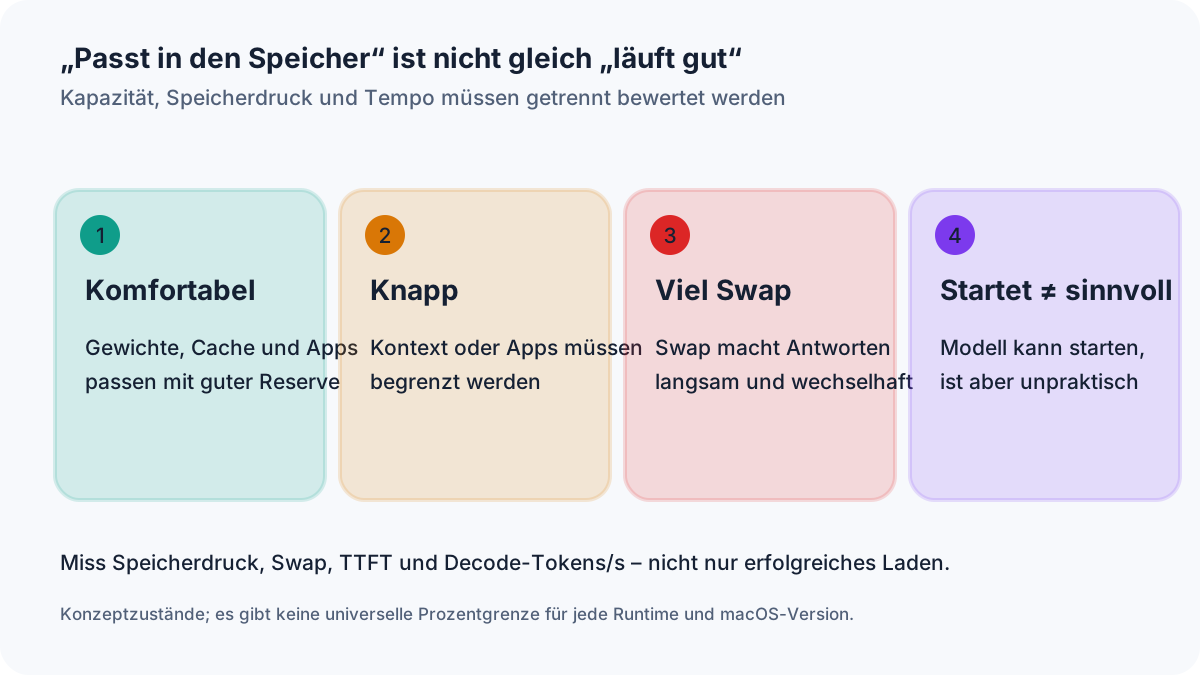
Abbildung 6: Ein Modellstart ist nicht gleichbedeutend mit guter Nutzbarkeit.
Kaufberatung
Reichen 16 GB für lokale LLMs?
Ja, für 7B bis 8B in Q4/Q5 und kurze bis mittlere Kontexte. Für 14B, lange Dokumente, RAG oder eine schwere IDE ist 16 GB knapp. Wer einen Mac neu kauft und lokale KI ernsthaft nutzen will, sollte 24 oder 32 GB wählen.
24 GB oder 32 GB?
24 GB sind ein guter Einstieg für 12B bis 14B. 32 GB erweitern den sinnvollen Bereich auf 20B bis 32B in niedriger Quantisierung und geben deutlich mehr Reserve für Kontext, Browser und Entwicklungswerkzeuge. Bei nicht aufrüstbarem Speicher ist 32 GB die langlebigere Wahl.
Wann lohnen sich 48 oder 64 GB?
48 GB lohnen sich für 32B-Modelle, RAG, lokale Agenten und parallele Tools. Bei 64 GB muss ein konkretes 70B-Q4-Modell mit dem benötigten Kontext separat gerechnet und getestet werden. Für regelmäßige 70B-Nutzung und längeren Kontext sind 96 GB die robustere Planung.
Braucht man 96 oder 128 GB?
Nicht für normales Chatten. Sie sind sinnvoll für:
- 70B mit höherer Präzision;
- 100B- bis 120B-Klasse;
- 32k bis 128k Kontext;
- mehrere Modelle;
- multimodale Systeme;
- Forschung und lokale Server.
Mehr Speicher oder stärkerer Chip?
Zuerst muss das Modell passen. Ein schnellerer Chip mit zu wenig Speicher kann das gewünschte Modell gar nicht sinnvoll ausführen. Wenn beide Konfigurationen das Modell mit Reserve tragen, bringt der stärkere Chip beziehungsweise die höhere Speicherbandbreite den größeren Geschwindigkeitsgewinn.
Praktische Reihenfolge:
- gewünschte Modellklasse und Kontext bestimmen;
- erforderlichen Unified Memory mit Reserve wählen;
- innerhalb dieser Speicherklasse den stärksten sinnvollen Chip kaufen.
Empfehlungen nach Nutzergruppe
- Studierende und Einsteiger: 24 GB; 32 GB bei Programmierung und längerer Nutzung.
- Entwickler: 32 bis 64 GB, abhängig von Docker, IDE, RAG und Modellgröße.
- Professionelle lokale KI: 64 bis 128 GB.
- Forschung, große Modelle, Server: 128 bis 512 GB.
Unified Memory ist bei den meisten aktuellen Macs nach dem Kauf nicht aufrüstbar. Eine kleine Reserve ist deshalb wertvoller als eine Konfiguration, die heute bereits am Limit liegt.
Häufige Fehler und Missverständnisse
„Ein 7B-Modell braucht exakt 7 GB.“
Falsch. 7B bezeichnet Parameter, nicht Byte. In FP16 wären es theoretisch 14 GB; in idealen 4 Bit 3,5 GB, zuzüglich Overhead.
„4 Bit ist exakt halb so groß wie 8 Bit.“
Nur in der Idealformel. Reale Formate enthalten Skalierungen, Metadaten und gemischte Tensoren.
„Eine 10-GB-Datei braucht 10 GB Unified Memory.“
Die Datei deckt vor allem Gewichte ab. KV-Cache, Runtime, temporäre Buffer und System fehlen.
„Der gesamte Unified Memory steht dem Modell zur Verfügung.“
Nein. macOS und andere Anwendungen nutzen denselben Pool.
„Mehr Kontext ist immer besser.“
Ein expandierter Kontext kostet signifikant Speicher sowie Prefill-Rechenzeit. Bei extrem langen Prompts sinkt die Antwortqualität erfahrungsgemäß trotz beworbener theoretischer Maximalgröße.
„Swap ersetzt fehlenden RAM.“
Swap kann das Starten ermöglichen, aber nicht dieselbe Leistung liefern.
„Mehr Parameter bedeutet automatisch besser.“
Architektur, Training, Daten, Post-Training, Quantisierung und Aufgabe sind ebenso wichtig.
„Alle 4-Bit-Quantisierungen sind gleich.“
Sie unterscheiden sich in Bits pro Weight, Skalierung, Mischpräzision, Qualität und Kernelunterstützung.
„Wenn es startet, läuft es gut.“
Startfähigkeit sagt wenig über TTFT, Tokenrate und Stabilität aus.
„RAM bestimmt allein die Geschwindigkeit.“
Speicherbandbreite, GPU, Runtime, Promptlänge und Thermik sind ebenfalls zentral.
Praktische Checkliste
- Parameterzahl und Architektur prüfen.
- Quantisierungsformat und reale Dateigröße prüfen.
- Gewünschte Kontextlänge festlegen.
- KV-Cache mit Layern, KV-Heads und Datentyp abschätzen.
- Runtime-Overhead einplanen.
- Speicher für macOS und andere Programme reservieren.
- Reale Benchmarks für exakt den eigenen Mac und dieselbe Runtime suchen.
- Zunächst kleinere Quantisierung und kürzeren Kontext testen.
- Aktivitätsanzeige: Speicherbelastung, Kompression und Swap beobachten.
- Time to First Token, Prompt-Tokens/s und Decode-Tokens/s getrennt messen.
Praktische Grenzen
- Die reale Modelldatei ist wichtiger als die reine 4-Bit-Idealrechnung.
- Der KV-Cache kann bei 32k bis 128k Kontext viele oder sogar mehrere Dutzend GiB beanspruchen.
- 24 bis 32 GB sind der beste allgemeine Einstieg; 64 GB können für einzelne 70B-Q4-Quantisierungen mit begrenztem Kontext reichen; eine generelle Praxistauglichkeit folgt daraus nicht.
- Speicher entscheidet, ob ein Modell sinnvoll passt; Bandbreite und Chip bestimmen wesentlich das Tempo.
- Für einen Neukauf sollte mindestens 20 bis 30 Prozent Arbeitsreserve gegenüber dem geplanten Normalfall eingeplant werden.
Praxisprüfung vor dem RAM-Upgrade
Für eine Kaufentscheidung reichen Parameterzahl und Modell-Dateigröße nicht aus. Notiere die tatsächlich genutzte Quantisierung, Kontextlänge und KV-Cache-Präzision, beobachte den Speicherdruck in macOS und prüfe, ob Swap benutzt wird. Miss zusätzlich Time-to-First-Token und die Ausgaberate auf der konkreten Hardware. Dass ein Modell einmal startet, ist noch kein Praxistest.
Fazit: 24 oder 32 GB als sinnvolle Basis
Für die meisten Mac-Nutzer, die lokale KI ernsthaft ausprobieren möchten, sind 24 oder 32 GB Unified Memory die sinnvollste Basiskonfiguration. 16 GB funktionieren für kleine Modelle, begrenzen aber Modellgröße, Kontext und parallele Anwendungen. 48 GB sind stark für 32B-Modelle und Entwicklerworkflows. 64 GB ermöglichen unter Umständen ein 70B-Q4-Modell mit kurzem bis moderatem Kontext, sind dafür aber keine pauschale Empfehlung. 96 oder 128 GB geben für Cache, andere Programme und längere Kontexte wesentlich mehr Reserve.
Wer sehr große Modelle lokal betreiben will, muss neben reiner Kapazität stets die Durchsatzrate einkalkulieren: Ein Mac Studio mit Ultra-Chip kombiniert hunderte Gigabyte Unified Memory mit extrem hoher Speicherbandbreite. Ein Modell, das in 256 GB theoretisch hineinpasst, benötigt in der Praxis häufig 512 GB, sobald reale Quantisierung, KV-Cache und Systemreserve berücksichtigt werden.
Weiterlesen
- Mac AI Matchmaker: Speicherbedarf und passende Hardware berechnen
- Die besten Open-Weight-LLMs für deinen Mac
- Ollama auf dem Mac mini M4 einrichten
- LM Studio vs. Ollama auf dem Mac
- Alle Mac-Hardwareprofile vergleichen
Quellen
Häufig gestellte Fragen
Welche neuen lokalen Modelle passen auf welchen Mac (Oktober 2026)?
Bei Q4 mit Ollama: 16 GB reichen für Qwen 3.5 9B und Gemma 4 12B. 24 GB reichen für gpt-oss 20B und, nur mit kurzem Kontext, für Qwen 3.8 27B oder Meta Muse Glimmer 30B (beide August 2026); mit 32–36 GB laufen beide mit 32K Kontext. gpt-oss 120B braucht 96 GB oder mehr. Stand: 4. Oktober 2026.
Wie viel RAM braucht ein 7B-LLM auf dem Mac?
Ein 7B-LLM benötigt theoretisch etwa 14 GB in FP16, 7 GB bei 8 Bit und 3,5 GB bei idealen 4 Bit. Realistische Q4-Dateien sind wegen Metadaten und Mischpräzision größer. Für macOS, KV-Cache und Runtime sind 16 GB Unified Memory die sinnvolle Untergrenze.
Wie viel RAM braucht ein 13B- oder 14B-Modell?
Ein 14B-Modell benötigt theoretisch 28 GB in FP16, 14 GB bei 8 Bit und 7 GB bei idealen 4 Bit. Praktisch sind 24 GB Unified Memory für Q4/Q5 deutlich empfehlenswerter als 16 GB.
Kann ein 70B-Modell auf einem Mac laufen?
Möglich. Ein dokumentiertes 70B-Q4_K_M-Beispiel ist etwa 43,1 GB groß, aber Runtime, KV-Cache, temporäre Puffer und macOS kommen hinzu. 64 GB können bei begrenztem Kontext ausreichen, sind keine pauschale Garantie; 96 GB bieten mehr Reserve.
Reichen 16 GB Unified Memory für Ollama?
Für 7B- bis 8B-Modelle in Q4 oder Q5 und moderate Kontexte meist ja. Für 14B, lange Dokumente, RAG oder parallele Entwicklungswerkzeuge sind 16 GB schnell zu knapp.
Sind 24 GB genug für lokale KI?
Für 12B- bis 14B-Modelle und viele alltägliche Aufgaben ja. 20B- bis 24B-Modelle sind in 4 Bit möglich, aber Kontext und parallele Anwendungen müssen begrenzt werden.
Wie viel Unified Memory sollte ein Mac für lokale LLMs haben?
24 bis 32 GB sind der beste allgemeine Einstieg. 48 bis 64 GB eignen sich für größere Modelle und Entwicklerworkflows. 96 bis 128 GB sind für 70B mit höherer Präzision, lange Kontexte oder mehrere Modelle sinnvoll.
Warum braucht ein LLM mehr Speicher als die Modelldatei groß ist?
Zusätzlich zu den Gewichten benötigt die Inferenz KV-Cache, Runtime-Buffer, temporäre Tensoren und Speicher für macOS sowie andere Programme.
Wie stark erhöht ein längeres Kontextfenster den RAM-Verbrauch?
Der KV-Cache wächst bei einer normalen Transformer-Architektur ungefähr linear mit der Tokenzahl. In den Beispielrechnungen benötigt ein großes GQA-Modell etwa 2,5 GiB bei 8k und 20 GiB bei 64k Tokens.
Was passiert, wenn der Unified Memory nicht ausreicht?
macOS komprimiert Speicher und verwendet Swap. Das Modell kann trotzdem starten, aber Time to First Token, Tokenrate und Reaktionsfähigkeit können stark einbrechen. Bei harten Allokationsgrenzen kann das Laden scheitern.
Kann macOS Swap für lokale LLMs nutzen?
Ja. Swap kann inaktive Speicherseiten auf die SSD auslagern. Er ist jedoch kein gleichwertiger Ersatz für Unified Memory und führt bei aktivem Page-Churn häufig zu sehr schlechter Leistung.
Was ist besser: mehr RAM oder ein stärkerer Apple-Chip?
Zuerst muss die geplante Modellklasse mit Reserve in den Speicher passen. Danach ist ein stärkerer Chip mit höherer Speicherbandbreite für Geschwindigkeit wichtiger.
Kann man den Unified Memory eines Macs später erweitern?
Bei den meisten aktuellen Apple-Silicon-Macs ist der Unified Memory Bestandteil des Chip-Pakets und nach dem Kauf nicht aufrüstbar.
Welche Quantisierung eignet sich für einen Mac?
Q4 und Q5 sind häufig gute Ausgangspunkte. Q6 oder Q8 erhöhen Qualität und Speicherbedarf. Q2 oder Q3 sparen mehr Speicher, können aber deutlicher Qualität verlieren. Das konkrete Format und die Runtime-Unterstützung müssen geprüft werden.
Wie sehe ich den Speicherverbrauch eines lokalen Modells?
In der macOS-Aktivitätsanzeige unter Speicher lassen sich Speicherbelastung, App-Speicher, komprimierter Speicher und Swap beobachten. Runtime-Logs können zusätzlich Gewicht-, Cache- und Offload-Größen melden.
Brauchen multimodale Modelle mehr RAM?
Meist ja. Vision- oder Audio-Encoder, Projektoren, Bildtokens und zusätzliche Arbeitsbereiche kommen zum Sprachmodell hinzu.
Reichen 32 GB für lokale LLMs auf dem Mac?
Für die meisten Workflows ja: 32 bis 36 GB tragen 20B- bis 32B-Modelle in 4 Bit und sind brauchbar für Entwicklung und RAG. Ein 70B-Modell in guter 4-Bit-Quantisierung braucht 64 GB.