Geprüft am 11. Oktober 2026. Auf Macs mit 8 oder 16 GB zuerst Gemma 4 E2B/E4B statt eines großen Modells mit maximalem Kontext ausprobieren. Bei 24 GB ist Gemma 4 12B (7,7–8,0 GB Ollama-Paket je nach Variante) der robustere erste Test. Qwen3.8-27B benötigt als Ollama-Paket 18 GB und ist für lange Agentenläufe eher ab 32 GB Unified Memory sinnvoll. Auf manchen 24-GB-Macs kann es starten; dann bleiben aber nur geringe Reserven für macOS, KV-Cache und weitere Apps. Llama 4 Scout (ca. 67 GB Paketgröße) bleibt ein Sonderfall für sehr große Systeme. Downloadgröße ist keine RAM-Messung. Ollama Qwen3.8 · Ollama Gemma 4.
Wenn die Modellwahl auch einen Neukauf betrifft, hilft der MacBook-KI-Entwicklungsguide 2026 bei der Hardwareentscheidung.
Auswahl nach Unified Memory
| Unified Memory des Mac | Sinnvoller Startpunkt | Was du nicht versprechen solltest |
|---|---|---|
| 8 GB | Gemma 4 E2B oder ein kleinerer Tag | kein großer Kontext und keine komfortable Parallel-Nutzung |
| 16 GB | Gemma 4 E2B/E4B, kleinere Qwen-Tags | große Agentenläufe sind speicherempfindlich |
| 24 GB | Gemma 4 12B; 27B nur als Experiment mit kurzem Kontext | 18-GB-Paket lässt kaum Reserve für 27B-Agentenläufe |
| 32 GB | Qwen3.8-27B oder Gemma 4 26B mit begrenztem Kontext | Qwen3.6 35B (23–24 GB Paket) lässt wenig Reserve |
| 48 GB | Gemma 4 31B oder Qwen3.6 35B mit zusätzlicher Reserve | 256K Kontext kann trotzdem zu viel sein |
| 64 GB+ | größere lokale Varianten gezielt testen | Llama 4 Scout bleibt ein Spezialfall |
Das sind Startpunkte, keine Performance-Garantien. Für einen Kaufentscheid solltest du ein konkretes Modell mit deinem eigenen Prompt, Kontext und Tool-Workflow testen.
Ollama-Tags: Paketgrößen statt RAM-Benchmarks
Die folgende Tabelle gibt die am 11. Oktober 2026 auf den offiziellen Ollama-Modellseiten angezeigten Paketgrößen und Variantenbereiche wieder. Das sind Download-/Modellpaket-Angaben, keine lokal gemessenen RAM-Spitzenwerte oder Benchmarkdaten. Bereiche entstehen durch verschiedene angebotene Quantisierungen bzw. Dateien. Beim nächsten Pull können sie sich ändern:
| Familie/Tag | Ollama-Anzeige | Kontext laut Ollama | Eingabe |
|---|---|---|---|
qwen3.6:27b | 18–19 GB | 256K | Text, Bild |
qwen3.6:35b | 23–24 GB | 256K | Text, Bild |
qwen3.6:27b-mlx | 19 GB | 256K | Text, Bild |
qwen3.6:35b-mlx | 24 GB | 256K | Text, Bild |
qwen3.8:27b | 18 GB | 256K | Text, Bild |
gemma4:e2b | 4,6–7,5 GB | 128K | Text, Bild |
gemma4:e4b | 6,6–9,5 GB | 128K | Text, Bild |
gemma4:12b | 7,7–8,0 GB | 256K | Text, Bild |
gemma4:26b | 16–19 GB | 256K | Text, Bild |
gemma4:31b | 19–20 GB | 256K | Text, Bild |
llama4:16x17b | 67 GB | 10M | Text, Bild |
Die Zahlen bezeichnen Paketgrößen je Ollama-Tag, nicht den RAM-Bedarf bei 256K Kontext. Die Bibliotheksseiten nennen für Qwen3.6 auch eigenständige MLX-Varianten; deren Größen sind separat ausgewiesen. Prüfe bei einer Installation die konkrete Variante mit ollama show <modell> und während des Laufens die tatsächliche Belegung mit ollama ps und der macOS-Aktivitätsanzeige. Qwen3.6 · Qwen3.8 · Gemma 4 · Llama 4.
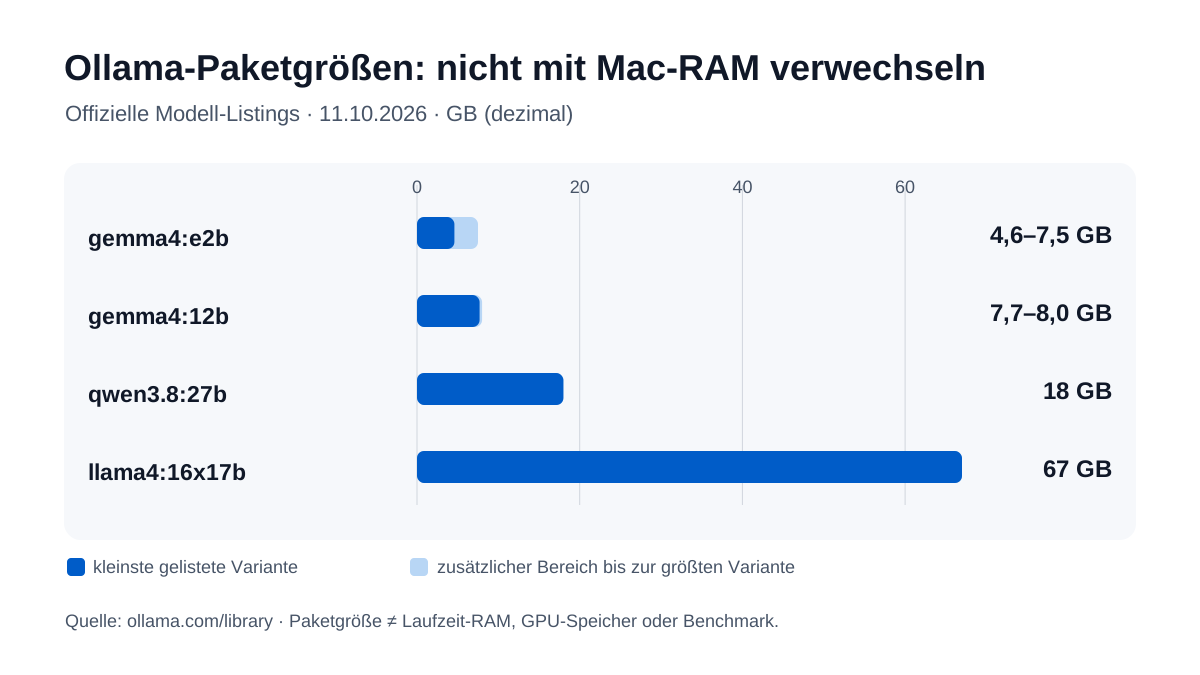
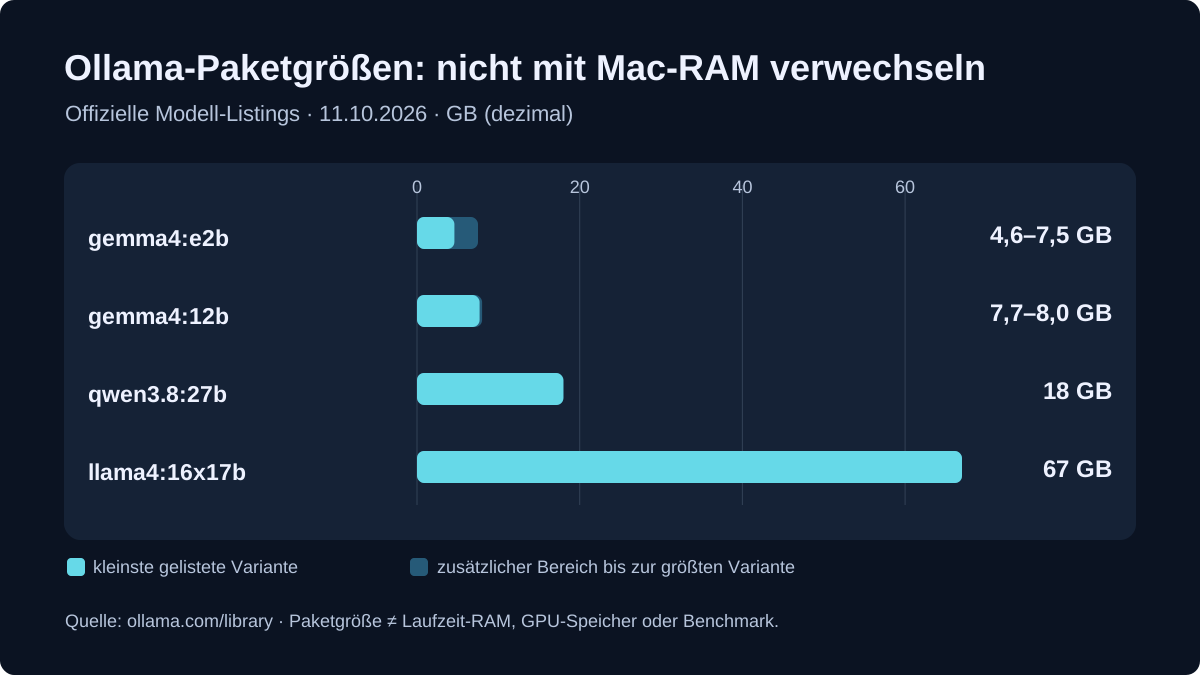
Grafik: Größen aus den offiziellen Ollama-Tagseiten und Qwen3.8 sowie Llama 4. Originale SVG-Aufbereitung; keine eigene RAM- oder Leistungsmessung.
Paketgröße ist nicht RAM-Bedarf
Beim lokalen Start müssen mehr Komponenten in den Speicher passen als nur die Datei aus der Ollama-Library:
- Modellgewichte und Runtime,
- KV-Cache für den gewählten Kontext,
- Bild- oder Audio-Encoder,
- macOS und Hintergrundprozesse,
- Browser, Editor und weitere Apps,
- temporäre Puffer für lange oder parallele Aufgaben.
Auf Apple Silicon teilen sich CPU und GPU den Unified-Memory-Pool. Deshalb kann ein 18-GB-Paket auf einem 24-GB-Mac zwar startbar sein, aber kaum Platz für 256K Kontext oder weitere Programme lassen. Ein Start ohne Fehlermeldung ist kein Beweis für komfortable Nutzung.
Qwen3.6: Coding und Agenten
Ollama listet Qwen3.6 aktuell in 27B- und 35B-Varianten sowie als MLX-Tags. Die Modellkarten beschreiben Verbesserungen für Coding-Agenten, Repository-Aufgaben, multimodale Eingaben und den Erhalt von Thinking-Kontext über historische Nachrichten.
Die praktische Auswahl:
# 27B: kleinerer Text-/Bild-Einstieg
ollama pull qwen3.6:27b
ollama run qwen3.6:27b

# 35B: größere Variante, mehr Speicherreserve nötig
ollama pull qwen3.6:35b
ollama run qwen3.6:35b
Die aktuellen Ollama-Seiten listen auch qwen3.6:27b-mlx und qwen3.6:35b-mlx mit Text- und Bildeingabe.
Qwen veröffentlicht umfangreiche Benchmarktabellen. Sie enthalten unter anderem Coding-, Agenten-, Vision- und Video-Evaluierungen, aber auch klare Methodikhinweise: unterschiedliche Harnesses, Zeitlimits, Kontextlängen, Prompting und interne Datensätze. Die Zahlen sind daher Quellenmaterial, keine direkte Mac-Rangliste. Für deinen Rechner ist die praktische Frage zunächst, ob Kontext und Tool-Aufrufe ohne Offloading stabil laufen.
Qwen3.8-27B ist der neuere 27B-Checkpoint. Ollama listet ihn als qwen3.8:27b (18 GB Paket, 256K Kontext, Text- und Bildeingabe). Qwen veröffentlicht den Checkpoint unter Apache 2.0; er nennt 27,8B Parameter, native 262.144 Kontexttokens, und es gibt MLX-4-/8-Bit- sowie GGUF-Konvertierungen. Neu heißt nicht automatisch besser auf dem eigenen Mac: unabhängige Laufzeitmessungen fehlen weiterhin, deshalb gilt derselbe Testmaßstab wie oben. Die vollständige Einordnung steht im Qwen3.8-27B-Guide.
Gemma 4: mehr Größen, klarere On-Device-Optionen
Google beschreibt Gemma 4 als multimodale Familie mit Dense- und MoE-Varianten:
- E2B und E4B für kleinere Geräte,
- 12B als Unified-Modell,
- 26B A4B als MoE-Variante,
- 31B als Dense-Modell.
Die Google-Model-Card nennt Audio nativ bei E2B, E4B und 12B. Die aktuellen Ollama-Einträge zeigen für die lokalen Tags vor allem Text- und Bildeingabe; Audio ist deshalb nicht automatisch in jeder Ollama-/Client-Kombination verfügbar.
# leichter Einstieg
ollama pull gemma4:e4b
ollama run gemma4:e4b

# 12B: deutlich mehr Qualität bei moderater Paketgröße
ollama pull gemma4:12b
ollama run gemma4:12b

# 26B MoE: nur mit bewusster Speicherplanung
ollama pull gemma4:26b
ollama run gemma4:26b
Für einen 24-GB-Mac ist gemma4:12b der vernünftigere erste Test. gemma4:26b wird zwar mit etwa 18 GB gelistet, lässt aber nach dem Laden wenig Reserve für Kontext, Bilder und andere Apps. Die 26B-A4B-Variante hat laut Google 25,2B Gesamtparameter und 3,8B aktive Parameter; das macht sie effizienter als 31B Dense, aber nicht speicherfrei.
Llama 4 Scout: großer Kontext, kein normaler Mac-Start
Ollama listet llama4:16x17b mit 67 GB und 10M Kontext. Die Model Card beschreibt Scout als 109B-MoE-Modell mit 17B aktivierten Parametern. Die Kombination aus 67 GB Paketgröße und 10M Kontext ist für normale lokale Macs unpraktisch:
# nur für sehr große Speicher-Setups oder Server-Experimente
ollama pull llama4:16x17b
Selbst 64 GB Unified Memory bedeuten nicht, dass 67 GB Modellpaket plus Runtime, macOS und KV-Cache bequem passen. Die 128x17B-Variante liegt laut Ollama sogar bei 245 GB und 1M Kontext. Für den täglichen Mac-Workflow sind Qwen3.6 oder Gemma 4 die realistischeren Kandidaten.
Lizenzen: Gemma 4 und Qwen sind nicht Llama 4
Stand 12. Oktober 2026. „Open Weight“ bezeichnet verfügbare Modellgewichte, keine gemeinsame Lizenz. Für eine kommerzielle App, ein mitgeliefertes Modell oder einen gehosteten Dienst zählt die Lizenz des genauen Checkpoints. Ollama-Tags, Modellkarten und Drittanbieter-Quantisierungen getrennt prüfen.
| Originalmodell | Lizenz laut Primärquelle | Was Entwickler beachten sollten |
|---|---|---|
| Gemma 4 | Apache 2.0, Google-Modellkarte | Gewerbliche Nutzung und Weitergabe grundsätzlich möglich; Lizenz-, Urheberrechts- und gegebenenfalls NOTICE-Pflichten. Nicht mit älteren Gemma-Lizenzen verwechseln. |
| Qwen3.8-27B | Apache 2.0, Originalgewichte | Dieselben grundsätzlichen Apache-Pflichten; bei GGUF-/MLX-Konvertierungen deren Herkunft und Zusatzdateien prüfen. |
| Llama 4 Scout | Llama 4 Community License, Meta-Lizenztext | Nicht Apache 2.0: Bei Weitergabe und Produktintegration gelten u. a. Lizenzbeilage und „Built with Llama“-Kennzeichnung; für sehr große Anbieter weitere Bedingungen. |


Lizenz ist nicht Datenschutz. Ein Apache-2.0-Modell sendet nicht automatisch Daten nach außen, garantiert aber auch keine DSGVO-Konformität. Für vollständig lokale Verarbeitung den tatsächlich geladenen Tag und die Runtime über ollama list, ollama show <modell> und ollama ps prüfen. Ein :cloud-Tag oder aktivierte Web-/API-Tools können Daten übertragen, auch wenn der Agent selbst auf dem Mac startet. Bei kommerzieller Weitergabe zusätzlich die Lizenz aller eingebundenen Komponenten kontrollieren.
Kontextlänge: die Einstellung, die viele Vergleiche verfälscht
Ollamas aktuelle Dokumentation nennt Standardwerte nach VRAM:
- unter 24 GiB: 4K Kontext,
- 24–48 GiB: 32K,
- ab 48 GiB: 256K.
Auf einem Apple-Silicon-Mac ist Unified Memory geteilt, daher sollten diese Schwellen nicht als exakte RAM-Garantie gelesen werden. Ollama empfiehlt für Coding-, Agenten- und Web-Suchaufgaben mindestens 64K, weist aber zugleich auf den höheren Speicherbedarf hin.
Prüfe nach dem Laden den tatsächlichen Zustand:
OLLAMA_CONTEXT_LENGTH=8192 ollama serve
# In einem zweiten Terminal das Modell laden und starten:
# ollama run gemma4:12b
# Danach: ollama ps
Das Beispiel startet einen eigenen Server. Beende vorher die Ollama-Desktop-App bzw. einen bereits laufenden Server auf Port 11434, sonst schlägt der zweite Serverstart fehl. Die Variable wird beim Serverstart gelesen; sie konfiguriert keinen bereits laufenden Dienst um. ollama ps zeigt geladene Modelle, Prozessor-Aufteilung und Kontext – erst nach dem Laden sinnvoll. Bei Speicherdruck Kontext reduzieren, statt aus einer einzelnen langsamen Antwort auf schlechte Modellqualität zu schließen.
Warum lokale Geschwindigkeitswerte einen Test brauchen
Tokens pro Sekunde hängen unter anderem von Modelltag, Quantisierung, Backend, Kontext, Prompt, Temperatur, Metal-/MLX-Pfad und Hintergrundlast ab. Communitywerte oder Herstellerzahlen sind für eine Vorauswahl nützlich, aber nicht reproduzierbar genug für eine Kauf- oder Produktionsentscheidung.
Ein fairer eigener Test dokumentiert mindestens:
- exaktes Mac-Modell und Unified Memory,
- macOS-Version und Ollama-Version,
- Modelltag und Quantisierung,
- Kontextlänge und Promptgröße,
- Prompt- und Output-Token,
- Prefill- und Decode-Geschwindigkeit,
- CPU-/GPU-Offload und Speicherdruck.
Gleiche Aufgaben auf dem eigenen Mac testen
Verwende die tatsächlichen Ollama-Modell-IDs. Im Oktober 2026 führt Ollama qwen3.8:27b mit 18-GB-Paket und bis zu 256K Kontext. Daraus folgt nicht, dass 256K auf einem 32-GB-Mac vernünftig als Standard verwendet werden sollte. Beginne mit kurzem Kontext und erhöhe erst, wenn der Speicherdruck stabil bleibt.
ollama pull gemma4:12b
ollama pull qwen3.8:27b
ollama show qwen3.8:27b
ollama ps
Miss in Aktivitätsanzeige → Speicher mit identischen Text- und Tool-Aufgaben den Speicherdruck, Swap, Antwortlatenz, Tokens/s, Modelltag, Ollama-Version und Kontextlänge. ollama ps zeigt geladene Modelle und Ausführungsort, aber keinen vollständigen macOS-RAM-Benchmark. Für private Dateien ist außerdem zwischen heruntergeladenem lokalem Tag und Ollama-Cloud-Modell zu unterscheiden.
Selbst messen: Gemma 4 gegen Qwen 3.8 auf demselben Mac
Statt aus Dateigrößen eine Geschwindigkeitsrangliste zu erfinden, kannst du einen kleinen, reproduzierbaren lokalen Vergleich durchführen. Die folgenden sechs Anfragen laufen ausschließlich über die Ollama-API auf 127.0.0.1; der Code benötigt nur Python 3 und fragt keine kostenpflichtige Cloud-API ab. Installiere beide Modelle vorab mit ollama pull gemma4:12b und ollama pull qwen3.8:27b. Ein 27B-Modell kann bei wenig RAM speicherbedingt scheitern.
python3 - <<'PY'
import json
import statistics
from urllib.request import Request, urlopen
from urllib.error import URLError

models = ("gemma4:12b", "qwen3.8:27b")
prompt = "Reply with JSON only: give the sorted unique integers from [3,1,3,2] as a list under the key result."
for model in models:
    samples = []
    for trial in range(1, 4):
        payload = {
            "model": model, "prompt": prompt, "stream": False,
            "format": "json", "keep_alive": "0",
            "options": {"num_ctx": 4096, "num_predict": 128, "temperature": 0},
        }
        req = Request(
            "http://127.0.0.1:11434/api/generate",
            data=json.dumps(payload).encode(), headers={"Content-Type": "application/json"},
        )
        try:
            with urlopen(req, timeout=240) as res:
                result = json.load(res)
        except URLError as exc:
            raise SystemExit(f"Cannot run {model}: {exc}. Check Ollama and model installation.")
        try:
            correct = json.loads(result.get("response", "{}")).get("result") == [1, 2, 3]
        except (ValueError, AttributeError, TypeError):
            correct = False
        n = result.get("eval_count", 0)
        ns = result.get("eval_duration", 0)
        tps = n * 1e9 / ns if ns else None
        sample = {
            "model": model, "run": trial, "correct": correct,
            "prompt_tokens": result.get("prompt_eval_count"),
            "output_tokens": n,
            "decode_tok_s": round(tps, 2) if tps is not None else None,
            "total_s": round(result.get("total_duration", 0) / 1e9, 2),
        }
        samples.append(sample)
        print(json.dumps(sample))
    speeds = [s["decode_tok_s"] for s in samples if s["decode_tok_s"] is not None]
    print("Summary", model, "passed", sum(s["correct"] for s in samples),
          "/3; median decode tok/s", statistics.median(speeds) if speeds else "n/a")
PY
Die API liefert prompt_eval_count, eval_count, eval_duration und total_duration; Details stehen in der offiziellen Ollama-Dokumentation. Die Rechnung für Decode-Tokens pro Sekunde verwendet nur die Generierungsdauer; total_s enthält dagegen auch Lade- und andere Zeiten. keep_alive: "0" entlädt das Modell nach jedem Aufruf und macht daraus einen Cold-Run-Test, keinen Cache-/Warm-Run-Benchmark. num_ctx=4096 und temperature=0 begrenzen zwei Störgrößen. Die drei Wiederholungen sind ein Einstieg und ersetzen keine umfassende Statistik.
Die JSON-Aufgabe hat ein eindeutig überprüfbares Ergebnis; 3/3 bestandene Versuche sind hier relevanter als hohe Tokens/s bei falscher Ausgabe. Halte außerdem Mac-Chip, Ollama-Version, Modelldigest (ollama show), verfügbaren Unified Memory sowie Speicherdruck/Swap in Aktivitätsanzeige → Speicher fest. Das Skript veröffentlicht keine von AI on Mac erhobenen Messwerte: Die Ausgabe wird erst auf deinem eigenen Rechner erzeugt. Für eine Kaufentscheidung zusätzlich mindestens eine echte Coding- und eine lange Dokumentaufgabe messen.
Downloadbare Messhilfe: Das lokale Ollama-Benchmark-Skript erweitert den oben erläuterten Test um frei wählbare Modell-Tags, eigene Prompt-/Erwartungsdateien und eine optionale CSV-Ausgabe. Prüfe den Python-Quelltext vor dem Ausführen und verwende nur heruntergeladene lokale Modell-Tags – ein Ollama-Cloud-Tag kann trotz localhost Daten zu einem externen Anbieter routen. Beispiel nach dem Speichern der Datei:
python3 ollama-mac-benchmark.py --models gemma4:12b qwen3.8:27b --runs 3 --ctx 4096 --csv messung.csvDie CSV erfasst keine automatische RAM-Messung; notiere Speicherdruck und Swap zusätzlich in der Aktivitätsanzeige. Der Download ist ausführbarer Quellcode, kein bereits durchgeführter Benchmark.
Praktische Auswahl
Für lokale Open-Weight-LLMs auf dem Mac zählt die Kombination aus Paketgröße, Kontext und freiem Unified Memory. Gemma 4 E2B/E4B ist für kleine Geräte gedacht, Gemma 4 12B ist ein vernünftiger 24-GB-Einstieg, Qwen3.8-27B passt ab 32 GB mit mehr Reserve; Qwen3.6-35B ist eine separate, ältere und größere Option, und Llama 4 Scout bleibt trotz 10M Kontext ein Spezialfall für sehr große Speicherumgebungen.
Ein Spezialfall für wenig Speicher ist Ternary Bonsai 2 27B: PrismML leitet es von Qwen3.8-27B ab und liefert ternär quantisierte GGUF-Pakete (ab 5,95 GB) sowie ein MLX-Bundle (8,60 GB inklusive Vision-Tower). Die Gewichte stehen unter Apache 2.0, aber die GGUF-Pakete brauchen aktuell einen llama.cpp-Fork von PrismML mit Hadamard-Transformation; die 5,9 GB sind eine Dateigröße, kein gemessener RAM-Bedarf. Für die tatsächliche RAM-Eignung gibt es keine allgemeine 8-GB-Garantie: Kontextlänge, KV-Cache, Vision-Projektor, macOS und die benötigte PrismML-Runtime müssen zusammen berücksichtigt werden. Die Werte sind vor dem Kauf auf dem eigenen Mac zu prüfen. Details und Vorbehalte stehen im Ternary-Bonsai-2-27B-Faktencheck.
Die Taglisten zeigen, warum ein statisches Ranking schnell veraltet: Ollama-Tags, Paketgrößen und Eingabemodalitäten ändern sich. Prüfe den konkreten Tag, starte mit begrenztem Kontext und miss deinen eigenen Workflow, bevor du aus einem Modellnamen eine Kaufempfehlung ableitest.
Quellen
-
Gemma 4: Google-Modellkarte – Apache 2.0 für Gemma 4.
-
Qwen3.8-27B: Original-Checkpoint – Apache 2.0.
-
Meta: Llama 4 Community License – Attribution und Weitergabebedingungen.
-
Ollama: Qwen3.6 – aktuelle Tags, Paketgrößen, Kontext und Eingabemodalitäten.
-
Qwen3.6 27B Model Card und 35B-A3B Model Card – Architektur, Benchmarks und Methodikhinweise.
-
Qwen: Qwen3.6-27B und Qwen3.6-35B-A3B – offizielle Release-Einordnung und Open-Weight-Verfügbarkeit.
-
Ollama: Gemma 4 – aktuelle lokale Tags und Größen.
-
Google Gemma 4 Model Card – Modalitäten, Größen, Kontext und Benchmarks.
-
Ollama: Llama 4 – Scout-/Maverick-Tags, Paketgrößen und Kontext.
-
Meta: Llama 4 – offizielle Einordnung von Scout und Maverick.
-
Ollama: Context length – Kontextstandardwerte und
ollama ps.
Häufig gestellte Fragen
Welches Modell sollte ich auf einem Mac mit 24 GB zuerst testen?
Für einen vorsichtigen Einstieg sind kleinere Gemma-4- oder Qwen-Tags sinnvoller als ein 26B-Modell. Gemma 4 12B ist laut aktueller Ollama-Liste je nach Variante etwa 7,7–8,0 GB groß; gemma4:26b liegt bei etwa 18 GB und lässt mit Kontext, macOS und anderen Apps wenig Reserve.
Läuft Llama 4 Scout auf dem Mac?
Ollama listet Llama 4 Scout mit etwa 67 GB und 10M Kontext. Das ist für normale lokale Mac-Setups unpraktisch, weil Modellpaket, Runtime, Kontext und macOS gemeinsam Speicher benötigen.
Sind die Paketgrößen aus der Tabelle lokale RAM-Messungen?
Nein. Die Tabelle wurde anhand der offiziellen Ollama-Modellseiten am 11. Oktober 2026 aktualisiert und zeigt Paketgrößen bzw. Variantenbereiche, keine Messwerte vom Mac. Die tatsächliche Spitzenbelegung hängt zusätzlich von Kontext, KV-Cache, Runtime, Eingabemodalität und Hintergrundlast ab.
Welche Kontextlänge sollte ich in Ollama wählen?
Ollamas aktuelle Dokumentation nennt als Standardwerte <24 GiB VRAM: 4K, 24–48 GiB: 32K und ab 48 GiB: 256K. Auf Apple Silicon ist Unified Memory geteilt; prüfe deshalb die reale Belegung mit ollama ps und erhöhe den Kontext erst nach einem kleinen Test.
Hat Gemma 4 Audio-Unterstützung?
Google nennt native Audio-Unterstützung für E2B, E4B und 12B. Die aktuellen Ollama-Tags listen primär Text- und Bildeingabe; ob Audio in deinem konkreten Tag und Client funktioniert, muss separat geprüft werden.
Welches lokale LLM passt auf einen Mac mit 16 GB?
Starte mit Gemma 4 E2B oder E4B oder einem kleineren Qwen-Tag. Große Agentenläufe sind bei 16 GB speicherempfindlich.
Welches offene LLM passt auf einen Mac mit 32 GB?
Qwen3.8 27B und Gemma 4 26B sind sinnvolle erste Tests. Qwen3.6 35B liegt laut Ollama bei rund 23–24 GB Paketgröße und braucht auf 32 GB besondere Vorsicht bei Kontext und parallelen Apps.