Geprüft am 11. Oktober 2026. Gemma 4 12B Unified bleibt eine der interessantesten lokalen Mittelklasse-Optionen für Apple Silicon. Google dokumentiert 11,95 Milliarden Parameter, 48 Layer, 256K Kontext und Text-, Bild-, Audio- sowie Videoeingaben. Das Modell ist dicht aufgebaut; „Unified“ bezieht sich auf die encoder-freie Multimodalarchitektur, nicht auf Mixture of Experts. 123
Was Gemma 4 12B technisch ist
Gemma 4 12B verarbeitet Bild- und Audiosignale ohne separate große Vision- oder Audioencoder. Stattdessen werden die Eingaben direkt in den Embedding-Raum des Decoder-Modells projiziert. Google beschreibt das als kompakteren Multimodal-Stack, der sich besser für lokale Geräte eignet. 142
| Eigenschaft | Gemma 4 12B Unified |
|---|---|
| Parameter | 11,95B |
| Layer | 48 |
| Kontext | bis 256K |
| Sliding Window | 1.024 Tokens |
| Eingaben | Text, Bild, Audio, Video |
| Ausgabe | Text |
| Thinking | konfigurierbar |
| Function Calling | unterstützt |
| Lizenz | Apache 2.0 |
Google hat die 12B-Variante am 3. Juni 2026 veröffentlicht. Die Gemma-Release-Seite führt sie weiterhin als aktuellen Teil der Gemma-4-Familie. 5
Wie viel Unified Memory braucht 12B?
Die wichtigste Zahl ist nicht das 256K-Kontextlimit, sondern der tatsächliche Speicherbedarf der gewählten Quantisierung plus KV-Cache, Runtime und macOS.
Ollama bietet für gemma4:12b derzeit lokale Varianten in einer Größenordnung von rund 7,7 bis 8,0 GB an. Ein 16-GB-Mac kann das laden, hat aber deutlich weniger Reserve als ein 24- oder 32-GB-Gerät. 6
| Unified Memory | Praktische Einordnung |
|---|---|
| 16 GB | Q4 machbar; Kontext und offene Apps begrenzen |
| 24 GB | komfortabler für Coding, Dokumente und Vision |
| 32 GB | gute Reserve für längere Prompts und mehrere Medien |
| 48 GB+ | sinnvoll für lange Kontexte oder höhere Präzision |
Auf 16 GB würde ich mit 8K oder 16K Kontext starten und erst erhöhen, wenn der reale Speicherverbrauch gemessen ist. 256K ist ein architektonisches Maximum, kein sinnvoller Default.
Ollama: der einfache lokale Weg
Die Installation bleibt kurz:
ollama pull gemma4:12b
ollama run gemma4:12b
Die Ollama-Modellfamilie nennt Vision, Tools, Thinking und Audio; die konkrete 12B-Tagliste weist derzeit Text- und Bildeingaben aus. Audiodateien oder Video solltest du deshalb nicht ohne Prüfung der tatsächlich verwendeten Client-/Runtime-Version als funktionsfähig voraussetzen. 6
Für ein Bild kann ein lokaler Pfad in den Prompt eingebunden werden. Bei Audio und Video sollte dagegen immer die konkrete Runtime-Version geprüft werden: Dass das Modell eine Modalität unterstützt, bedeutet nicht automatisch, dass jeder Client sie bereits vollständig implementiert.
MLX: mehr Kontrolle auf Apple Silicon
Für MLX existieren Community-Konvertierungen von Gemma 4 12B, darunter 4-Bit-Varianten. Sie sind nützlich, wenn du Python-Code, Quantisierung und Messungen selbst kontrollieren willst. 7
Der wichtige Unterschied zu Ollama ist nicht „besser gegen schlechter“. Ollama liefert einen einfachen, integrierten Weg. MLX ist flexibler für Experimente und Apple-Silicon-spezifische Optimierungen. Bei beiden gilt: Unterstützung für Vision, Audio, Video, Tools und Thinking muss für die konkrete Runtime und Modellkonvertierung geprüft werden.
Audio und Video
Google dokumentiert Modellfähigkeit, Ollama dokumentiert die Fähigkeiten der ausgelieferten Runtime. Die offizielle Gemma-4-Modellkarte nennt Text, Bild und Audio für 12B Unified sowie Videoverständnis über sequenziell übergebene Frames. Für Audio nennt Google maximal 30 Sekunden; für Video maximal 60 Sekunden bei einem Frame pro Sekunde. Das sind Grenzen des beschriebenen Modell-Workflows, keine Garantie für eine fertige Videodatei- oder Audiodatei-API in Ollama. 123
Die konkrete Ollama-Tagliste und die fest ausgewählte Q4_K_M-Version führen Text und Bild als dokumentierte Eingaben. Audio und Video stehen für diese Tag-Oberfläche nicht in der Eingabeliste. Daraus folgt nicht, dass die Architektur solche Daten unmöglich verarbeiten kann; es bedeutet, dass Nutzer die Verarbeitung mit ihrer tatsächlichen Runtime, Schnittstelle und Modellkonvertierung erst nachweisen müssen, bevor sie damit planen.
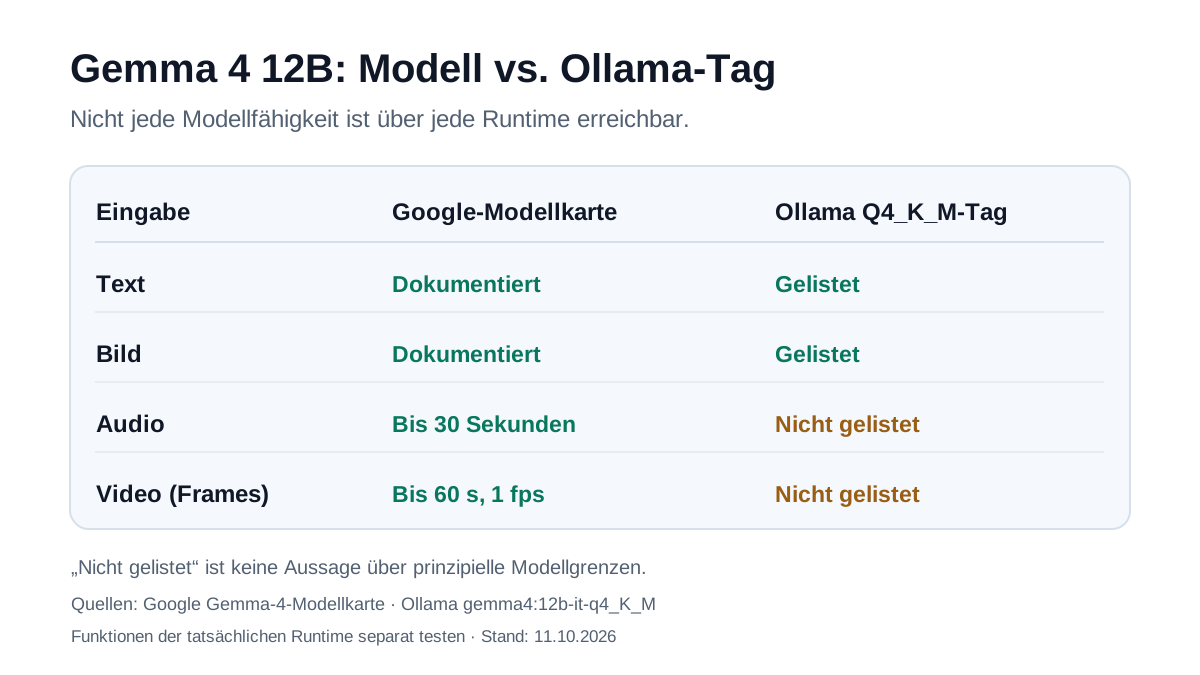
Prüfablauf für eigene Medien: (1) Modell und Runtime-Version mit ollama --version und ollama show gemma4:12b-it-q4_K_M festhalten. (2) Erst ein lokales Testbild verwenden; der Tag weist Bildinput aus. (3) Audio- und Videodateien nur über eine Runtime mit explizit dokumentierter Unterstützung einlesen, dort die 30-/60-Sekunden-Grenzen und tatsächlichen Fehler testen. (4) Datenverarbeitung und Netzwerknutzung der gewählten Software separat prüfen; der reine Ollama-Loopback-Aufruf im Textbeispiel sendet selbst keinen API-Prompt an Google.
Für eine umfassendere Referenzimplementierung beschreibt Google Transformers mit AutoModelForMultimodalLM. Der unquantisierte Checkpoint ist deutlich größer als ein Q4-Build und daher keine gute Standardoption auf einem 16-GB-Mac.
Benchmarks richtig lesen
Google veröffentlicht für die instruction-tuned 12B-Variante unter anderem folgende Werte: 2
| Benchmark | Gemma 4 12B | Gemma 4 26B A4B | Gemma 3 27B ohne Thinking |
|---|---|---|---|
| MMLU Pro | 77,2 % | 82,6 % | 67,6 % |
| AIME 2026, keine Tools | 77,5 % | 88,3 % | 20,8 % |
| LiveCodeBench v6 | 72,0 % | 77,1 % | 29,1 % |
| GPQA Diamond | 78,8 % | 82,3 % | 42,4 % |
| MMMU Pro | 69,1 % | 73,8 % | 49,7 % |
| MRCR v2, 128K | 43,4 % | 44,1 % | 13,5 % |
Das sind Hersteller-Evaluationen. Sie zeigen, dass 12B deutlich über der kleinen E-Klasse liegt und in manchen Tests nah an 26B A4B kommt. Sie sagen nichts über Tokens pro Sekunde auf deinem konkreten Mac.
Ein überprüfbarer 16-/24-/32-GB-Mac-Test
Ollamas Q4_K_M-Tagseite listet 8,0 GB Modelldaten, 11,9B Parameter und die Buildkennung 6114515d63c1 (Stand 11. Oktober 2026). Die Größe ist kein gemessener Laufzeit-RAM-Bedarf. Anders als das veränderliche gemma4:12b fixiert der Tag die Quantisierungsklasse, aber nicht dauerhaft die Binärdatei – Modell-Digest und Ollama-Version mitprotokollieren. Starte auf 16 GB mit kurzem Kontext und prüfe den Speicherdruck.
Schritt 1 – Modellvariante kontrollieren. Installiere Ollama für macOS, öffne Terminal und führe diese Befehle aus:
ollama --version
ollama pull gemma4:12b-it-q4_K_M
ollama show gemma4:12b-it-q4_K_M
ollama list
Notiere die Versionsnummer und die lokale Modellkennung bzw. den Digest. Für spätere Vergleiche reicht gemma4:12b als veränderlicher Standardtag nicht aus.
Schritt 2 – denselben Prompt lokal messen. Dieser Aufruf nutzt nur die Python-Standardbibliothek und den lokalen Ollama-Endpunkt. Er sendet keine Inhalte an einen Cloud-Anbieter. Starte ihn dreimal, und wiederhole ihn mit 4.096 statt 8.192 Kontext-Tokens, wenn auf 16 GB Speicherdruck entsteht.
python3 - <<'PY'
import json
from urllib.request import Request, urlopen

model = "gemma4:12b-it-q4_K_M"
prompt = "Erkläre mit einem konkreten Python-Beispiel, warum ein gemeinsam genutztes Dictionary in zwei Threads eine Race Condition auslösen kann."
payload = {
    "model": model,
    "prompt": prompt,
    "stream": False,
    "keep_alive": "5m",
    "options": {"num_ctx": 8192, "temperature": 0},
}
request = Request(
    "http://127.0.0.1:11434/api/generate",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)
with urlopen(request, timeout=600) as response:
    data = json.load(response)
count = data.get("eval_count", 0)
seconds = data.get("eval_duration", 0) / 1e9
print("Output tokens:", count)
print("Prompt tokens:", data.get("prompt_eval_count", 0))
print("Prompt processing seconds:", round(data.get("prompt_eval_duration", 0) / 1e9, 2))
print("Model load seconds:", round(data.get("load_duration", 0) / 1e9, 2))
print("Decode tokens/s:", round(count / seconds, 1) if seconds else "n/a")
print("Total seconds:", round(data.get("total_duration", 0) / 1e9, 1))
print("Answer excerpt:", data.get("response", "")[:300])
PY
ollama ps
Schritt 3 – Arbeitsfähigkeit statt nur Durchsatz prüfen. Öffne gleichzeitig Aktivitätsanzeige → Speicher und protokolliere den Speicherdruck, Swap, Modell-Digest, Ollama-Version, Mac-Chip, installierten Unified Memory, Kontextgröße sowie die Ergebnisqualität. eval_count / eval_duration ergibt nur die Dekodiergeschwindigkeit; der API-Response liefert zusätzlich prompt_eval_count, prompt_eval_duration und load_duration, die das Skript separat ausgibt. total_duration umfasst die Anfrage einschließlich des Ladevorgangs. temperature: 0 dient diesem einfachen Vergleich; es weicht von Googles empfohlener Modell-Standardkonfiguration temperature=1.0 ab, deshalb sind die Werte weder mit Googles Benchmarks noch mit beliebigen Nutzersitzungen identisch. Mit wiederholten Durchläufen und einem tatsächlich ausgeführten Python-Beispiel prüfst du mehr als nur ein Marketing-Benchmark. Die Metriken sind in der Ollama-Generate-API dokumentiert. Dieser Artikel enthält keine von uns auf einem Mac erhobenen Messwerte.
Wann Gemma 4 12B sinnvoll ist
12B passt gut zu lokalen Coding-Assistenten, Dokumentanalyse, OCR, Screenshot-/UI-Verständnis und mehrsprachiger Arbeit, wenn die Daten nicht in eine Cloud geschickt werden sollen. Auf 24 bis 32 GB ist genügend Reserve vorhanden, um das Modell neben Entwicklungswerkzeugen vernünftig zu betreiben.
Für 16 GB ist 12B eher eine bewusst gewählte obere Mittelklasse als ein sorgloser Default. Wenn niedrige Latenz wichtiger ist als Qualität, ist E4B leichter. Wenn deutlich mehr Speicher vorhanden ist, lohnt der Vergleich mit 26B A4B oder 31B.
Aktuelle Einordnung
Gemma 4 12B ist weder ein „kleines 12B, das alles kann“ noch ein Modell, das wegen 256K Kontext automatisch 256K lokal sinnvoll nutzt. Seine Stärke ist die Kombination aus rund 12B Parametern, multimodalen Eingaben und einer lokalen Q4-Größe um 8 GB. 26
Auf 16 GB ist es nutzbar, solange Kontext und Parallel-Last kontrolliert werden. Auf 24 oder 32 GB ist es deutlich entspannter. Für Mac-Nutzer ist genau diese Größenklasse oft praktischer als ein größeres Modell, das zwar bessere Benchmarks hat, aber den gesamten Unified-Memory-Pool dominiert.
Quellen und Prüfstatus
Herstellerdaten zu Architektur und Benchmarks stammen von Google, Paketgrößen und Tag-Unterstützung von Ollama. Die Speicherstufen sind praktische Planungsannahmen, keine auf diesem Mac verifizierten Grenzwerte.
Footnotes
Häufig gestellte Fragen
Läuft Gemma 4 12B auf einem Mac mit 16 GB Unified Memory?
Ja, mit einer 4-Bit-Quantisierung und begrenztem Kontext. Die aktuellen Ollama-Varianten liegen grob bei 8 GB Modelldaten; macOS, Runtime und KV-Cache brauchen zusätzlichen Speicher.
Wie groß ist das Kontextfenster?
Google dokumentiert für Gemma 4 12B Unified bis zu 256K Tokens Kontext. Das ist ein Modelllimit, keine Empfehlung für 256K auf einem 16-GB-Mac.
Unterstützt Gemma 4 12B Audio und Video?
Ja. Google nennt Text, Bild, Audio und Video als Eingaben für 12B Unified. Ob eine lokale Runtime alle Modalitäten anbietet, hängt von der konkreten Implementierung ab.
Ollama oder MLX auf dem Mac?
Ollama ist der einfachere Einstieg. MLX ist interessanter, wenn du Python, Apple-Silicon-spezifische Messungen oder eine bestimmte Quantisierung selbst kontrollieren willst.
Ist Gemma 4 12B ein MoE-Modell?
Nein. Die 12B-Variante ist ein dichtes 11,95B-Modell mit 48 Layern. Das 26B-A4B-Modell der Familie ist die MoE-Variante.