Aktualisiert am 9. Oktober 2026; Launch-Recherche vom 12.–15. August bleibt als historische Quellenbasis erhalten. NVIDIA hat Nemotron 3.5 Lightning am 11. August 2026 veröffentlicht. Offiziell beschreibt NVIDIA das Modell als 30B-Mixture-of-Experts mit 3B aktiven Parametern, einer Hybridarchitektur aus Mamba-2, MoE und ausgewählten Attention-Layern sowie einem Kontextfenster von bis zu einer Million Tokens. Die Veröffentlichung umfasst BF16- und NVFP4-Checkpoints, mehrere Verfahren für spekulatives Decoding sowie Trainingsdaten und -rezepte unter OpenMDW 1.1. 123
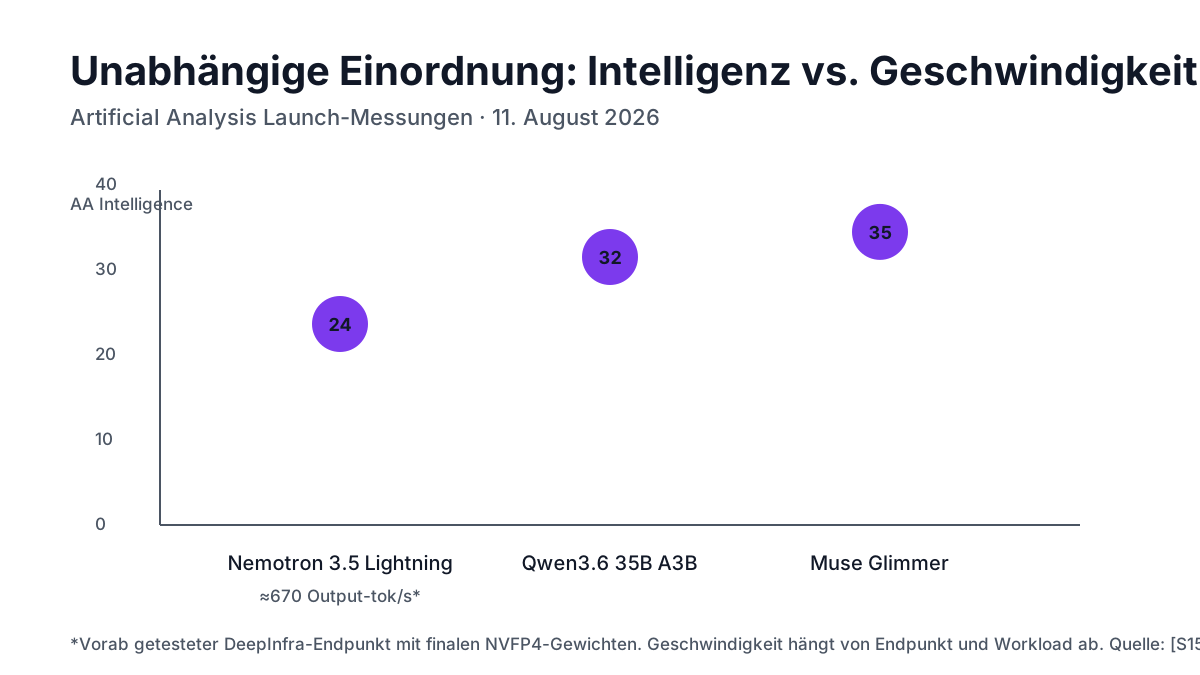
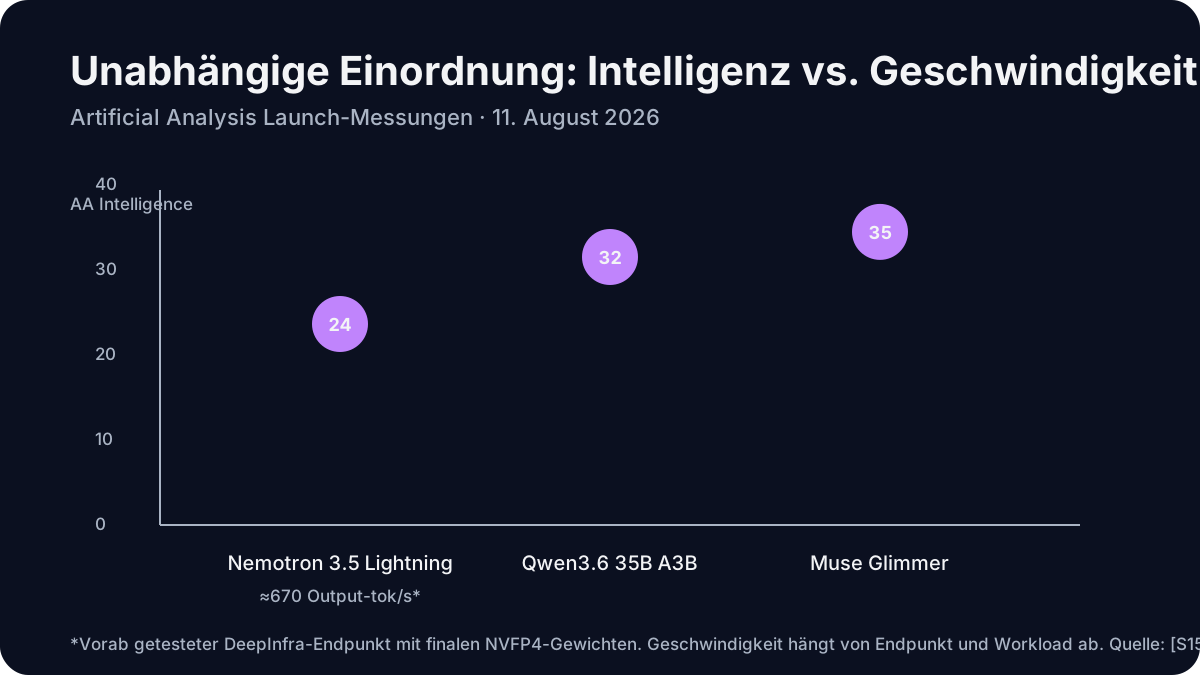
Die kurze Einordnung lautet: Nemotron 3.5 Lightning ist kein neues Spitzenmodell für maximale allgemeine Intelligenz. Es ist ein sehr schnelles, relativ kleines Ausführungsmodell für Agenten, Tool-Aufrufe, Coding und wiederholte Arbeitsschritte. In der unabhängigen Artificial-Analysis-Auswertung erreicht es einen Intelligence Index von 24 und liegt damit unter Qwen3.6 35B A3B (32) und Muse Glimmer (35). Gleichzeitig wurden auf einem vorab getesteten DeepInfra-NVFP4-Endpunkt fast 670 Output-Tokens/s gemessen. 456
Diese Kombination ist der eigentliche Punkt des Modells: nicht „bestes Modell um jeden Preis”, sondern viel Agentenarbeit pro Sekunde und pro Dollar.
Die wichtigsten Fakten zum Nemotron 3.5 Lightning
| Merkmal | Stand 12.08.2026 | Einordnung |
|---|---|---|
| Veröffentlichung | 11.08.2026 | offiziell |
| Modellgröße | 30B gesamt / 3B aktiv laut NVIDIA | Unterschied von NVIDIA nicht erläutert; AA meldet 31,6B / 3,6B |
| Architektur | Hybrid-MoE: Mamba-2 + MoE + ausgewählte Attention-Layer | offiziell |
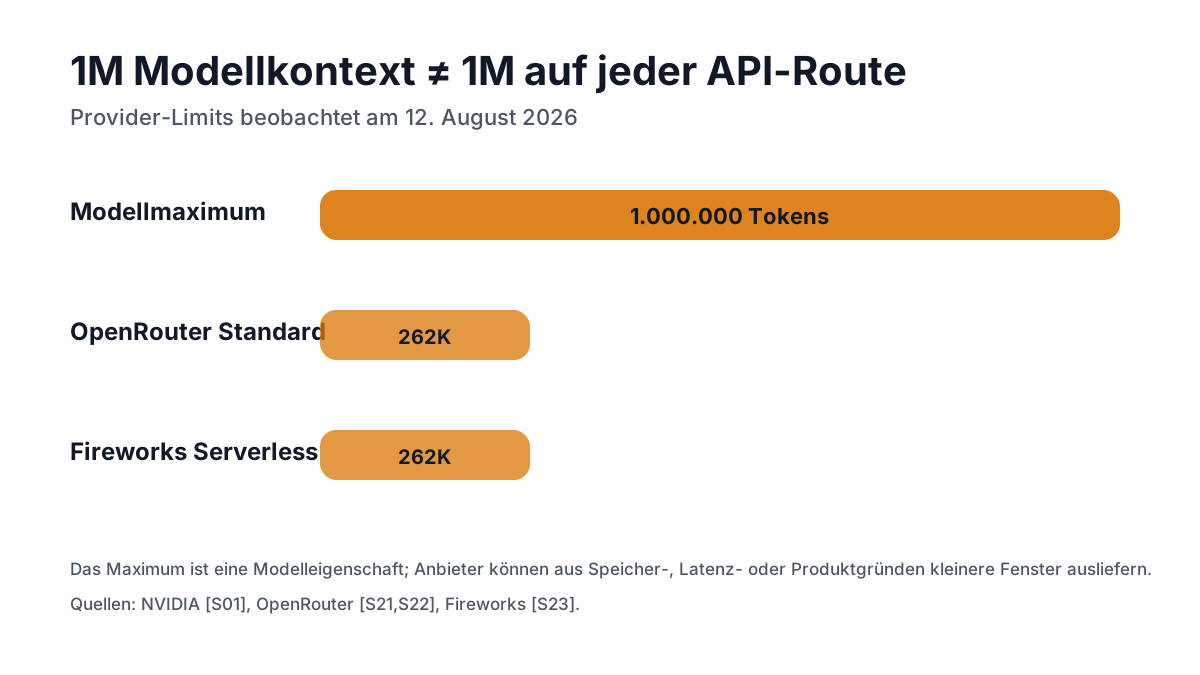
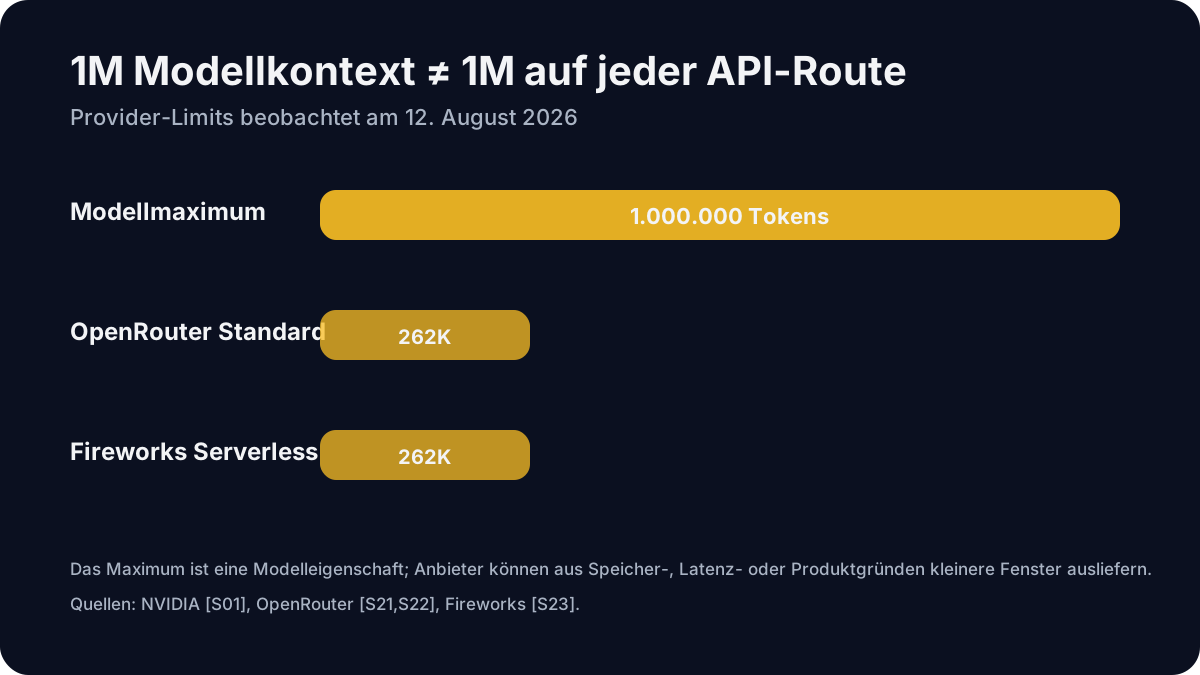
| Kontext | bis 1.000.000 Tokens | nicht jeder API-Anbieter stellt 1M bereit |
| Eingabe/Ausgabe | Text → Text | kein natives Bild-Input |
| Lizenz | OpenMDW 1.1 | kommerzielle Nutzung laut NVIDIA vorgesehen |
| Optimierter Checkpoint | NVFP4 | für Deployment gedacht |
| Referenz-Checkpoint | BF16 | vor allem für Anpassung/Post-Training |
| Lokale NVIDIA-Hardware | u. a. RTX 5090, DGX Spark/GB10, H100/H200 | offizielle Modellkarte |
| Apple Silicon | keine offizielle NVIDIA-Unterstützung | Community-GGUF und MLX existieren |
| OpenRouter Standard | 262K, $0,05/M Input, $0,20/M Output | provider-spezifisch |
| Fireworks | 262K, $0,05/M Input, $0,01/M Cache, $0,20/M Output | provider-spezifisch |
30B oder 31,6B? Warum verschiedene Zahlen kursieren
Hier gibt es bereits einen kleinen, aber wichtigen Widerspruch. NVIDIA nennt 30 Milliarden Gesamtparameter und 3 Milliarden aktive Parameter. Artificial Analysis führt dagegen 31,6 Milliarden Gesamtparameter und 3,6 Milliarden aktive Parameter; Fireworks listet 32,9 Milliarden Parameter. 157
Das ist kein Beleg dafür, dass eine der Quellen „falsch” sein muss. Bei MoE-Modellen können Zählweisen, Rundung und einbezogene Komponenten voneinander abweichen. In den geprüften NVIDIA-Quellen wird der Unterschied aber nicht ausdrücklich erklärt. Deshalb ist die saubere Formulierung:
NVIDIA vermarktet Nemotron 3.5 Lightning als 30B-A3B-Modell. Unabhängige beziehungsweise providerseitige Metadaten nennen höhere exakte Zählwerte.
Für Titel und Modellnamen sollte die offizielle Bezeichnung 30B-A3B verwendet werden.
Architektur: Warum nur ein Teil des Modells pro Token arbeitet
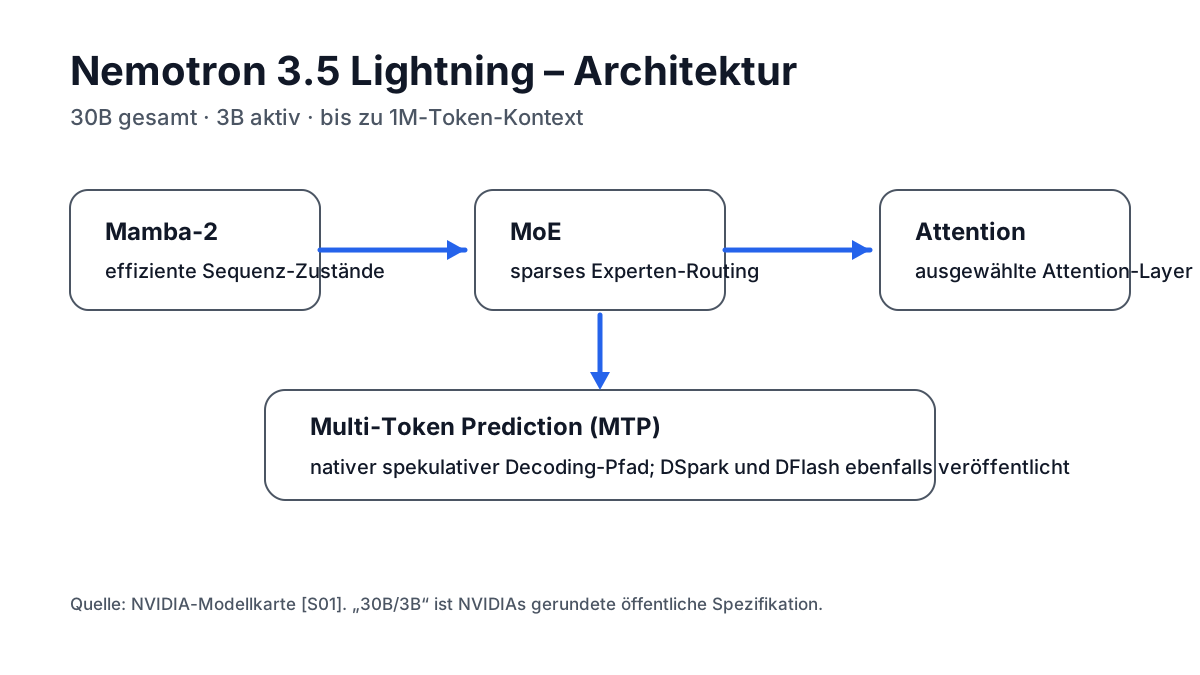
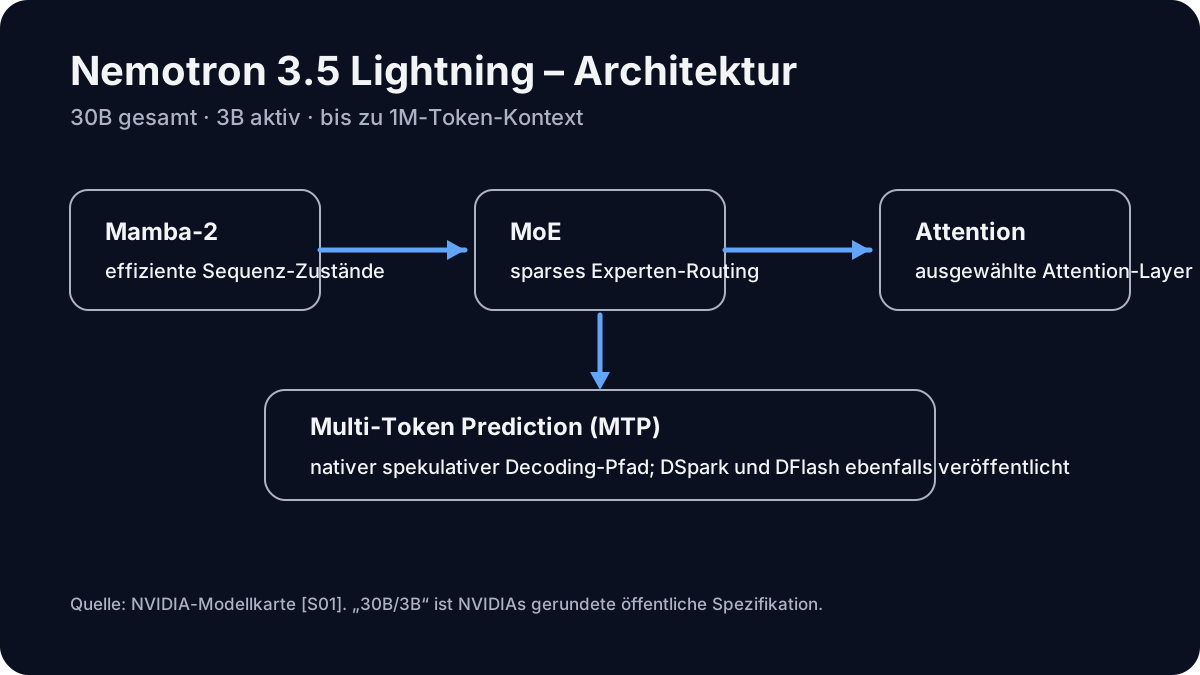
Nemotron 3.5 Lightning kombiniert drei Bausteine: Mamba-2, Mixture-of-Experts und ausgewählte Attention-Layer. Von den insgesamt rund 30 Milliarden Parametern wird pro Token nur ein deutlich kleinerer Teil aktiviert. 1
Das ist für Agentensysteme interessant. Ein autonomer Agent verbringt nicht jeden Schritt mit schwerem strategischem Denken. Er muss häufig Dateien lesen, strukturierte Daten umformen, APIs ansprechen, Ergebnisse überprüfen, kurze Codeänderungen erzeugen oder Subagenten koordinieren. NVIDIA positioniert Lightning genau als diese Ausführungsschicht und schlägt stärkere Modelle für schwierige Planungsschritte vor. NeMo Switchyard soll solche Aufgaben zwischen Modellen routen. 28
Zusätzlich enthält Lightning Multi-Token Prediction (MTP). Dabei wird nicht ausschließlich das nächste einzelne Token vorhergesagt; ergänzend stellt NVIDIA mit DSpark und DFlash zwei spekulative Decoding-Pfade bereit. Das Ziel ist nicht höhere Modellintelligenz, sondern geringere Latenz beziehungsweise höherer Durchsatz bei geeigneten Serving-Setups. 1910
Wie gut ist Nemotron 3.5 Lightning bei Benchmarks?
NVIDIAs eigene Release-Benchmarks
Für den NVFP4-Checkpoint veröffentlicht NVIDIA unter anderem folgende Werte: 1
| Benchmark | NVFP4 | Was er grob misst |
|---|---|---|
| MMLU Pro | 81,62 | breites Fachwissen/Reasoning |
| GPQA Diamond | 75,57 | schwierige wissenschaftliche Fragen |
| HLE, text-only, ohne Tools | 10,47 | sehr anspruchsvolle Wissens-/Reasoning-Aufgaben |
| SciCode | 31,38 | wissenschaftliches Coding |
| SWE-bench Verified | 52,80 | reale Software-Issues |
| SWE-bench Multilingual | 36,47 | Software-Aufgaben über mehrere Sprachen |
| Terminal-Bench 2.1 | 23,46 | Terminal-/Agentenaufgaben |
| PinchBench | 83,43 | agentische Praxisaufgaben |
| BrowseComp | 36,81 | Web-/Rechercheaufgaben |
| GDPval-AA-V2 | 865 | professionelle Aufgaben |
| IFBench loose | 72,88 | Instruction Following |
| AA-LCR | 49,19 | Long-Context-Reasoning |
Diese Zahlen sollten nicht unkritisch mit Herstellerwerten anderer Modelle zusammengemischt werden. NVIDIA weist selbst darauf hin, dass die Werte mit einem konsistenten eigenen Harness gemessen wurden und von selbstberichteten Werten anderer Anbieter abweichen können. Positiv ist, dass NVIDIA Evaluierungsrezepte veröffentlicht. 1
Unabhängige Einordnung von Artificial Analysis
Artificial Analysis gibt Nemotron 3.5 Lightning aktuell einen Intelligence Index von 24. Damit liegt es nach dieser Metrik hinter anderen kleinen offenen Modellen wie Qwen3.6 35B A3B mit 32 und Muse Glimmer mit 35. 45
Der Intelligence Index und der Durchsatz messen unterschiedliche Eigenschaften: Der Index ordnet Nemotron hinter Qwen3.6 35B A3B und Muse Glimmer ein; auf einem vor dem Release getesteten DeepInfra-NVFP4-Endpunkt mit den finalen NVFP4-Gewichten wurden dagegen nahezu 670 Output-Tokens pro Sekunde gemessen. Auf der späteren Providerseite lagen zum Abrufzeitpunkt 662,9 t/s für DeepInfra, 522,8 t/s für Fireworks und 256,6 t/s für Nebius. 46
Diese Zahlen sind keine lokale GPU-Geschwindigkeit. Sie gelten für konkrete Cloud-Endpunkte und ändern sich mit Batch-Größe, Hardware, Last, Prompt-Länge und Serving-Konfiguration. Sie zeigen aber, worauf NVIDIA optimiert: sehr hohen Durchsatz.
Ist es besser als Qwen3.6 oder Muse Glimmer?
Wenn „besser” allgemeine Problemlösungsleistung meint, lautet die Antwort nach dem derzeit besten unabhängigen Vergleich: eher nein. Artificial Analysis bewertet Qwen3.6 35B A3B und Muse Glimmer deutlich höher in der allgemeinen Intelligence-Metrik. 4
Wenn „besser” dagegen schnelle, häufige Agentenschritte bedeutet, kann Nemotron 3.5 Lightning die interessantere Wahl sein. Die Kombination aus 3B aktivem Arbeitsumfang, spekulativem Decoding und NVFP4 ist gezielt auf Durchsatz ausgelegt. Dafür sollte man das Modell aber in einem eigenen Agenten-Harness mit den realen Aufgaben testen statt eine einzelne Benchmarkzahl zu übertragen.
Kontextfenster: 1 Million Tokens – aber nicht überall
NVIDIA gibt ein maximales Kontextfenster von bis zu 1.000.000 Tokens an. 111
Das bedeutet nicht, dass jeder Anbieter oder jede lokale Runtime automatisch eine Million Tokens bereitstellt. Am 12. August 2026 zeigt OpenRouter für den normalen kostenpflichtigen nvidia/nemotron-3.5-lightning-Endpunkt 262K Kontext; der kostenlose NVIDIA-Pfad wird dort mit 1M ausgewiesen. Fireworks nennt ebenfalls 262K. 12137
Das ist ein wichtiger Unterschied zwischen:
- Modellmaximum – was die Architektur beziehungsweise der offizielle Checkpoint unterstützt.
- Serving-Limit – was ein Anbieter in seinem Produkt freigibt.
- praktisch nutzbarem Kontext – was Speicher, Latenz und Qualität in deinem konkreten Workflow sinnvoll machen.
Bei lokaler Nutzung kann ein theoretisch unterstütztes 1M-Fenster weit außerhalb dessen liegen, was auf einem gegebenen Rechner sinnvoll ist.
NVIDIA-Hardware: aufgeführt ist nicht automatisch getestet
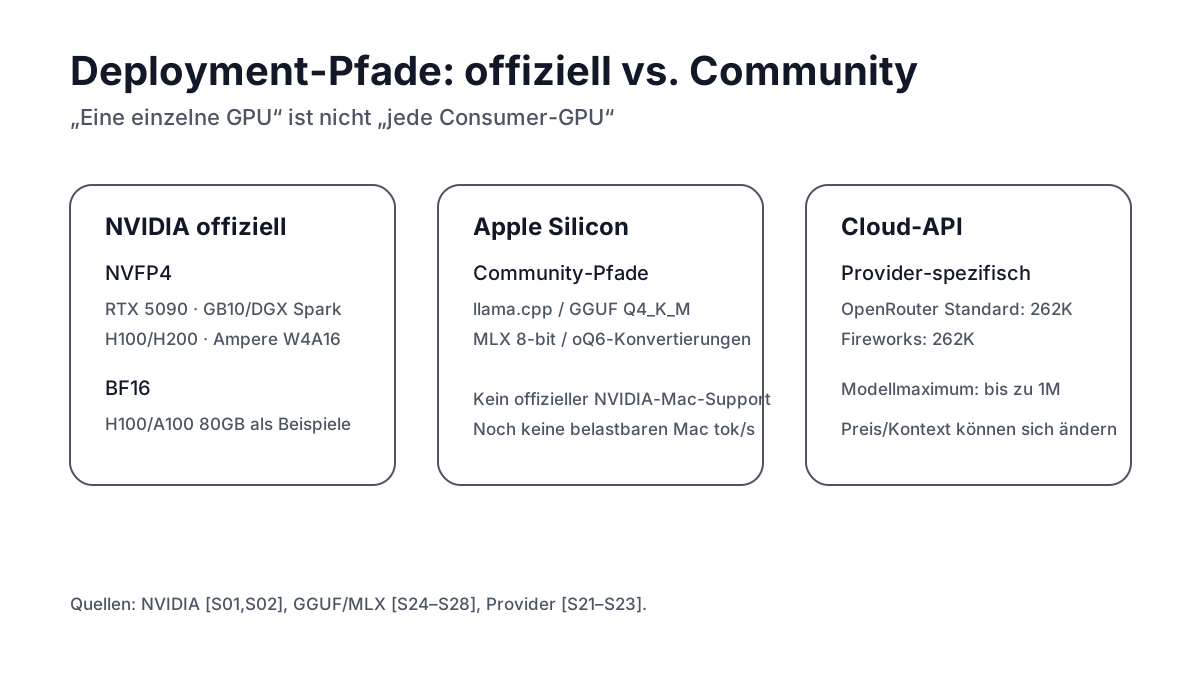
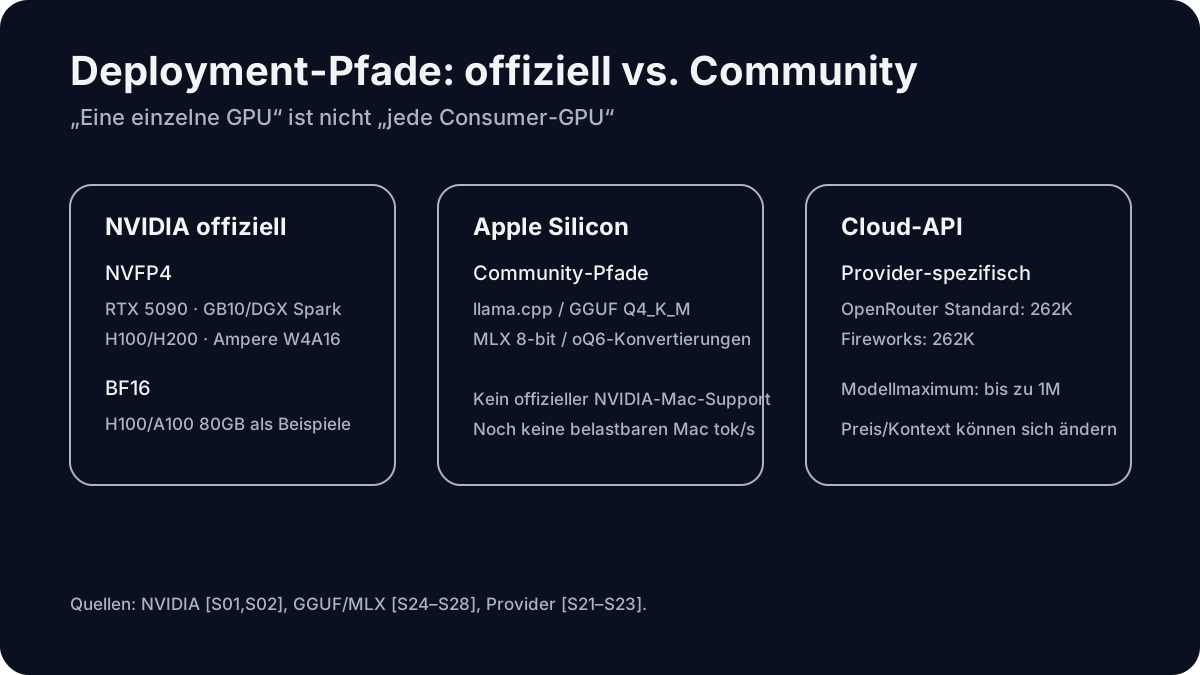
Die offizielle NVFP4-Modellkarte nennt Blackwell, Hopper und Ampere – unterscheidet in der Hardwarematrix aber die Ausführungspfade. DGX Spark / GB10 nutzt W4A16 über Marlin, keinen nativen FP4-Tensor-Core-Pfad; H100/H200 nutzen ebenfalls W4A16. GB200 hat einen nativen FP4-Pfad. Die GeForce RTX 5090 wird zwar aufgeführt, für Backend/Validierung und maximal bestätigten Kontext stehen in der Matrix aber noch offene Angaben. „Unterstützter GPU-Typ“ bedeutet nicht „vollständiger reproduzierbarer 1M-Kontext-Benchmark auf genau dieser Karte“.
Als Single-GPU-Beispiele dokumentiert NVIDIA DGX Spark und H100. Das Modell unterstützt theoretisch bis zu 1 Mio. Kontext, die reale nutzbare Länge hängt jedoch von Speicher und Serving-Rezept ab. Die NVFP4-Gewichte sind kein direktes Apple-Metal-/MLX-Paket; Mac-Konvertierungen dürfen nicht mit CUDA-Durchsatz gleichgesetzt werden.
Mac: Community-GGUF/MLX statt NVIDIA-NVFP4
NVIDIA veröffentlicht kein offizielles Apple-Silicon-Serving-Rezept für die NVFP4-Gewichte. Auf Macs verwendest du separat konvertierte GGUF- oder MLX-Gewichte. Die ggml-org-Konvertierung dokumentiert diesen llama.cpp-Pfad:
brew install llama.cpp
llama serve -hf ggml-org/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-GGUF:Q4_K_M
Alternativ ist eine Community-MLX-8-Bit-Konvertierung mit etwa 33,6 GB Paketgröße gelistet. Die GGUF-Q4_K_M-Datei liegt bei etwa 25,48 GB. Das sind Dateigrößen, keine RAM-Spitzenwerte und keine Mac-Benchmarks.
Speicherplanung: 24 GB reichen für die 25,48-GB-Q4-Datei bereits vor dem Runtime-Overhead nicht; 32 GB lassen wenig Reserve. 48–64 GB sind für Q4/Q5 mit moderatem Kontext plausibler, 64 GB+ für die 8-Bit-Variante. Beginne mit begrenztem Kontext, prüfe in Aktivitätsanzeige → Speicher den tatsächlichen Speicherdruck und teste Tool Calls sowie Textaufgaben unter gleichen Bedingungen. Die 1M-Kontextangabe ist kein vernünftiger lokaler Standardwert.
NVIDIA-RTX-/NVFP4-Durchsatzwerte sind keine Apple-Silicon-Messungen. Aus der Veröffentlichung optionaler Speculative-Decoding-Verfahren folgt nicht, dass Community-GGUFs oder MLX diese Funktionen unverändert unterstützen: Einzelne Konvertierungen entfernen oder verändern optionale Prediction-Heads. Für dieses Update wurden keine eigenen M-Chip-Tokens/s gemessen.
NVFP4 ist nicht gleich 4-Bit-GGUF: Speicher und Genauigkeit richtig einordnen
NVIDIAs offizielle Quantisierungsdokumentation beschreibt den eigenen Produktionsweg: vom 66-GB-BF16-Checkpoint zu einem rund 22 GB großen NVFP4-Checkpoint. Das Verhältnis beträgt rechnerisch 3:1, nicht die häufig aus den aktiven 3B-Parametern abgeleitete Dateigröße eines angeblichen 3B-Modells. Der Unterschied resultiert aus der Quantisierung des gesamten Modells; manche Layer bleiben in höherer Präzision und Metadaten belegen zusätzlichen Speicher. NVIDIA nennt für die verwendete Variante die Rezeptkonfiguration lightning_w4a16_nvfp4_4o6.
Warum NVIDIA nachquantisiert und destilliert
Im ersten Schritt entsteht durch Post-Training Quantization (PTQ) ein NVFP4-Schülermodell aus dem BF16-Ausgangsmodell. Danach gleicht Quantization-Aware Distillation (QAD) seine Ausgaben gegen ein eingefrorenes BF16-Lehrermodell ab. Die NVIDIA-Dokumentation unterscheidet mehrere Mischformen; four_over_six mit W4A16-Mamba-Linears ist die gewählte Veröffentlichungsvariante. Das Verfahren erklärt die angestrebte Balance aus Geschwindigkeit, Größe und Qualitätsverlust – es beweist aber nicht, dass eine beliebige nachträglich erzeugte Q4_K_M-GGUF-Datei dieselben Benchmarkwerte erreicht.
| Bereitstellung | Gewichte / bekannte Größe | Was daraus nicht folgt |
|---|---|---|
| Offiziell BF16 | 66 GB in NVIDIAs Quantisierungsleitfaden | Keine Garantie für den tatsächlichen Speicherbedarf bei 1M Kontext |
| Offiziell NVIDIA NVFP4 | ca. 22 GB, mit NVFP4-Rezept und QAD | Keine native Apple-Metal-Unterstützung allein durch Dateiformat |
| Community GGUF Q4_K_M | ca. 25,48 GB laut der verlinkten GGUF-Konvertierung | Kein identischer Modell-Digest, Quantisierungsalgorithmus oder RTX-Durchsatz |
| Community MLX 8-Bit | ca. 33,6 GB Paketangabe laut der Community-Konvertierung | Kein unabhängiger Mac-Benchmark und keine garantierte 1M-Kontextnutzung |
Mac-Praxis ohne Scheinbenchmarks: Nutze für Q4_K_M erst 4.096 Kontexttokens, bevor du größere Fenster probierst. Halte den konkreten Hugging-Face-Revision-Hash, die heruntergeladene Datei, llama.cpp-Version, Unified-Memory-Ausstattung und alle Startparameter fest. Führe dieselben fünf kleinen, synthetischen Code-/JSON-/Tool-Use-Aufgaben dreimal aus. Notiere korrekte Ergebnisse, fehlgeschlagene Tool-Aufrufe, Tokens/s aus dem eigenen Runtime-Log, Speicherhochstand und Swap. Ohne diese Messwerte wäre jede Aussage „läuft mit X tok/s auf M4/M5“ reine Spekulation.
Im offiziellen Rezeptverzeichnis hält NVIDIA fest, dass die veröffentlichten Trainingsrezepte ausschließlich offene Datensätze verwenden und ihre Reproduktionen von den veröffentlichten Hersteller-Benchmarks abweichen können. Das ist eine methodische Einschränkung und kein Beleg für niedrigere Qualität der herunterladbaren Instruct-Gewichte.
API-Preise: auffällig günstig, aber providerabhängig
OpenRouter listet den Standardendpunkt am 12. August 2026 mit:
- $0,05 pro 1 Mio. Input-Tokens
- $0,20 pro 1 Mio. Output-Tokens
- 262K Kontext 12
Fireworks nennt:
- $0,05 pro 1 Mio. Input-Tokens
- $0,01 pro 1 Mio. gecachte Input-Tokens
- $0,20 pro 1 Mio. Output-Tokens
- 262K Kontext 7
Beispielkosten bei Fireworks
Eigene Rechnung ohne Steuern und ohne sonstige Plattformkosten:
| Szenario | Input | Output | Rechnung | Kosten |
|---|---|---|---|---|
| klein | 2M | 0,5M | 2×$0,05 + 0,5×$0,20 | $0,20 |
| mittel | 25M | 5M | 25×$0,05 + 5×$0,20 | $2,25 |
| intensiv | 250M | 50M | 250×$0,05 + 50×$0,20 | $22,50 |
| intensiv, 80 % des Inputs gecacht | 250M | 50M | 50×$0,05 + 200×$0,01 + 50×$0,20 | $14,50 |
Im letzten Beispiel reduziert Caching die modellbezogenen Tokenkosten rechnerisch um rund 35,6 % gegenüber komplett ungecachetem Input. Ob ein Agent tatsächlich 80 % Cache-Hits erreicht, ist workflowabhängig.
In der Auswertung von Artificial Analysis fällt zugleich eine hohe Antwortlänge (Verbosität) im Intelligence-Test auf. Ein niedriger Preis pro Output-Token garantiert daher noch keine niedrigen Gesamtkosten pro abgeschlossener Aufgabe. 5
Welche Version sollte man herunterladen?
NVFP4: Nimm den offiziellen NVFP4-Checkpoint, wenn du auf unterstützter NVIDIA-Hardware möglichst effizient inferieren willst. NVIDIA richtet diesen Pfad ausdrücklich auf Deployment aus. 1
BF16: Nimm BF16, wenn du post-trainen, feinabstimmen, eigene Quantisierungen erzeugen oder mit den Referenzgewichten arbeiten willst. NVIDIA bezeichnet BF16 ausdrücklich als den Anpassungs-/Referenzpfad und verweist für optimierte Inferenz auf NVFP4. 11
GGUF: Nimm GGUF, wenn du llama.cpp, LM Studio, Ollama oder einen plattformübergreifenden lokalen Stack nutzen willst. Die derzeitigen GGUFs sind Community-Konvertierungen, nicht offizielle NVIDIA-Mac-Builds. 141516
MLX: Nimm MLX, wenn Apple Silicon dein Ziel ist und du eine native MLX-Laufzeit bevorzugst. Der Pfad ist aktuell besonders frisch; deshalb sollten Function Calling, lange Kontexte, Thinking-Template und MTP-Unterstützung vor produktivem Einsatz mit eigenen Tests geprüft werden. 1718
Deployment-Pfade im Überblick
Die folgende Übersicht trennt offizielle NVIDIA-Pfade, Apple-Silicon-Pfade und Cloud-Routen.
Wofür ist Lightning besonders interessant?
Das Modell passt am besten zu Workloads, bei denen dieselben Agenten viele relativ klar umrissene Aufgaben wiederholen:
- Datei- und Log-Auswertung
- Tool-Aufrufe und strukturierte API-Schritte
- Code-Änderungen und Tests
- RAG-Nachbearbeitung
- Subagenten
- Datenumformung
- Validierungsschritte
- lokale/private Assistenten mit überschaubarem Hardwarebudget
Für hochkomplexe Planung, schwierige Wissenschaftsfragen oder Aufgaben, bei denen maximale allgemeine Intelligenz wichtiger ist als Durchsatz, sprechen die derzeitigen unabhängigen Daten eher dafür, ein stärkeres Modell als Planner einzusetzen und Lightning als Worker zu nutzen. 4
Das deckt sich mit NVIDIAs Switchyard-Idee: nicht ein Modell für alles, sondern Routing zwischen einem starken Planer und einem schnellen Ausführungsmodell. 28
Grenzen, die man vor dem Einsatz kennen sollte
Erstens: Das Modell ist text-only. 5
Zweitens: Eine Million Tokens sind ein Maximalwert, keine Garantie jedes Providers oder jeder lokalen Runtime. 1127
Drittens: Die auffällig hohen NVIDIA-Benchmarkwerte sind Herstellerwerte. NVIDIA veröffentlicht zwar Harness-Informationen, doch saubere modellübergreifende Vergleiche brauchen dieselben Testbedingungen. 1
Viertens: Der Mac-Support ist derzeit Community-getrieben. Dass ein GGUF oder MLX-Checkpoint startet, beweist noch nicht, dass alle Spezialfunktionen und sehr langen Kontexte optimal funktionieren. 1417
Fünftens: Open-weight und permissiv lizenziert bedeutet nicht automatisch, dass jede konkrete Nutzung ohne weitere Datenschutz-, Compliance- oder Sicherheitsprüfung erfolgen sollte. Die Lizenz und die Datenverarbeitung des gewählten API-Anbieters sind getrennte Ebenen. 1912
Mac-Testprotokoll: Originalmodell und Community-Konvertierung sauber trennen
Jeder Vergleich muss den tatsächlich genutzten Checkpoint benennen: GGUF und MLX sind Community-Konvertierungen; die offizielle NVIDIA-NVFP4-Modellkarte beschreibt andere Inferenzkerne und GPU-Konfigurationen. Die dort genannten Durchsatzwerte sind keine Messungen auf Apple Silicon.
Prüfe die konkrete GGUF-/MLX-Revision samt SHA oder Dateiprüfsumme, Quantisierung, llama.cpp-/MLX-Version und eingestelltem Kontextfenster. Teste anschließend fünf kleine synthetische Aufgaben jeweils dreimal: JSON-Schema einhalten, Tool-Aufruf mit gültigen Argumenten, kurzen Fehler im Code finden, präzise Zusammenfassung sowie Korrektur einer fehlerhaften Antwort. Bewerte das Ergebnis über Schema-Validator und vorhandene Tests statt über bloße sprachliche Flüssigkeit. Dokumentiere Latenz, Tokens/s aus dem Runtime-Log, Speicherdruck und Swap in der Aktivitätsanzeige → Speicher.
Die Modellkarte nennt bis zu 1 Million Kontexttokens als theoretische Modellfähigkeit, nicht als nachgewiesene lokale Einstellung für jeden Mac. Die von Artificial Analysis veröffentlichten Servermessungen ersetzen keinen lokalen Test. Für diese Einordnung wurden keine eigenen M‑Chip-Benchmarks durchgeführt.
Fazit: Rolle und Grenzen des Modells
Quellentrennung: Hardware und 1M Kontext stammen von NVIDIA. GGUF/MLX-Dateigrößen und Mac-Laufzeitpfade stammen aus Community-Konvertierungen. Preise und Durchsatz des August-Snapshots beziehen sich auf Drittanbieter-Clouds; vor dem Kauf den ausgewählten Provider erneut prüfen.
Nemotron 3.5 Lightning ist am interessantesten, wenn Durchsatz, lokale Kontrolle, günstige Tokenpreise und Agentenarbeit wichtiger sind als die absolut höchste Reasoning-Leistung.
Die bislang stärkste unabhängige Evidenz zeigt genau diesen Trade-off: Intelligence Index 24 – also klar unter Qwen3.6 35B A3B und Muse Glimmer – aber außergewöhnlich hohe Serving-Geschwindigkeit auf dem getesteten NVFP4-Endpunkt. 4
Für lokale Nutzer ist die Veröffentlichung ebenfalls relevant. NVIDIA unterstützt offiziell ausgewählte NVIDIA-Hardware; gleichzeitig sind GGUF-, Ollama- und MLX-Pfade bereits verfügbar. Für Apple Silicon sollte man aktuell allerdings noch keine erfundenen Tokens/s oder 1M-Kontext-Versprechen übernehmen. Der nächste sinnvolle Schritt ist ein reproduzierbarer Mac-Benchmark auf identischer Hardware mit Q4_K_M und MLX, inklusive RAM, Prefill, Generation, Energieverbrauch, Function Calling und langem Kontext.
Der Vorgänger Nemotron 3 Ultra ist im Ollama-Cloud-Guide eingeordnet.
Quellen und Einordnung
Modellangaben stammen aus den offiziellen Model Cards, Benchmarks, API-Preise und Community-Builds aus gesondert verlinkten Quellen. Die Angaben sind keine selbst durchgeführte Apple-Silicon-Leistungsmessung.
Footnotes
Häufig gestellte Fragen
Was ist NVIDIA Nemotron 3.5 Lightning?
Ein offenes 30B-Mixture-of-Experts-Modell mit 3B aktiven Parametern, Hybridarchitektur aus Mamba-2, MoE und ausgewählten Attention-Layern, bis zu 1.000.000 Tokens Kontext, veröffentlicht unter OpenMDW 1.1 am 11. August 2026.
30B oder 31,6B Parameter? Warum gibt es unterschiedliche Zahlen?
NVIDIA vermarktet das Modell als 30B-A3B. Unabhängige beziehungsweise providerseitige Metadaten nennen 31,6B/3,6B (Artificial Analysis) oder 32,9B (Fireworks). NVIDIA erläutert die Differenz nicht ausdrücklich; bei MoE-Modellen können Zählweisen und Rundungen voneinander abweichen.
Wie schlägt sich Nemotron 3.5 Lightning in unabhängigen Benchmarks?
Artificial Analysis bewertet das Modell aktuell mit einem Intelligence Index von 24 und liegt damit unter Qwen3.6 35B A3B (32) und Muse Glimmer (35). Die herausragende Stärke ist nicht die allgemeine Intelligenz, sondern die Serving-Geschwindigkeit auf optimierten NVFP4-Endpunkten.
Was kostet die API?
OpenRouter listet 0,05 US-Dollar pro 1M Input-Token und 0,20 US-Dollar pro 1M Output-Token. Fireworks nennt zusätzlich 0,01 US-Dollar pro 1M gecachte Input-Token. Preise und Kontextlimits sind provider-spezifisch und können sich ändern.
Bedeutet 1M Kontext, dass jeder Anbieter 1M Tokens liefert?
Nein. Das 1M-Fenster ist das Modellmaximum. OpenRouter Standard und Fireworks zeigen aktuell 262K. Nur der kostenlose NVIDIA-Pfad bei OpenRouter listet 1M. Die Kontextgröße, die du nutzen kannst, hängt von Provider-Limit, Speicher und Latenzbudget ab.
Läuft Nemotron 3.5 Lightning auf Apple Silicon?
Es gibt keinen offiziellen NVIDIA-Mac-Pfad. Bereits am ersten Tag nach Release existieren Community-Konvertierungen: GGUF Q4_K_M mit 25,48 GB, MLX 8-bit mit 33,6 GB und weitere MLX/oQ6-Varianten. Belastbare Tokens-pro-Sekunde-Werte über M-Series-Chips fehlen bisher.
Welcher Checkpoint ist wofür gedacht?
NVFP4 ist NVIDIAs optimierter Inferenzpfad auf unterstützter Hardware. BF16 ist der Referenz- und Anpassungspfad, etwa für Post-Training. llama.cpp/GGUF und MLX sind Community-Pfade für lokale Runtimes. Ollama verpackt eigene Quantisierungen.
Wofür ist Lightning besonders gut geeignet?
Für hochvolumige Agentenschritte: Tool-Aufrufe, Code- und Test-Iterationen, RAG-Nachbearbeitung, Subagenten, Datei- und Log-Auswertung. Für schwierige Planung oder maximale allgemeine Intelligenz ist ein stärkeres Modell als Planner plus Lightning als Worker die bessere Architektur.