Am 9. Oktober 2026 mit Ollamas Tag-Liste und API-Dokumentation abgeglichen. Gemma 4 ist eine offene Modellfamilie von Google DeepMind mit fünf Größen: E2B, E4B, 12B, 26B A4B und 31B. Die größte Variante passt nicht automatisch zu jedem Mac. Maßgeblich sind Unified Memory, Kontext, Bild-/Audioeingabe und die Zahl parallel geöffneter Apps.
Kandidaten nach Unified Memory
| Mac | Erster Kandidat | Warum |
|---|---|---|
| 8 GB | gemma4:e2b-it-q4_K_M | konkretes 4,6-GB-Q4-Paket; kurzer Kontext, Apps schließen |
| 16 GB | gemma4:e4b oder gemma4:12b | Q4-Start möglich, aber mit begrenztem Kontext, wenigen offenen Apps und wenig Reserve |
| 24 GB | gemma4:12b | mehr Reserve als 26B; passender Start für lokale Nutzung |
| 32 GB | gemma4:26b mit begrenztem Kontext | 18-GB-Paket, MoE mit 3,8B aktiven Parametern |
| 48 GB+ | gemma4:31b oder 26b | 20- bzw. 18-GB-Paket, mehr Spielraum für Kontext |
Ollama-Paketgröße und tatsächlich benötigter Speicher sind nicht identisch. KV-Cache, Runtime, Bilder, macOS und Hintergrundprogramme kommen hinzu.
Aktuelle Ollama-Tags: Größen hängen von der Quantisierung ab
Die aktuelle Gemma-4-Tag-Liste, geprüft am 9. Oktober 2026, zeigt für einige bewegliche Aliase inzwischen Downloadgrößen als Bereiche. Eine einzige Dateigröße für gemma4:e2b oder gemma4:e4b zu nennen, wäre irreführend. Für reproduzierbare Tests brauchst du konkreten Quantisierungstag und Digest.
| Tag / Quantisierung | Gelisteter Download | Modell-Kontextlimit | Ollama-Eingabe |
|---|---|---|---|
gemma4:e2b (beweglich) | 4,6–7,5 GB | 128K | Text, Bild |
gemma4:e2b-it-q4_K_M | 4,6 GB | 128K | Text, Bild |
gemma4:e4b (beweglich) | 6,6–9,5 GB | 128K | Text, Bild |
gemma4:e4b-it-q4_K_M | 6,6 GB | 128K | Text, Bild |
gemma4:12b | 7,7–8,0 GB | 256K | Text, Bild |
gemma4:26b (26B A4B, MoE) | 16–19 GB | 256K | Text, Bild |
gemma4:31b | 19–20 GB | 256K | Text, Bild |
gemma4:e2b-mlx | 7,5 GB | 128K | Text, Bild |
gemma4:e4b-mlx | 9,5 GB | 128K | Text, Bild |
gemma4:12b-mlx | 7,7 GB | 256K | Text, Bild |
Kontextlimit ist nicht die Standard-Kontextlänge des Macs. Der KV-Cache, freier Unified Memory und andere Programme begrenzen die sinnvolle Einstellung. Google beschreibt Audio für ausgewählte Gemma-4-Varianten; diese Ollama-Einträge nennen aber Text/Bild, daher Audio nicht ohne Laufzeittest zusagen.
Gemma 4 installieren und starten
# leichter Einstieg
ollama pull gemma4:e4b
ollama run gemma4:e4b

# 12B als größere Variante bei moderater Paketgröße
ollama pull gemma4:12b
ollama run gemma4:12b
Für größere Macs:
ollama pull gemma4:26b
ollama run gemma4:26b

ollama pull gemma4:31b
ollama run gemma4:31b
Ein Bild kann über die Ollama-App oder einen kompatiblen Client zusammen mit einer Frage übergeben werden. Das Modell verarbeitet es nicht „automatisch“ in jedem Frontend; der Client muss multimodale Eingaben unterstützen.
Was Google über die Varianten sagt
Die aktuelle Google-Model-Card führt fünf Größen auf. Der Launch-Beitrag nennt im Überblick vier Varianten und hebt beim Audioeingang E2B und E4B hervor; für die zusätzliche 12B-Angabe ist deshalb die aktuelle Model-Card maßgeblich.
Die Google-Model-Card beschreibt:
- E2B und E4B als kleine Modelle mit 128K Kontext,
- 12B und 31B als Dense-Varianten mit 256K Kontext,
- 26B A4B als MoE-Modell mit 25,2B Gesamt- und 3,8B aktiven Parametern,
- Text- und Bildverarbeitung in der Familie,
- native Audio-Unterstützung bei E2B, E4B und 12B,
- konfigurierbare Thinking-Modi und native Function-Calling-Unterstützung.
Die Audioangabe stammt von Google. Dass ein Modell Audio unterstützt, heißt nicht automatisch, dass der konkrete Ollama-Tag oder dein Client eine Audiodatei annimmt. Diese Verbindung musst du separat prüfen.
Speichergrenzen von 12B, 26B und 31B
gemma4:26b kann auf einem 24-GB-Mac theoretisch startbar sein, aber ein 18-GB-Paket lässt nach Betriebssystem, Runtime und Kontext wenig Reserve. Für einen ersten lokalen Alltagstest ist gemma4:12b deshalb die vorsichtigere Wahl.
Auf 32 GB passt 26B mit begrenztem Kontext besser. 31B Dense ist mit 20 GB gelistet und braucht entsprechend mehr freie Ressourcen. Ob ein Setup nutzbar ist, hängt von Kontext, Bildauflösung, parallelen Apps und der Runtime ab.
Nach dem Start prüfen:
ollama psWenn Ollama Teile auf die CPU auslagert oder macOS Speicherdruck anzeigt, reduziere Kontext und schließe Apps. Ein großes Modell mit einem kurzen Kontext kann im Alltag sinnvoller sein als dieselbe Variante mit einem nominell maximalen Kontextfenster.
Thinking-Modus mit Bedacht einsetzen
Gemma 4 unterstützt konfigurierbare Thinking-Modi. Mehr internes Reasoning kann bei Mathematik, Planung und komplexem Coding helfen, erhöht aber Rechenzeit und Tokenverbrauch. Für kurze Fragen ist ein knapper Modus oft die bessere Nutzererfahrung.
Behandle Thinking nicht als Qualitätsgarantie. Entscheidend ist, ob die zusätzliche Rechenzeit in deinem konkreten Workflow weniger Fehler erzeugt. Bei lokalen Tests solltest du Modus, Kontext und Aufgaben identisch halten, wenn du Varianten vergleichen willst.
Gemma 4 und Qwen3.6
Beide Familien bieten lokale Mac-Tags und multimodale Varianten. Eine pauschale Aussage wie „Qwen für Coding, Gemma für Bilder“ ist zu grob. Vergleiche stattdessen:
- exakten Modelltag und Paketgröße,
- Bild- und Audio-Unterstützung des Clients,
- Kontext und KV-Cache,
- Lizenz und Datenfluss,
- Leistung auf deinem eigenen Aufgabenpaket.
Herstellerbenchmarks sind nützlich, aber nicht ohne gleiche Runtime, gleiche Prompts und gleiche Auswertung direkt vergleichbar. Eine Gegenüberstellung der beiden Familien findest du im Gemma-4-vs.-Qwen3.6-Vergleich und die kompakte 12B-Einordnung im Gemma-4-12B-Artikel.
Reproduzierbarer Check auf 8-/16-GB-Macs
Verwende einen konkreten Quantisierungstag statt eines wechselnden Alias:
ollama pull gemma4:e2b-it-q4_K_M
ollama show gemma4:e2b-it-q4_K_M
ollama run gemma4:e2b-it-q4_K_M
Beginne mit kleinem Arbeitskontext (beispielsweise 4K in deinem Ollama-Client). Miss bei denselben Text- und Bildaufgaben Modelltag/Digest, Prefill, Ausgabetempo sowie Speicherdruck und Swap in Aktivitätsanzeige → Speicher. ollama ps zeigt geladene Modelle, aber nicht den gesamten macOS-Speicherdruck. Größere Modelle wie gemma4:12b nur mit gleichen Prompts und gleicher Kontextlänge vergleichen.
Ein echter Mac-Vergleich: Gemma 4 in Ollama messen
Eine Downloadgröße ist keine Geschwindigkeitsmessung. Ollamas offizielle Generate-API liefert die Anzahl erzeugter Tokens und drei getrennte Zeiten: load_duration, prompt_eval_duration und eval_duration (jeweils Nanosekunden). Daraus kannst du deine eigenen Tokens pro Sekunde berechnen, statt fremde Mac-Benchmarks zu übernehmen.
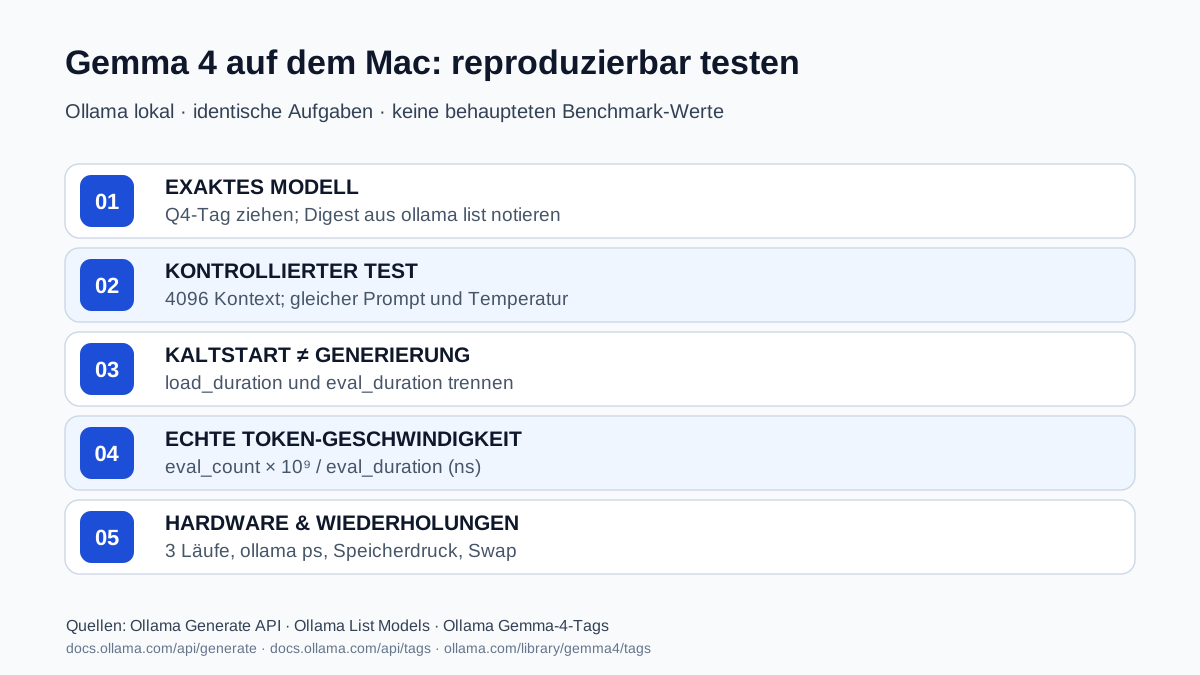
Messprotokoll für einen Mac mit 8 oder 16 GB
- Modell festlegen:
gemma4:e2b-it-q4_K_Mherunterladen, danach mitollama listdie lokale Modell-ID/Digest notieren. Ein sprechender Tag allein reicht bei späteren Updates nicht für einen Vergleich. Die Ollama-Tag-Liste nennt für diesen Q4-Tag etwa 4,6 GB Download, nicht 4,6 GB garantierten RAM-Verbrauch. - Kontext und Prompt konstant halten: zunächst
num_ctx: 4096verwenden. Bei einem Vergleich zwischen Modellen dieselben Testaufgaben, Temperatur und Kontext-Einstellung beibehalten. Eine Temperatur von null ist keine Garantie für bitweise identische Antworten. - Laden und Generieren trennen: einen ersten Aufruf zum Warmwerden durchführen und weitere identische Anfragen messen. Der erste Request kann zusätzliche Modell-Ladezeit enthalten. Andere Anwendungen und macOS-Speicherdruck dokumentieren.
- Wiederholen: je Modell mindestens drei Durchläufe protokollieren und nicht den besten Einzelwert herauspicken. Bildtests nur mit tatsächlich unterstützter Bildeingabe separat auswerten.
Voraussetzungen: eine funktionierende lokale Ollama-Installation, das gezogene Modell und für die kompakte Auswertung optional jq (z. B. brew install jq). Die API verwendet ausschließlich 127.0.0.1:11434. Wenn das Modell noch nicht installiert ist, erst ollama pull gemma4:e2b-it-q4_K_M ausführen.
ollama list
ollama show gemma4:e2b-it-q4_K_M

# Textprompt für wiederholbare lokale Messung. Antwort und Metriken
# in einer JSON-Datei speichern. Keine unbekannten Skripte ausführen.
curl -fsS http://127.0.0.1:11434/api/generate \
  -H 'Content-Type: application/json' \
  -d '{"model":"gemma4:e2b-it-q4_K_M","prompt":"Nenne drei nachvollziehbare Gründe für Code-Reviews.","stream":false,"options":{"num_ctx":4096,"temperature":0}}' \
  > gemma4-mac-test.json

# Nur falls jq installiert ist:
jq '{model, load_seconds:(.load_duration / 1000000000), prompt_tokens:.prompt_eval_count, output_tokens:.eval_count, output_tokens_per_second:(if (.eval_duration // 0) > 0 then (.eval_count * 1000000000 / .eval_duration) else null end)}' gemma4-mac-test.json
ollama ps
So liest du die Ausgabe: eval_count / (eval_duration / 1.000.000.000) beschreibt die generierten Ausgabe-Tokens pro Sekunde, nicht die Gesamtlatenz einschließlich Laden und Prompt-Verarbeitung. load_duration hilft, Kaltstart und warmen Lauf zu unterscheiden; prompt_eval_count ist für Prefill relevant. Prüfe anschließend in Aktivitätsanzeige → Speicher den Speicherdruck und Swap. Die ausgegebene JSON-Datei ist lokal; sie enthält die Modellantwort und gehört nicht ungeprüft in ein öffentliches Repository.
| Für einen fairen Vergleich festhalten | Warum es zählt |
|---|---|
| Apple-Chip, Unified Memory, macOS, Ollama-Version | Hardware- und Runtime-Unterschiede |
Modelltag und Digest aus ollama list | Nachvollziehbarer exakter Checkpoint |
num_ctx, Temperatur, Prompt und Modalität | Gleiche Arbeitslast |
load_duration, prompt_eval_duration, eval_duration | Laden, Eingabe und Ausgabe nicht vermischen |
eval_count, Tokens/s und drei Wiederholungen | Messung statt geschätzter Geschwindigkeit |
ollama ps, Speicherdruck und Swap | Praktische Nutzbarkeit statt Paketgröße |
Einordnung: Die oben stehenden Befehle sind ein Testprotokoll, keine hier gemessenen Ergebnisse. Sie belegen weder 128K/256K nutzbaren Kontext auf deinem Mac noch Bild-/Audio-Support in jedem Client. Modellbezogene Tagespreise entfallen bei lokaler Ausführung; Stromverbrauch und Hardware bleiben dennoch echte Kosten.
Gemma 4 auf dem eigenen Mac testen
Ein reproduzierbarer lokaler Vergleich dokumentiert:
- Mac-Modell und Unified Memory,
- macOS- und Ollama-Version,
- Tag und Backend inklusive MLX/QAT,
- Kontext und Bildauflösung,
- Antwortzeit und Tokens pro Sekunde,
- CPU-/GPU-Aufteilung aus
ollama ps, - Speicherdruck bei einer realistischen Aufgabe.
Fazit: Fünf Größen für verschiedene Speicherklassen
Die fünf Modellgrößen decken mehrere lokale Mac-Speicherklassen ab. E2B/E4B sind die kleinen Optionen, 12B ist auf 16 GB als Q4-Test mit begrenztem Kontext möglich und auf 24 GB mit mehr Reserve nutzbar, 26B A4B passt zu einem geplanten 32-GB-Setup und 31B braucht mehr Reserve.
Starte mit dem kleinsten Tag, der deine Aufgabe erfüllt. Erhöhe dann Modellgröße oder Kontext einzeln und prüfe jedes Mal ollama ps. Damit basiert die Auswahl auf dem getesteten Tag und dem Speicherlimit deines Macs.
Quellen
- Google Gemma 4 Model Card – Größen, Modalitäten, Kontext, Architektur und Benchmarks.
- Google: Gemma 4 – Positionierung und Lizenz.
- Ollama: Gemma 4 – aktuelle Tags, Paketgrößen und Kontextwerte.
- Ollama: Liste der lokalen Modelle – Modellname, Digest und Quantisierung.
- Ollama: Generate-API –
stream:false, Laufzeitfelder in Nanosekunden, gezählte Tokens.
Häufig gestellte Fragen
Welche Gemma-4-Variante passt auf einen 24-GB-Mac?
`gemma4:12b` ist der vorsichtige Start mit mehr Reserve. `gemma4:26b` hat ein 18-GB-Paket und lässt nach macOS, Runtime und Kontext wenig Spielraum.
Kann Gemma 4 Audio verarbeiten?
Google nennt native Audio-Unterstützung für E2B, E4B und 12B. Ob dein konkreter Ollama-Tag oder Client eine Audiodatei annimmt, musst du separat prüfen; die Tag-Liste führt primär Text und Bild.
Was ist 26B A4B bei Gemma 4?
Ein MoE-Modell mit 25,2 Milliarden Gesamtparametern, von denen pro Token etwa 3,8 Milliarden aktiv sind. Effizienter als ein dichtes 31B, aber nicht speicherfrei — das Paket ist weiterhin rund 18 GB groß.
Sollte ich den Thinking-Modus immer einschalten?
Nein. Mehr internes Reasoning hilft bei Mathematik, Planung und komplexem Coding, kostet aber Rechenzeit und Tokens. Für kurze Fragen ist ein knapper Modus oft die bessere Wahl.
Wie vergleiche ich Gemma 4 mit Qwen3.6 sinnvoll?
Nicht über pauschale Slogans, sondern mit gleichem Tag, gleicher Runtime, gleichen Prompts und eigenen Aufgaben. Herstellerbenchmarks sind ohne identische Bedingungen nicht direkt vergleichbar.