Aktualisiert am 8. Oktober 2026; die Launch-Benchmarks beziehen sich weiterhin auf den 22. September. Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht. Das neue Opus-Modell kostet in der direkten API 4 US-Dollar pro 1 Mio. Input-Tokens und 20 US-Dollar pro 1 Mio. Output-Tokens. Prompt-Cache-Reads kosten 0,20 US-Dollar pro 1 Mio. Tokens, Cache-Writes 5 US-Dollar. Anthropic beziffert den Geschwindigkeitszuwachs auf über 30 Prozent höhere Ausgabegeschwindigkeit gegenüber Opus 5 und bewirbt für typische Workloads rund 40 Prozent niedrigere Gesamtkosten. Anthropic, 22.09.2026
Der entscheidende Punkt ist allerdings nicht ein einzelner Benchmark. Opus 5.5 kombiniert deutlich niedrigere Preise mit höheren von Anthropic gemessenen Agenten- und Coding-Scores. Die hier genannten September-Launch-Scores sind weiterhin Anbieterwerte und keine von uns unter identischem Harness reproduzierten Messungen. Reuters, TechCrunch und VentureBeat bestätigen Release und Preisdaten, die Benchmarkwerte stammen jedoch primär aus Anthropics eigener Veröffentlichung. Reuters, 22.09.2026 VentureBeat, 22.09.2026
Claude Opus 5.5: Preis und wichtigste Daten
| Punkt | Claude Opus 5.5 | Einordnung |
|---|---|---|
| Release | 22.09.2026 | offiziell veröffentlicht |
| API-Modellname | claude-opus-5-5 | von Anthropic angegeben |
| Input | $4 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Output | $20 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Cache-Read | $0,20 / 1 Mio. Tokens | 60 % weniger als Opus 5 |
| Cache-Write | $5 / 1 Mio. Tokens | 20 % weniger als Opus 5 |
| Fast Mode | $8 Input / $40 Output | bis zu 2,5× schneller laut Anthropic |
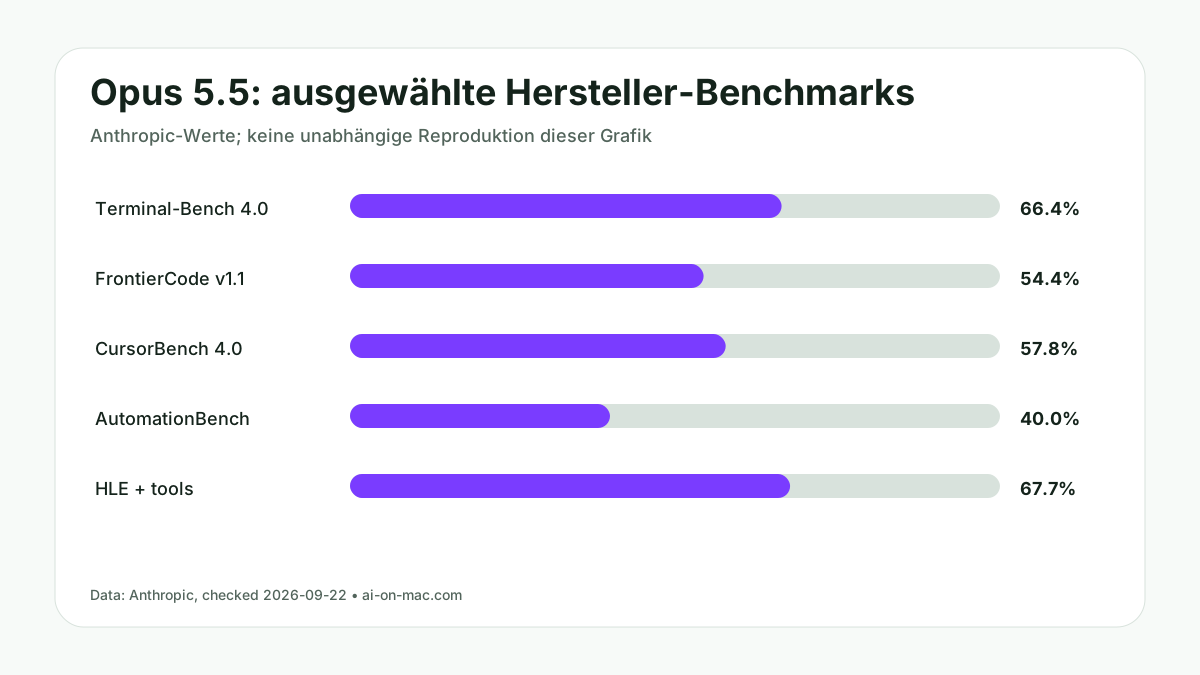
| Terminal-Bench 4.0 | 66,4 % | Anthropic-Messung, max effort |
| FrontierCode v1.1 Main | 54,4 % | Anthropic-Messung |
| CursorBench 4.0 | 57,8 % | Anthropic-Messung |
| GDPval-AA v2.1 | Elo 1846 | Anthropic-Messung |
| AutomationBench | 40,0 % | Early-Access-Setup laut Anthropic |
| HLE mit Tools | 67,7 % | Anthropic-Messung |
Quelle für Preise und Benchmarkwerte: Anthropic. Datenstand: 22.09.2026. Die Score-Zeilen sind Herstellerwerte, keine von uns reproduzierten Messungen.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist das erste Modell der Claude-5.5-Familie. Anthropic positioniert es als leistungsstarkes Modell für Coding, agentische Aufgaben und anspruchsvolle Wissensarbeit. Der Anbieter sagt, Opus 5.5 erreiche bei den meisten Arbeiten das Niveau von Fable 5.1, sei aber günstiger. Sonnet 5.5 ist seit dem 28. September und Haiku 5.5 seit dem 7. Oktober 2026 verfügbar. Die Entscheidung für neue Agenten sollte deshalb auch die günstigeren Modelle einbeziehen. Anthropic
Für Entwickler ist die wichtigste praktische Kennung der Modellname claude-opus-5-5. Anthropic dokumentiert die Verfügbarkeit auf den eigenen Plattformen sowie über Amazon Web Services, Google Cloud und Microsoft Azure. Cloud-Provider-Dokumentationen können am Veröffentlichungstag zeitversetzt aktualisiert werden; eine noch fehlende Zeile in einer Provider-Tabelle ist daher kein Beleg dafür, dass das Modell dort grundsätzlich nicht verfügbar ist.
Preise: Opus 5.5 ist pro Token 20 Prozent günstiger als Opus 5
Anthropic senkt den Standardpreis von Opus 5 auf Opus 5.5 von $5 auf $4 pro 1 Mio. Input-Tokens und von $25 auf $20 pro 1 Mio. Output-Tokens. Das entspricht jeweils 20 Prozent weniger. Besonders stark fällt die Senkung bei wiederverwendetem Prompt-Kontext aus: Cache-Reads sinken von $0,50 auf $0,20 pro 1 Mio. Tokens, also um 60 Prozent. Anthropic
| Preisbestandteil | Opus 5 | Opus 5.5 | Veränderung |
|---|---|---|---|
| Input / 1 Mio. Tokens | $5,00 | $4,00 | −20 % |
| Output / 1 Mio. Tokens | $25,00 | $20,00 | −20 % |
| Cache-Write / 1 Mio. Tokens | $6,25 | $5,00 | −20 % |
| Cache-Read / 1 Mio. Tokens | $0,50 | $0,20 | −60 % |
Eigene Kostenrechnung: gleiche Tokenmengen
Nehmen wir einen cache-intensiven Agenten-Workflow mit 10 Mio. normalen Input-Tokens, 2 Mio. Output-Tokens, 100 Mio. Cache-Read-Tokens und 10 Mio. Cache-Write-Tokens pro Abrechnungszeitraum.
Opus 5.5: 10×$4 + 2×$20 + 100×$0,20 + 10×$5 = $150.
Opus 5: 10×$5 + 2×$25 + 100×$0,50 + 10×$6,25 = $212,50.
Bei exakt derselben Tokenmenge wäre Opus 5.5 in diesem Beispiel 29,4 Prozent günstiger. Diese Rechnung ist absichtlich von Anthropics Angabe „40 Prozent günstiger bei typischen Workloads“ getrennt. Die 40-Prozent-Angabe berücksichtigt laut Anthropic zusätzlich, dass Opus 5.5 Aufgaben mit weniger Tokens erledigen kann; diese Effizienz haben wir nicht selbst reproduziert.


Deutschland: API-Tarife und deutsche Abrechnung
Die ausgewiesenen 4 USD Input und 20 USD Output je Million Tokens sind Anthropic-API-Listenpreise in US-Dollar, keine deutschen Claude-Pro- oder Max-Abopreise und keine Euro-Endkundenbeträge. Umsatzsteuer, Rechnungsausstellung, Umrechnung und Provideraufschläge hängen vom Vertrag und Rechnungsempfänger ab. Die Sprache einer Anfrage bestimmt weder die Inferenzregion noch die Datenaufbewahrung. Bei vertraulichen Daten sind der gewählte Endpunkt, Subprozessoren, Übermittlungen in Drittländer und eventuelle Data-Residency-Optionen zu prüfen. Der API-Parameter inference_geo: "us" wählt, falls unterstützt, ausdrücklich US-Inferenz und kann einen Aufschlag auslösen. Anthropic-Preise.
Fast Mode: doppelte Tokenpreise für bis zu 2,5-fache Geschwindigkeit
Für Opus 5.5 nennt Anthropic einen Fast Mode mit $8 pro 1 Mio. Input-Tokens und $40 pro 1 Mio. Output-Tokens. Das ist gegenüber dem Standardtarif der doppelte Tokenpreis. Dafür verspricht Anthropic eine Geschwindigkeit von bis zu 2,5×. Ob sich das lohnt, hängt nicht allein von Tokens ab: Für interaktive Coding-Agenten oder zeitkritische Workflows kann kürzere Wartezeit wirtschaftlich wichtiger sein als der reine API-Preis. Für Batch-Jobs ohne Zeitdruck ist der Standardmodus in der Regel leichter zu rechtfertigen. Anthropic
Benchmarks: Wo Opus 5.5 laut Anthropic zulegt
Anthropic veröffentlicht mehrere Agenten-, Coding- und Knowledge-Work-Werte. Besonders auffällig ist Terminal-Bench 4.0 mit 66,4 Prozent, gegenüber 52,3 Prozent für Opus 5 in derselben Anthropic-Tabelle. Bei FrontierCode v1.1 Main werden 54,4 Prozent ausgewiesen, bei CursorBench 4.0 57,8 Prozent. GDPval-AA v2.1 liegt bei 1846 Elo. Anthropic
Diese Zahlen sollten nicht als universelle Rangliste gelesen werden. Benchmarkresultate hängen von Modellversion, Agenten-Harness, Toolzugriff, Effort-Einstellung, Sampling und Auswertungsregeln ab. Snorkels Terminal-Bench-Leaderboard und unabhängige Benchmark-Tracker machen genau diese Vergleichbarkeit zum Thema. Snorkel AI LLMCompare
Noch wichtiger: Die ursprünglichen Benchmarkwerte stammen vom 22. September 2026. Eine unabhängige, reproduzierbare Same-Harness-Serie über alle von Anthropic genannten Benchmarks lag bei unserer Prüfung noch nicht vor. VentureBeat weist bei Vergleichen mit aktuellen OpenAI-Modellen ebenfalls darauf hin, dass nicht überall ein sauberer öffentlicher Same-Harness-Vergleich existiert. Das ist kein Gegenbeweis gegen Anthropics Werte, aber ein Grund, sie als Hersteller-Benchmarks zu kennzeichnen. VentureBeat
Coding und Agenten: der interessanteste Einsatzbereich
Anthropics größte Verbesserungen liegen dort, wo ein Modell länger selbstständig arbeiten muss: Terminal-Aufgaben, Repository-Arbeit, Tool-Nutzung und mehrstufige Automatisierung. Der Anbieter nennt unter anderem einen frühen Test an einer Codebasis mit rund 200.000 Zeilen, der mit Opus 5.5 in weniger als drei Stunden abgeschlossen worden sei, während Opus 5 mehr als 20 Stunden gebraucht habe. In einem internen C-zu-Rust-Projekt für HAProxy berichtet Anthropic von 9,5 Stunden gegenüber 12 Stunden mit Fable 5.1 und 51 Prozent weniger Tokenverbrauch. Anthropic
Diese Beispiele sind interessant, aber keine neutralen Laborbenchmarks. Für die eigene Entscheidung ist deshalb ein Pilot mit realen Repositories sinnvoller: identische Issues, identische Toolrechte, identischer Harness, mehrere Wiederholungen und Messung von Erfolgsquote, Zeit, Tokens und nötigen menschlichen Korrekturen.
Sicherheitsänderungen: stärkere Guardrails und transparente Fallbacks
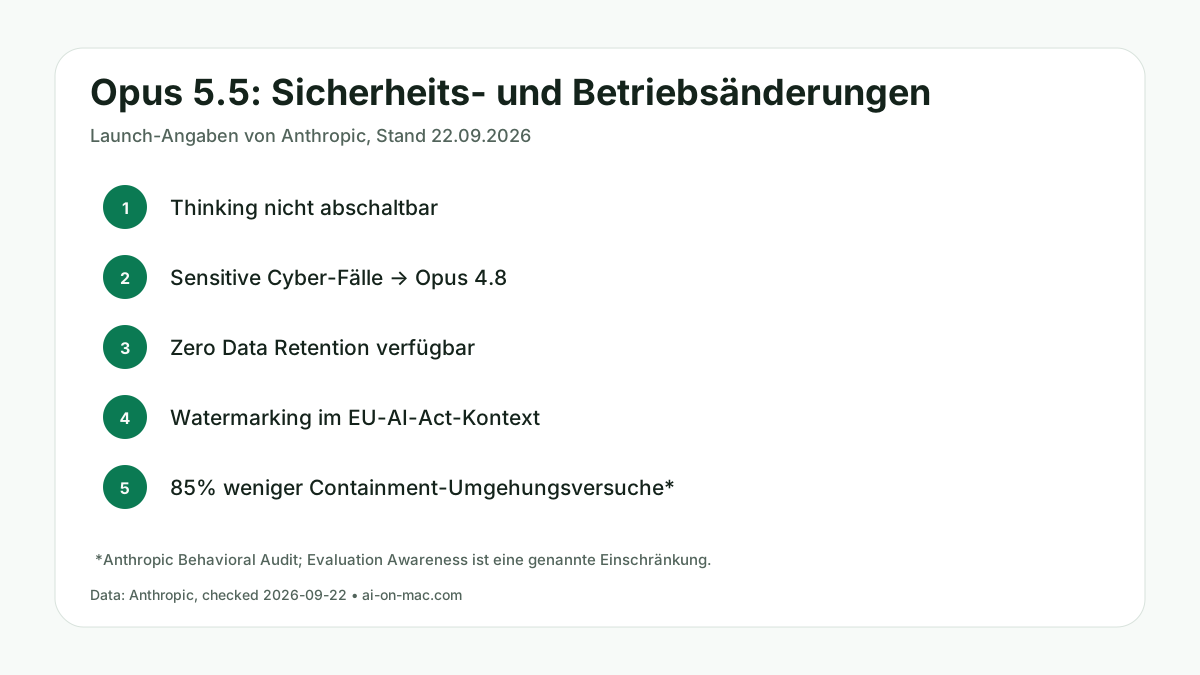
Opus 5.5 übernimmt Sicherheitsmechanismen auf dem Niveau von Fable 5.1 für bestimmte Cyber- und Biologie-Risiken. Bei bestimmten sensitiven Cyber-Aufgaben kann die Anfrage auf Opus 4.8 umgeleitet werden; normale Softwareentwicklung, etwa das Finden und Beheben von Bugs, soll weiterhin möglich bleiben. Anthropic dokumentiert begleitend einen Behavioral Audit mit rund 2.000 Szenarien und berichtet von 85 Prozent weniger Versuchen, Containment zu umgehen, verglichen mit Opus 5 oder Mythos 5.1. Anthropic nennt zugleich eine wichtige Einschränkung: Evaluation Awareness bleibt ein Problem bei der Interpretation solcher Tests. Anthropic The Verge
Weitere Änderungen: Der Thinking Mode lässt sich bei Opus 5.5 nicht mehr vollständig abschalten. Anthropic nennt eine Option für Zero Data Retention und verweist auf Watermarking im Kontext des EU AI Act. Wer sensible Unternehmensdaten verarbeitet, sollte trotzdem die konkrete Vertrags-, Region- und Cloud-Konfiguration prüfen; ein allgemeiner Produkt-Hinweis ersetzt keine Prüfung des eigenen Kontos.
API-Stand am 8. Oktober: Kontext, Batch und echte Migrationsrisiken
Anthropics eigene Modellseite für Opus 5.5 dokumentiert jetzt 1 Mio. Kontext-Tokens, 128K regulären Maximal-Output und 300K Batch-Output als Beta (mit Header output-300k-2026-03-24). Adaptives Thinking ist verpflichtend; die Standard-Effort-Stufe lautet medium. Für Prompt Caching sind mindestens 512 Tokens erforderlich. Der Batch-Tarif reduziert Input und Output um 50 % – nicht automatisch Cache-Writes oder Sondermodi.
Vier Breaking Changes sind bei bestehenden Agenten relevant:
- Thinking lässt sich nicht mehr deaktivieren. Den Denkaufwand über
effortsteuern. - Erzwungene Tool-Nutzung führt zu einem Fehler.
tool_choiceund Fallbacks testen statt alte Opus-5-Requests unverändert zu übernehmen. - Thinking-Blöcke sind an Modell und Konversation gebunden. Ein blindes Replay beim Modellwechsel kann die Sitzung beschädigen.
- Das ältere Computer-Use-Tool
computer_20251124wird in der Claude API und auf Google Cloud nicht akzeptiert.
Hinzu kommt eine subtile UI-Änderung: Bei der voreingestellten display-Konfiguration wird Text zwischen Tool-Aufrufen als Thinking-Block ohne sichtbaren Text übertragen. Wer dies als Fortschrittsanzeige nutzt, sieht plötzlich keine Zwischenausgabe, obwohl die Anfrage nicht fehlgeschlagen ist.
Ein Agenten-Benchmark auf dem Mac sollte Kosten je erfolgreich bearbeitetem Ticket, identische Toolrechte und gleiches Repository berücksichtigen. Die Cache-Tarife vom 8. Oktober lauten $5/M für 5 Minuten Schreiben, $8/M für 1 Stunde Schreiben und $0,20/M für Reads. Opus 5.5 ist weiterhin ein Cloud-Modell; es gibt keinen lokalen Download.
Lohnt sich der Wechsel von Opus 5 auf Opus 5.5?
Für bestehende Opus-5-Workloads ist die ökonomische Richtung klar: Der nominelle Input- und Outputpreis fällt um 20 Prozent, Cache-Reads werden 60 Prozent günstiger, und Anthropic berichtet zugleich bessere Agenten- und Coding-Leistung. Das macht einen Test besonders attraktiv für Workloads mit langen, wiederverwendbaren Kontexten und vielen Toolschritten.
Ein sofortiger Produktionswechsel ohne Vergleichslauf ist trotzdem nicht automatisch sinnvoll. Prüfe mindestens:
- Erfolgsquote auf deinen echten Aufgaben statt nur öffentliche Benchmarks.
- Gesamttokens pro erfolgreich erledigtem Task.
- P50/P95-Latenz und Time-to-completion.
- Häufigkeit menschlicher Korrekturen.
- Unterschiede durch verpflichtendes Thinking.
- Sicherheits-Fallbacks bei deinem Einsatzgebiet.
- Cloud-Region, Datenhaltung und tatsächlichen Providerpreis.


Opus 5.5 vs. Fable 5.1: warum Preis pro Token nicht alles ist
Anthropic sagt, Opus 5.5 erreiche bei den meisten Arbeiten ungefähr Fable-5.1-Niveau, während der Standardpreis deutlich niedriger liegt. Ein einfacher uncached Vergleich von 1 Mio. Input plus 1 Mio. Output ergibt für Opus 5.5 $24. Bei Fable 5.1 wären es nach Anthropics Preisstruktur $60. Das ist rechnerisch 60 Prozent weniger für Opus 5.5 bei dieser künstlich gleichen Tokenmenge.
Das bedeutet nicht, dass jeder reale Auftrag 60 Prozent günstiger wird. Modelle können unterschiedlich viele Tokens benötigen, andere Toolpfade wählen und sich in Erfolgsquote oder Korrekturbedarf unterscheiden. Die belastbarere Kennzahl lautet deshalb Kosten pro erfolgreich erledigter Aufgabe statt des reinen Preises pro Million Tokens.
Claude Opus 5.5: Einordnung für den Modellwechsel
Claude Opus 5.5 ist keine bloße Umbenennung von Opus 5. Anthropic senkt die direkten Tokenpreise, besonders stark die Cache-Read-Kosten, erhöht nach eigenen Messungen die Geschwindigkeit und meldet deutliche Fortschritte bei Agenten- und Coding-Benchmarks. Die API-Kennung lautet claude-opus-5-5, und die Veröffentlichung umfasst Anthropic sowie AWS, Google Cloud und Microsoft Azure. Anthropic Reuters
Die wichtigste Einschränkung auch am 8. Oktober: Die detaillierten Leistungswerte sind überwiegend Herstellerdaten. Für eine belastbare Modellwahl sollten Teams Opus 5.5 auf eigenen Aufgaben gegen Opus 5, Fable 5.1 und relevante Konkurrenzmodelle testen – mit identischem Harness und mit Kosten pro erfolgreichem Task als zentraler Kennzahl.
Für preissensiblere Workloads sind Claude Sonnet 5.5 und Claude Fable 5.1 die naheliegenden Vergleichskandidaten.
Transparenz
Quellen und Prüfgrundlage
Diese Primär- und Referenzquellen bilden die Grundlage der technischen Einordnung. Herstellerangaben und externe Benchmarks werden im Artikel als solche gekennzeichnet.
- anthropic.com claude-opus-5-5
- reuters.com business / anthropic-unveils-claude-opus-55-2026-09-22
- venturebeat.com technology / anthropic-releases-claude-opus-5-5-beating-fable-5-1-on-key-agentic-benchmarks-at-60-cheaper-api-price
- snorkel.ai leaderboard / terminal-bench-4-0
- llmcompare-drab.vercel.app benchmarks / terminal-bench-4
- theverge.com 998868 / anthropic-claude-opus-5-5-cybersecurity
- platform.claude.com about-claude / pricing
- platform.claude.com opus-5-5 / overview
- platform.claude.com sonnet-5-5 / overview
- platform.claude.com haiku-5-5 / overview