Wichtige Aktualisierung vom 19. Oktober 2026 – M2.7 wird eingestellt. MiniMax hat die Cloud-API-Familien M2.5 und M2.7 zum 18. November 2026 abgekündigt. Für neue Kunden sind sie seit dem 19. Oktober nicht mehr verfügbar. Unter M Plan und Token Plan leitet MiniMax Requests mit M2.5-/M2.7-Modell-IDs seit dem 19. Oktober automatisch zu M3.1 Flash um; bestehende Namen bleiben zunächst kompatibel, die Plankontingente unverändert. Bestehende Pay-as-you-go-Nutzer können M2.7 nur bis 18. November über die MiniMax-API aufrufen und müssen vorher migrieren. Bereits heruntergeladene Open Weights sind von der Abschaltung der Cloud-API nicht betroffen. Wichtig: M3.1 Flash hat Always-on Reasoning statt abschaltbarem Thinking; Verhalten und Tool-Aufrufe neu testen. Offizielle Modell-/Abschaltliste von MiniMax. Einzelheiten, API-Preise und Migration im aktualisierten M3.1-Flash-Artikel.
Neuere Version: Dieser Artikel beschreibt MiniMax M2.7. Die neuere Version MiniMax M3.1 Flash ist inzwischen verfügbar.
Quellenstand 12. Oktober 2026: MiniMax führt M Plan (Go / Explore / Build) und den bisherigen Token Plan (Plus / Max / Ultra) auf unterschiedlichen offiziellen Seiten. Die Token-Plan-FAQ bestätigt ausdrücklich die Fortführung bestehender Abos; die Token-Plan-Verkaufsseite ist weiterhin abrufbar. Ob ein Neuabschluss für dein Konto möglich ist, lässt sich daraus nicht sicher ableiten. Eine M2.7-Pay-as-you-go-API wird separat nach Tokens berechnet. USD-Listenpreise sind keine deutschen Endpreise; ein Mac-Cloud-Client führt das Modell nicht lokal aus.
Die drei Mac-Zugriffswege
MiniMax M2.7 ist ein Modell für Coding-, Agenten- und Office-Workflows. Auf dem Mac gibt es drei verschiedene Zugriffssituationen, die nicht vermischt werden sollten:
- MiniMax-API: Mit einem regulären Pay-as-you-go-API-Key wird die Cloud-Nutzung nach Tokens abgerechnet. Ein Subscription Key gilt nur für die Modelle, die dein gebuchter Plan tatsächlich freigibt; M2.7 ist in der neuen M-Plan-Modellmatrix nicht ausdrücklich genannt.
- Ollama Cloud:
ollama run minimax-m2.7:cloudnutzt Ollama als lokalen Client; die Berechnung läuft in der Cloud. - Selbst gehostete Gewichte: Hugging Face listet M2.7 als Open-Weight-Modell und nennt SGLang, vLLM und Transformers als Serverpfade. Daraus folgt aber kein offiziell getesteter Apple-Silicon- oder MLX-Workflow.
Die Geschwindigkeits- und Benchmarkwerte stammen von MiniMax; unabhängige Token-pro-Sekunde-Messungen auf Apple Silicon liegen nicht vor.
Was MiniMax M2.7 technisch auszeichnet
Die offiziellen MiniMax-Seiten und die Modellkarte stellen M2.7 als agentisches Modell für komplexe Produktivitätsaufgaben dar. Genannt werden unter anderem Agent Teams, komplexe Skills, dynamische Tool-Suche, Software Engineering und Office-Dokumente. MiniMax-Modellseite M2.7-Ankündigung
Kontext und Geschwindigkeit
| Variante | Kontextfenster | Anbieterangabe zur Geschwindigkeit |
|---|---|---|
| MiniMax-M2.7 | 204.800 Tokens gesamt | ungefähr 60 Output-Tokens/s |
| MiniMax-M2.7-highspeed | 204.800 Tokens gesamt | ungefähr 100 Output-Tokens/s |
Die API-Dokumentation weist ausdrücklich darauf hin, dass sich die maximale Tokenzahl auf Input und Output zusammen bezieht. Die Geschwindigkeitsangaben sind keine Messwerte dieses Magazins. API-Übersicht
Benchmarks richtig einordnen
MiniMax veröffentlicht für M2.7 unter anderem folgende Ergebnisse:
- SWE-Pro: 56,22 %
- VIBE-Pro: 55,6 %
- Terminal-Bench 2: 57,0 %
- SWE Multilingual: 76,5
- Multi SWE Bench: 52,7
- GDPval-AA: 1495 ELO
- MLE Bench Lite: 66,6 % Medaillenrate über 22 Wettbewerbe
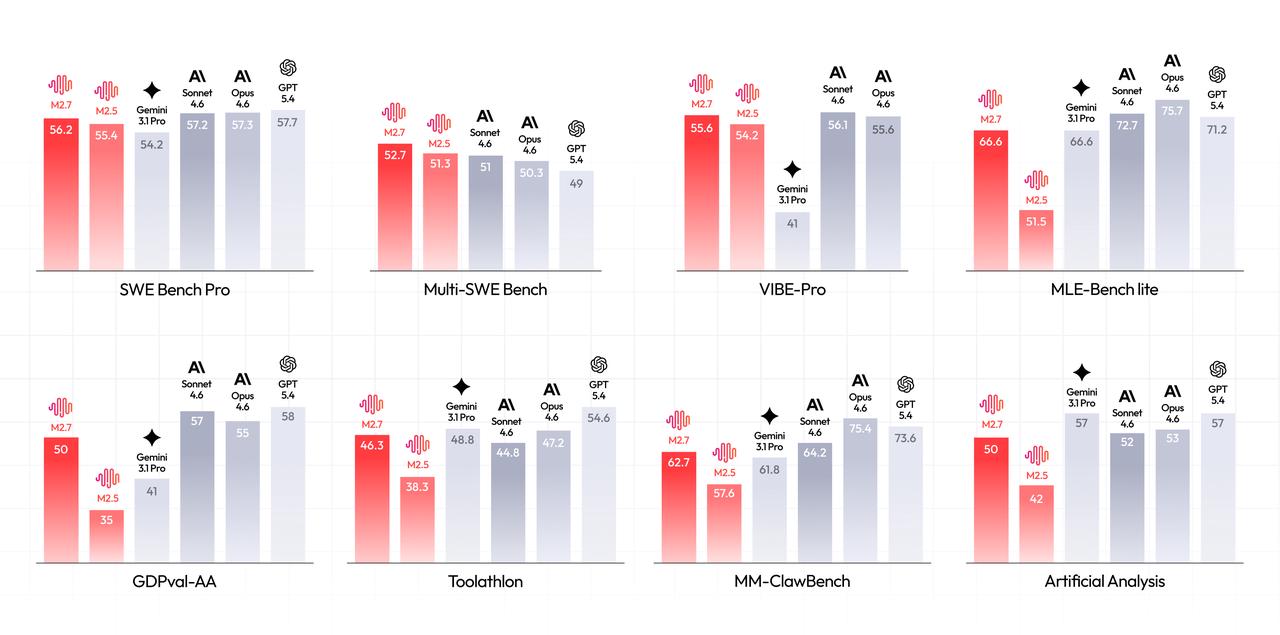
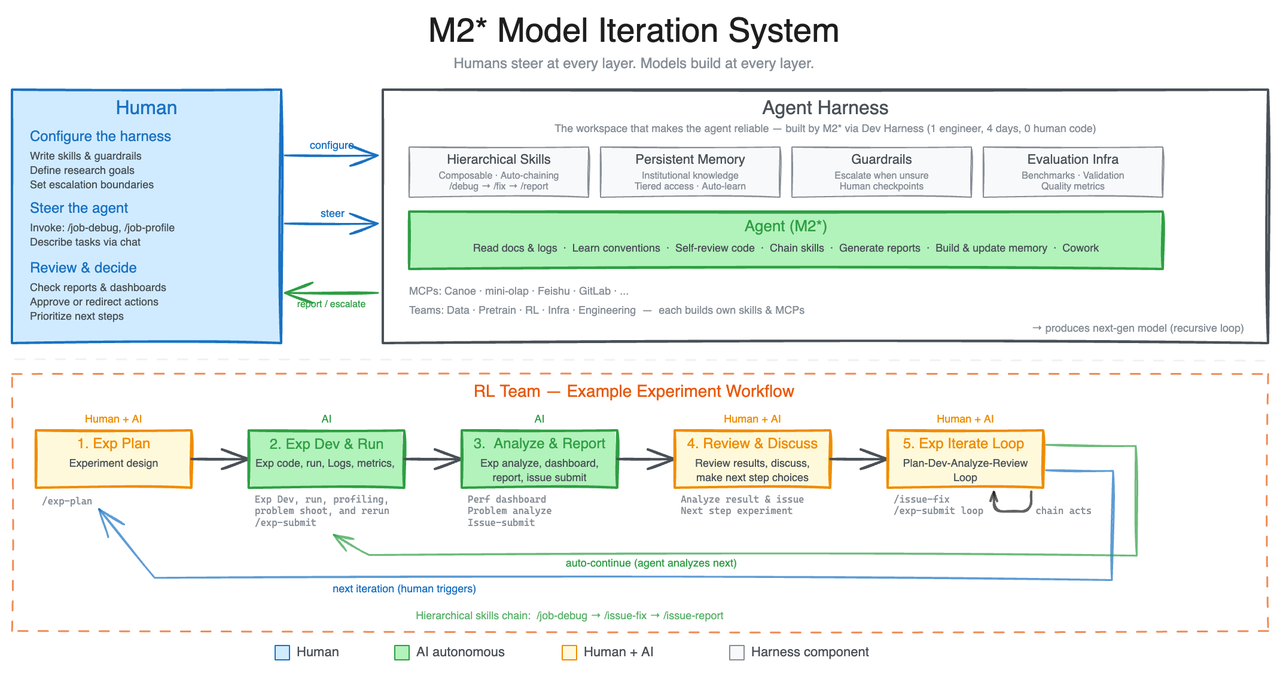
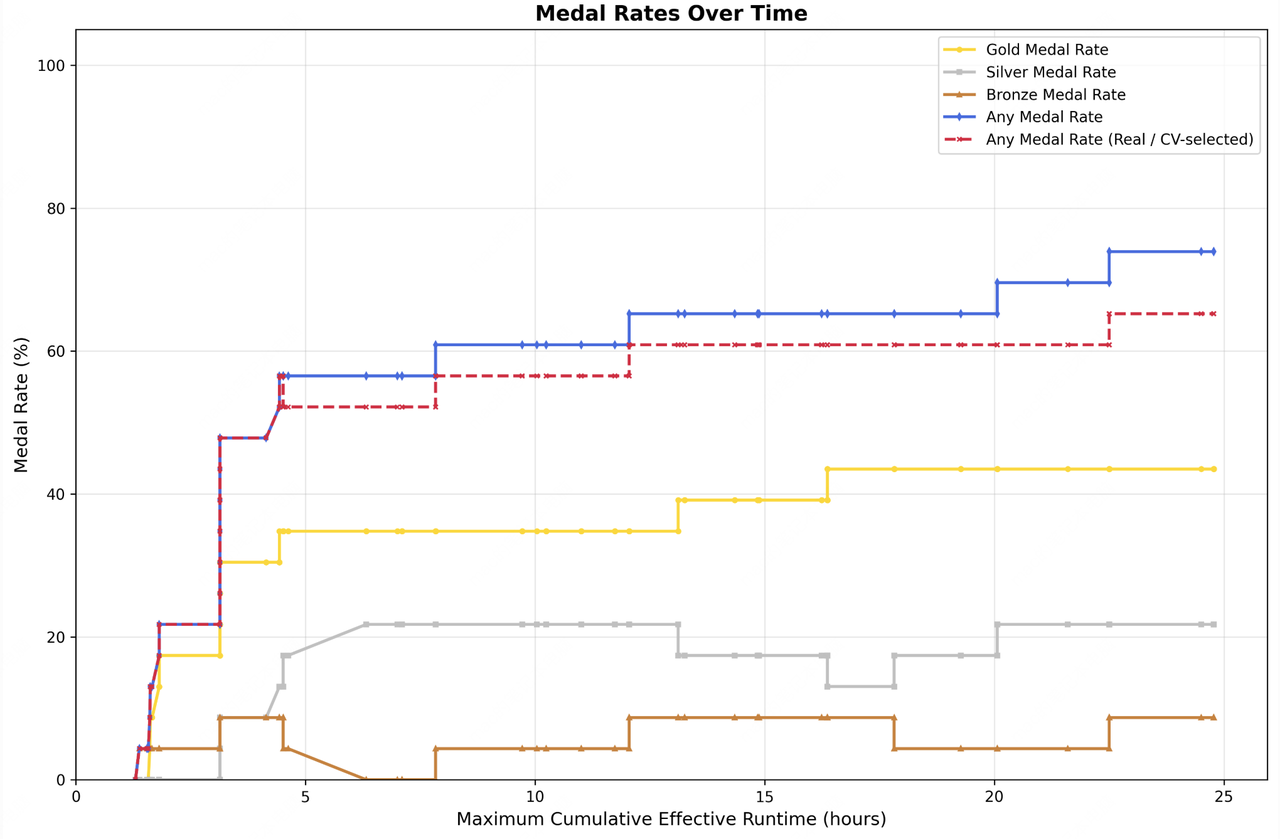
Das sind veröffentlichte Anbieterwerte. Sie zeigen, wie MiniMax das Modell positioniert; sie ersetzen keinen unabhängigen Test mit deinem Repository, deinem Agent-Harness oder deinem Mac. MiniMax-Ankündigung Hugging-Face-Modellkarte
MiniMax beschreibt außerdem interne Experimente zur Selbstoptimierung eines Programmier-Scaffolds und zur Arbeit mit Agent-Harnesses. Diese Aussagen sind als Berichte des Herstellers zu lesen, nicht als reproduzierbare Mac-Erfahrung. M2.7-Ankündigung
MiniMax M2.7 auf dem Mac verwenden
1. API-Zugriff
Die aktuelle MiniMax-Dokumentation nennt für OpenAI-kompatible Aufrufe https://api.minimax.io/v1/chat/completions. Das folgende Beispiel verwendet einen Pay-as-you-go-Key, der kostenpflichtige Tokens auslösen kann. Installiere python3 -m pip install requests und setze MINIMAX_API_KEY als geheime Umgebungsvariable. Das Skript prüft den Schlüssel vor dem Request und gibt nur finale Antwort und Tokenzähler aus, nicht die vollständige JSON-Antwort mit möglichem Reasoning-Inhalt:
import os
import requests

key = os.getenv("MINIMAX_API_KEY")
if not key:
    raise SystemExit("MINIMAX_API_KEY fehlt – keine API-Anfrage gesendet")

response = requests.post(
    "https://api.minimax.io/v1/chat/completions",
    headers={"Authorization": f"Bearer {key}"},
    json={
        "model": "MiniMax-M2.7",
        "messages": [{"role": "user", "content": "Nenne drei CSV-Parser-Tests."}],
        "max_tokens": 2048,
        "stream": False,
    },
    timeout=90,
)
response.raise_for_status()
data = response.json()
if not data.get("choices"):
    raise RuntimeError("API hat keine Antwortauswahl geliefert")
print(data["choices"][0]["message"].get("content", ""))
usage = data.get("usage") or {}
print("Token-Zaehler:", {
    "input": usage.get("prompt_tokens"),
    "output": usage.get("completion_tokens"),
})
Diese Ausgabe ist keine selbst durchgeführte Modellbewertung. Ein API-Smoke-Test bestätigt noch nicht, dass ein Agent einen Bug zuverlässig behebt. Die gemeldeten Tokenzähler beweisen auch keine berechneten Cache-Treffer; prüfe für echte Kosten die Abrechnung im Konto.
Die API-Übersicht nennt außerdem Zugriffe über HTTP, das Anthropic SDK und das OpenAI SDK. Ein normaler Pay-as-you-go-API-Key belastet dein Account-Guthaben. Ein M-Plan-Subscription-Key verbraucht berechtigte Abo-Nutzung und danach gegebenenfalls Credit-Pakete, aber nicht das Pay-as-you-go-Guthaben. Im Mac-Agenten den richtigen Schlüssel hinterlegen. API-Übersicht
2. Ollama Cloud
Ollama listet M2.7 als minimax-m2.7:cloud:
ollama run minimax-m2.7:cloudDas Suffix :cloud ist hier die entscheidende Information. Ollama ist der lokale Aufruf beziehungsweise Client; das Modell wird nicht als lokale Apple-Silicon-Inferenz auf dem Mac ausgeführt. Die Ollama-Seite beschreibt die Cloud-Nutzung ausdrücklich als kommerziell lizenzierten Cloud-Zugriff. Ollama-Cloud-Eintrag
3. Selbst gehosteter Server
Die Hugging-Face-Modellkarte stellt Gewichte bereit und verweist für die Bereitstellung auf:
- SGLang
- vLLM
- Transformers
- ModelScope und einen NVIDIA-NIM-Endpunkt als weitere Wege
In den geprüften Quellen findet sich dagegen kein offizieller, getesteter MLX-, llama.cpp- oder Apple-Silicon-Installationspfad für M2.7. Deshalb lautet die belastbare Mac-Aussage: Cloud-Nutzung ist dokumentiert; ein lokaler Mac-Lauf bleibt ein separates, hardware- und runtimeabhängiges Experiment. Eine konkrete RAM-Untergrenze oder Mac-Tokenrate wird hier nicht erfunden. Hugging-Face-Modellkarte
API-Preise und M Plan: drei verschiedene Abrechnungen
Am 12. Oktober 2026 mit MiniMax-Preisliste, M-Plan-FAQ und der weiter erreichbaren Token-Plan-Seite abgeglichen: Es gibt hier drei unterschiedliche Wege: Pay-as-you-go mit einem regulären API-Key, M Plan mit eigenem Subscription Key und den separat beworbenen Token Plan (für Bestandskunden weiterhin garantiert; Neuabschluss je Konto prüfen). Keines davon ist der Preis für die lokale Installation des Modells. MiniMax API-Preise · M-Plan-Dokumentation.
API-Abrechnung: M2.7, Highspeed und M3
Die folgenden API-Listenpreise gelten in USD je eine Million Tokens. Cache-Read und Cache-Write sind unterschiedliche Rechnungsposten:
| API-Modell / Klasse | Input | Output | Cache-Read | Cache-Write |
|---|---|---|---|---|
| MiniMax-M2.7 | 0,30 USD | 1,20 USD | 0,06 USD | 0,375 USD |
| MiniMax-M2.7-highspeed | 0,60 USD | 2,40 USD | 0,06 USD | 0,375 USD |
| MiniMax-M3, Standard, ≤512K Input-Tokens | 0,30 USD | 1,20 USD | 0,06 USD | separate API-Details |
| MiniMax-M3, Standard, >512K Input-Tokens | 0,60 USD | 2,40 USD | 0,12 USD | separate API-Details |
Nachrechenbares API-Beispiel (Kalkulation, keine gemessene Session): 2 Mio. ungecachte Input-Tokens, 8 Mio. berechtigte Cache-Reads, 1 Mio. Output-Tokens und 0,5 Mio. abgerechnete Cache-Writes kosten mit den M2.7-Tarifen 2 × 0,30 + 8 × 0,06 + 1 × 1,20 + 0,5 × 0,375 = 2,4675 USD. Ohne Cache-Treffer ergeben 10 Mio. Input plus 1 Mio. Output 10 × 0,30 + 1 × 1,20 = 4,20 USD vor weiteren Extras. Die Rechnung setzt echte Cache-Treffer und -Schreibvorgänge voraus. Ein M-Plan-Abo wird nicht einfach mit diesen Tokenpreisen berechnet.


Korrektur gegenüber August: M2.7 kostet beim regulären Input/Output-API-Tarif nicht weniger als M3 bei bis zu 512K Input-Tokens. Größere M3-Inputs werden teurer. Auch die höhere Highspeed-Ausgabegeschwindigkeit ist eine Herstellerangabe, keine von AI on Mac gemessene Mac-Geschwindigkeit. Die Kontingentangaben von 500 RPM / 20 Mio. TPM für M2.7 gehören zur API – nicht zum Abo. MiniMax Preisliste · Rate-Limits.
M Plan ist kein vergünstigter M2.7-API-Key
MiniMax bewirbt im M-Plan-Überblick Go / Explore / Build. Daneben existiert eine Token-Plan-Seite mit Plus / Max / Ultra. Für Token-Plan-Bestandskunden garantiert die FAQ den bisherigen Aboumfang bei aktiver Verlängerung; ob die angezeigten Kaufoptionen auch für neue Kunden gelten, muss im Checkout geprüft werden. Reguläre internationale M-Plan-Monatslistenpreise:
| M-Plan-Stufe | Regelpreis pro Monat in USD | Relativer gemeinsamer Verbrauchsrahmen |
|---|---|---|
| Go | 22 USD | 1× Basis |
| Explore | 55 USD | 3× Go |
| Build | 132 USD | 7,5× Go |


Modellabdeckung vor dem Kauf prüfen: Die neue M-Plan-Modellmatrix nennt für alle Stufen ausdrücklich M3.1 Flash und für Explore/Build zusätzlich H3 Video (nicht Go). M2.7 ist dort nicht ausdrücklich als enthaltenes Textmodell gelistet. Deshalb darf ein neuer Subscription Key nicht pauschal als kostenlose M2.7-API verkauft werden. Bestandskunden mit Token Plan können eine andere M2.7-Abdeckung besitzen.
Aktionspreise sind keine Abo-Regelpreise. Für berechtigte Kunden wurde zuvor eine befristete Erstmonatsaktion bis 14. Oktober 2026 beworben; die aktuelle FAQ garantiert weder Berechtigung noch einen Rabatt oder den Verlängerungspreis. Der Vergleich verwendet nur die regulären Preise. Verbindlich ist der individuelle Checkout.
Token Plan und M Plan: gleicher Anbieter, andere Modellabdeckung
| Produktseite (12.10.2026) | Monatsliste in USD | Dokumentiertes Textmodell |
|---|---|---|
| M Plan Go / Explore / Build | 22 / 55 / 132 USD | M3.1 Flash; M2.7 nicht ausdrücklich in dieser Modellmatrix |
| Token Plan Plus / Max / Ultra | 20 / 50 / 120 USD | MiniMax nennt M3 und M2.7 in der Token-Plan-Beschreibung |
| Pay-as-you-go M2.7 | keine Monatsgebühr als Tokenpreis | M2.7 per Standard-API-Key, 0,30 / 1,20 USD je 1M uncachete Input-/Output-Tokens |
Die Token-Plan-Seite zeigt weiter Preise und Kaufoptionen. Dies ist kein Beleg für die Verfügbarkeit im Checkout jedes Neuaccounts. Vor einem Aboabschluss den tatsächlich freigeschalteten Modellnamen, Subscription-Key-Typ und Quoten prüfen. Für die aktuellere Vorschau sowie Hermes-Integration siehe den MiniMax-M3.1-Ratgeber.
Nutzungsfenster, gemeinsames Kontingent und Credits
Die aktuelle M-Plan-FAQ von MiniMax erläutert die Begrenzung genauer. Es handelt sich nicht um ein unbegrenztes Abo. Die Multiplikatoren 1×/3×/7,5× sind keine garantierte Nachrichtenzahl:
- Text, Bilder, Audio und andere Nicht-Video-Aufgaben: ein geteiltes Kontingent mit 5-Stunden- und 7-Tage-Fenster. Beide beginnen mit der ersten Nutzung und setzen unabhängig am jeweiligen Fensterende zurück. Ein 5-Stunden-Reset füllt das Wochenkontingent nicht auf.
- Video (Explore/Build): nur das Wochenfenster, kein 5-Stunden-Fenster. Videogenerierung verbraucht gewöhnlich deutlich mehr Kontingent als Text.
- Ein gemeinsamer Verbrauch über mehrere Tools: MiniMax Code, Claude Code, Codex, Hermes Agent und andere unterstützte Anwendungen teilen dasselbe Abo-Budget. Viele parallel laufende Agenten schöpfen es schneller aus.
- Kein Übertrag: ungenutztes Abo-Kontingent verfällt zum Fenster- beziehungsweise Rechnungswechsel. Credit-Pakete können berechtigte Mehrnutzung automatisch bezahlen und gelten ein Jahr ab Kauf.
- Ein Subscription Key belastet nicht unbemerkt dein reguläres API-Guthaben. Dafür ist bewusst ein normaler Pay-as-you-go-API-Key nötig. Die Schlüsselwahl entscheidet über die Abrechnung.
Verbrauch vor und nach einer Agentensitzung kontrollieren:
mmx quota
# Alternativ mit dem M-Plan-Subscription-Key:
curl --fail-with-body -sS 'https://www.minimax.io/v1/token_plan/remains' \
  -H "Authorization: Bearer $MINIMAX_SUBSCRIPTION_KEY"
Die Zahlen hängen vom tatsächlichen Konto ab; hierfür wurde kein fremdes Abo abgefragt. MiniMax empfiehlt für Produktivsysteme Pay-as-you-go, weil der M Plan primär interaktiv genutzt werden soll und dynamischen Drosselungen unterliegt. MiniMax M-Plan-FAQ.
Deutschland: 22/55/132 USD sind keine deutschen Euro-Endpreise einschließlich Steuern. Auch deutscher Rechnungssitz oder deutschsprachige Prompts garantieren keine EU-only-Inferenz. Für Kundendaten die Verarbeitungsregion, Aufbewahrung, Vertragsbedingungen und Unterauftragsverarbeiter prüfen.
M2.7 oder M3?
MiniMax führt M3 als reguläres Cloud-API-Modell mit bis zu 1.000.000 Tokens Kontext. M3.1 Flash ist inzwischen zusätzlich als neueres Modell im M Plan dokumentiert; API-Listenpreise, Modell-IDs und Abo-Abdeckung sind getrennt zu prüfen. M Plan. M2.7 bleibt im API-Katalog verfügbar, ist bei Standardpreisen für Input und Output aber nicht günstiger als M3 bei bis zu 512K Input-Tokens; M3 kostet in diesem Bereich ebenfalls 0,30/1,20 USD pro Million Tokens. Größere M3-Inputs haben eigene höhere Tarife. API-Übersicht
Für einen neuen Workflow ist deshalb die Aufgabe entscheidend:
- M2.7: sinnvoll, wenn du die dokumentierten Coding-/Agent-Funktionen benötigst und ein vorhandenes Setup weiterbetreibst. M3 hat unter 512K Input keinen niedrigeren API-Listenpreis-Nachteil.
- M2.7-highspeed: sinnvoll, wenn die höhere Anbieterangabe zur Ausgabegeschwindigkeit den Aufpreis rechtfertigt.
- M3: prüfen, wenn sehr lange Kontexte, Multimodalität oder die aktuelle M-Series-Spitze wichtiger sind als der M2.7-Preis.
OpenRoom und Agent Teams
MiniMax hat mit OpenRoom eine Web-GUI-Demo veröffentlicht, die Agenteninteraktion in einer interaktiven Umgebung zeigt. Das ist eine Produkt- beziehungsweise Forschungsdemo und kein Beleg für lokale Inferenz auf Apple Silicon. Die im Artikel eingebundene Grafik und das Video illustrieren den von MiniMax beschriebenen Agent-Teams-Ansatz. M2.7-Ankündigung
*Visualisierung von Agent Teams in M2.7; die Grafik ist eine Herstellerdarstellung und kein eigener Mac-Test.*Datenschutz und praktische Entscheidung
Bei API- und Ollama-Cloud-Nutzung verlassen Code, Prompts und gegebenenfalls Dateien den Mac. Vor einem produktiven Einsatz solltest du daher mindestens prüfen:
- Welche Daten dein Agent an die API oder an serverseitige Tools übergibt.
- Ob dein API-Key nur über eine Umgebungsvariable oder einen Secret-Manager eingebunden wird.
- Ob die reale Abrechnung über Pay-as-you-go, Subscription Key oder Credits erfolgt.
- Ob ein lokales Modell mit dokumentiertem Apple-Silicon-Pfad für private Daten geeigneter ist.
Für M2.7 ist die belastbare Kurzentscheidung: Cloud zuerst, lokaler Mac nur als ausdrücklich zu validierendes Spezialprojekt.
Fazit: Nutzbar vom Mac aus — als Cloud-Modell
MiniMax M2.7 ist auf dem Mac gut nutzbar, wenn „auf dem Mac“ den lokalen Client, Editor oder API-Workflow meint. Das Modell selbst läuft in diesem Standardfall in der MiniMax- oder Ollama-Cloud. Die offizielle Modellkarte stellt zwar Gewichte und Serverpfade bereit, dokumentiert aber keinen getesteten Apple-Silicon-Weg. Wer Preise vergleicht, muss Pay-as-you-go, den neuen M Plan und bestehende alte Token-Plan-Abos trennen. API-Tokenpreise, Aboschlüssel, Zeitfenster und Provider-Bedingungen sind unterschiedliche Ebenen.
Quellen und Prüfstand
API-Preise, Modellabdeckung und beide Abo-Produktseiten am 12. Oktober 2026 überprüft. Keine kostenpflichtigen API-Aufrufe oder eigenen Mac-Inferenztests für dieses Update ausgeführt. Preise, Limits, Modellkataloge und Produktbedingungen können sich ändern. Vor einer kostenpflichtigen Nutzung sollten die verlinkten Originalseiten und das eigene MiniMax-Konto erneut geprüft werden.
Häufig gestellte Fragen
Ist MiniMax M2.7 ein lokales Mac-Modell?
Nicht im Sinne eines offiziell unterstützten Apple-Silicon-Workflows. MiniMax stellt Gewichte und Serverpfade für SGLang, vLLM und Transformers bereit, dokumentiert in den geprüften Quellen aber keinen getesteten MLX- oder Mac-Pfad. Die Ollama-Variante minimax-m2.7:cloud ist ausdrücklich ein Cloud-Modell.
Wie groß ist das Kontextfenster von MiniMax M2.7?
Die MiniMax-API-Dokumentation nennt für MiniMax-M2.7 und MiniMax-M2.7-highspeed 204.800 Tokens. Das ist die maximale Summe aus Input und Output, nicht automatisch 204.800 Output-Tokens.
Was ist der Unterschied zwischen MiniMax-M2.7 und MiniMax-M2.7-highspeed?
MiniMax beschreibt beide Varianten als ergebnisgleich. M2.7 wird mit ungefähr 60 Output-Tokens pro Sekunde, M2.7-highspeed mit ungefähr 100 Output-Tokens pro Sekunde angegeben. Die Highspeed-Variante hat außerdem eigene API-Preise.
Was kostet MiniMax M2.7?
M2.7 kostet in der öffentlichen API je Million Tokens 0,30 USD Input, 0,06 USD Cache-Reads, 0,375 USD Cache-Writes und 1,20 USD Output. Der separate M Plan kostet Go 22, Explore 55 und Build 132 USD monatlich. Er bewirbt M3.1 Flash; M2.7-Abdeckung vor einem Aboabschluss überprüfen.