Geprüft am 12. Oktober 2026. GLM-5.2 ist inzwischen ein Vorgängermodell von GLM-5.3. Für bestehende Agenten-Setups ist es weiterhin verfügbar: Z.ai dokumentiert 1 Mio. Kontext-Tokens und berechnet 1,40 USD Input sowie 4,40 USD Output pro Million Tokens. OpenRouter kann günstiger oder teurer sein, weil dort wechselnde Preise nach Provider und Rabatt gelten. Z.ai-Modellseite · Z.ai-Preisliste.
Drei Zugangswege – unterschiedliche Anforderungen
| Route | Modellname | Entscheidend |
|---|---|---|
| Z.ai direkt | glm-5.2 | veröffentlichte USD-Listenpreise |
| OpenRouter | z-ai/glm-5.2 | Provider-Routing, wechselnde Tarife und Limits |
| Eigener Server | zai-org/GLM-5.2 | enorme Gewichte, Runtime und Infrastruktur |
Für einen gewöhnlichen Mac mit 16 bis 64 GB Unified Memory ist die API in der Regel der einfachere Zugang. Die Verfügbarkeit von offenen Gewichten beweist keine praktische Inferenz-Geschwindigkeit auf Apple Silicon.
Was GLM-5.2 kostet
Z.ai nennt am Prüfdatum für die direkte API folgende USD-Listenpreise pro Million Tokens:
| Tokenart | Preis bei Z.ai |
|---|---|
| Normaler Input | 1,40 USD |
| Cached Input | 0,26 USD |
| Output | 4,40 USD |
| Cache-Speicherung | laut Anbieter zeitweise kostenlos |
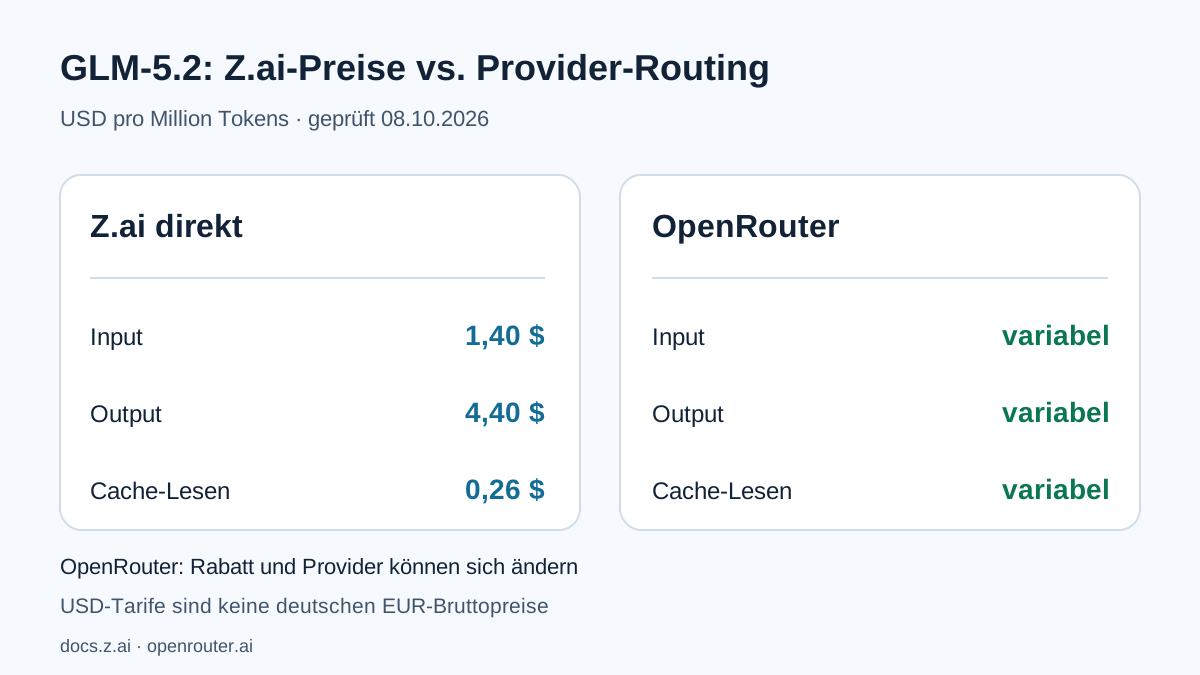
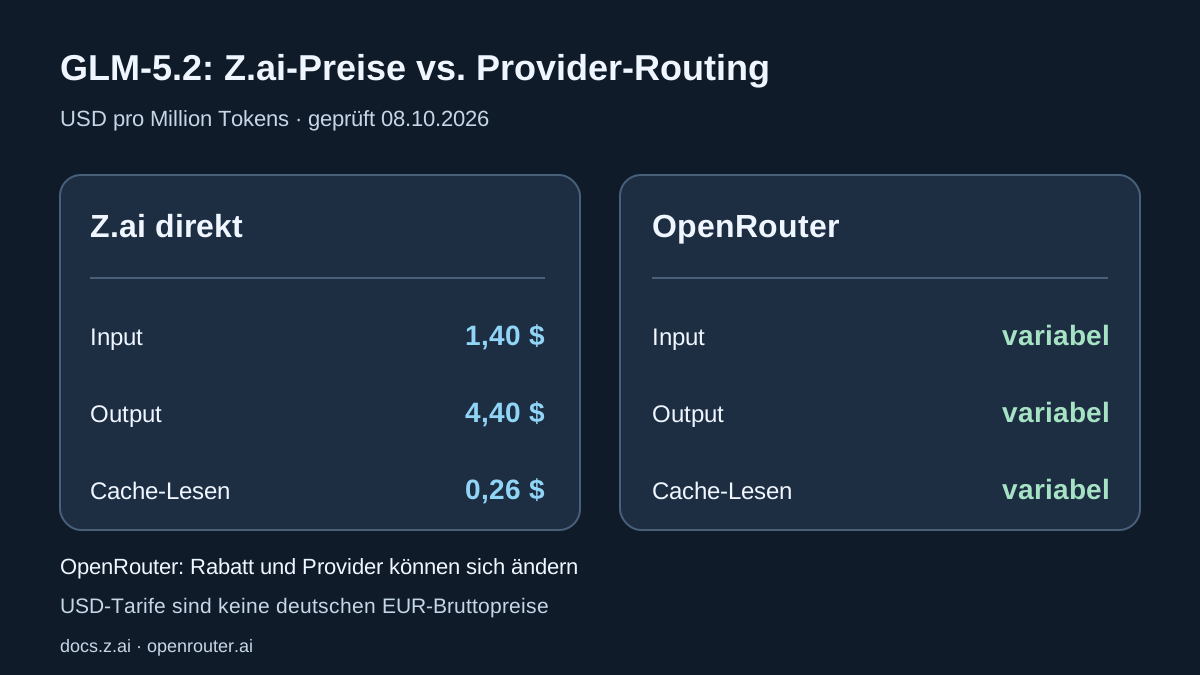
Dies sind Z.ai-Direktpreise, keine universellen OpenRouter-Tarife. Auf OpenRouter erscheinen mehrere Provider und zeitlich veränderliche Aktionen. Ein Screenshot mit einem günstigen Rabatt beschreibt nicht den dauerhaften Preis für jede Route. Vor einer Migration prüfen: effektiver Input-, Cache- und Output-Tarif, gewünschter Provider, Quantisierung sowie Kontext- und Ausgabegrenzen.
Die Z.ai-Preisliste ist in US-Dollar. Daraus lässt sich kein pauschaler deutscher Euro-Bruttopreis ableiten; die tatsächliche Rechnung hängt vom Vertrag und Steuerstatus ab. Coding-Abos mit Nutzungskontingenten sind ein anderes Produkt als verbrauchsabhängige API-Tokens.
Rechenbeispiel
Ein einmaliger API-Auftrag mit 100.000 nicht gecachten Input-Tokens und 10.000 Output-Tokens kostet bei Z.ai rein nach Tokenliste 0,184 USD: 0,14 USD Input plus 0,044 USD Output. Ein Agent mit wiederholten Tool-Aufrufen, langen Logs und neu übertragenem Kontext kann weit darüberliegen. Cache-Lesezugriffe sind günstiger als normale Eingabe, aber Cache-Hits sind nicht garantiert.
Direkte Z.ai-Tarife: 5.2 kostet genauso viel wie 5.3
Die Z.ai-Preisliste nennt identische API-Tarife für GLM-5.2 und seinen Nachfolger GLM-5.3. GLM-5.3 Flash ist deutlich billiger, aber nicht dasselbe Modell. Ein Preisvergleich ist deshalb keine Qualitätsmessung.
| Direkt bei Z.ai | Input/1M | Cache-Input/1M | Output/1M | Beispiel¹ |
|---|---|---|---|---|
| GLM-5.2 | $1,40 | $0,26 | $4,40 | $1,84 |
| GLM-5.3 | $1,40 | $0,26 | $4,40 | $1,84 |
| GLM-5.3 Flash | $0,15 | $0,03 | $0,50 | $0,20 |
¹ Nur eine Kostenrechnung: 1 Mio. ungecachte Input- und 100.000 Output-Tokens, ohne Tools, Cache, Retries, Rabatte und Steuern. GLM-5.2/5.3: 1 × 1,40 + 0,1 × 4,40 = $1,84. Flash: 1 × 0,15 + 0,1 × 0,50 = $0,20. Keine gemessenen Benchmarks und keine OpenRouter-Preise.


Für neue Agentenprojekte: GLM-5.3 zuerst auf denselben eigenen Aufgaben prüfen; bei gleichem Listenpreis sollte GLM-5.2 nur bleiben, wenn reproduzierbare Tool-, Qualitäts- oder Kompatibilitätstests dafür sprechen. GLM-5.3 Flash gesondert als günstigere Klasse evaluieren. Ein beliebiger OpenRouter-Rabatt ändert diese direkten Z.ai-Preise nicht.
Mehrere Agentenaufrufe: Was Cache tatsächlich spart
Die Z.ai-Preisliste nennt für GLM-5.2 direkt je Million Tokens 1,40 USD regulären Input, 0,26 USD Cache-Lesezugriffe und 4,40 USD Output. Ein erneut gesendeter Repository-Ausschnitt erzeugt aber nicht garantiert einen Cache-Treffer. Dafür zählen die tatsächlich abgerechneten Cache-Tokens.
Beispiel für zehn Aufrufe: Insgesamt 1 Mio. ungecachte Input- und 100.000 Output-Tokens kosten 1,840 USD. Bei derselben Tokenmenge mit 900.000 tatsächlich als Cache-Treffer abgerechneten Input-Tokens wären es rechnerisch 0,814 USD, also 1,026 USD weniger. Das ist eine Modellrechnung, keine gemessene Ersparnis. Auf OpenRouter gelten die Preise und Grenzen des gewählten Providers.
python3 - <<'PY'
def usd(uncached, cached, output):
    return (uncached * 1.40 + cached * 0.26 + output * 4.40) / 1_000_000
a = usd(1_000_000, 0, 100_000)
b = usd(100_000, 900_000, 100_000)
print(f"Ten requests, no cache: USD {a:.3f}")
print(f"Same total tokens, 90% cached input: USD {b:.3f}")
print(f"Difference (illustrative only): USD {a-b:.3f}")
PY
Für den Vergleich mit GLM-5.3 erfasse aus realen API-Abrechnungen pro Aufgabe Modell-ID, uncached und cached Input, Output, Wiederholungsversuche und Kosten. Miss die Quote bestandener Tests und berechne USD pro erfolgreicher Aufgabe; ein geringerer Tokenpreis allein belegt keinen wirtschaftlicheren Agenten. Der Mac fungiert hier als API-Client, nicht als lokaler Inferenzserver.
1M Kontext: Kapazität ist nicht Qualität
Z.ai nennt ein Kontextfenster von 1 Mio. Tokens und bis zu 128K Output-Tokens. Die tatsächlichen Routen eines Gateways können abweichen. Der große Kontext erlaubt umfangreiche Dokumente oder Repositories in einem Prompt, er bewirkt aber nicht, dass jede Datei gleich zuverlässig beachtet wird. Lange Prompts erhöhen meist Latenz und Kosten.
Für einen praktischen Test die konkrete Änderung samt relevanter Dateien, vorhandenen Tests und Fehlerausgaben bereitstellen. Ein vollständiger Repository-Dump sollte nur erfolgen, wenn er wirklich nötig ist. Zum Qualitätsvergleich müssen dieselben Aufgaben mit demselben Tool-Zugriff und ähnlicher Prompt-Länge wiederholt werden.
Offene Gewichte – aber kein gewöhnliches Mac-Modell
Die offizielle Hugging-Face-Karte veröffentlicht die GLM-5.2-Gewichte unter MIT-Lizenz. Es handelt sich damit um ein Open-Weight-Modell, das prinzipiell auf eigener Infrastruktur ausgeführt werden kann. Die Herstelleranleitungen nennen unter anderem SGLang, vLLM und Transformers und konzentrieren sich auf große Server-Deployments.
Die offen verfügbare Modellkarte ist kein Testbericht für einen MacBook Air oder Mac mini. Quantisierte Community-Fassungen können andere Anforderungen und Qualität haben. Zur Hardwareentscheidung muss man die tatsächlichen Dateien, die Runtime-Architektur, den KV-Cache und den Speicherbedarf unter Last prüfen. Unser Unified-Memory-Guide erklärt das für Apple Silicon. Es wurden für diesen Artikel keine eigenen GLM-5.2-Mac-Benchmarks durchgeführt.
Benchmarks mit benannten Testbedingungen
Z.ai berichtet auf der Model Card unter anderem folgende Werte:
| Benchmark | GLM-5.2 | Einordnung |
|---|---|---|
| Terminal-Bench 2.1 | 81,0 | mit Terminus-2-Harness |
| SWE-bench Pro | 62,1 | Hersteller-/Model-Card-Wert |
| Humanity’s Last Exam, ohne Tools | 40,5 | textbasierte Fragen, keine Tool-Nutzung |
Diese Werte stammen vom Modellanbieter, nicht aus unseren Tests. „Terminal-Bench 2.1 mit Terminus-2“ ist auch nicht mit einer separaten Best-Harness-Auswertung identisch. Eine gemeinsame unbeschriftete Balkengrafik würde eine Vergleichbarkeit vortäuschen, die verschiedene Benchmarks nicht besitzen. Für den Modelleinsatz sind reproduzierbare Tests mit dem eigenen Projekt aussagekräftiger.
API-Aufruf von macOS
Das Beispiel verwendet Z.ai direkt, nicht OpenRouter. Der Schlüssel gehört in die geheime Umgebungsvariable ZAI_API_KEY:
read -rs ZAI_API_KEY
export ZAI_API_KEY
: "${ZAI_API_KEY:?ZAI_API_KEY must be set before billable requests}"
curl -fsS https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role":"user","content":"Nenne drei Tests für den folgenden Patch."}],
    "thinking": {"type":"enabled"},
    "reasoning_effort": "max",
    "max_tokens": 1024
  }'
Der Pfad und die Parameter entsprechen der Herstellerdokumentation. Bei OpenRouter braucht es einen anderen Schlüssel, eine andere Basis-URL und die dortige Modell-ID. Eine erfolgreiche API-Antwort bedeutet nicht, dass die Berechnung lokal erfolgte.
Sicherer Modellvergleich auf macOS: 5.2 gegen 5.3
Dieses Python-Beispiel sendet zwei kostenpflichtige Anfragen an den direkten Z.ai-Endpunkt, nicht an OpenRouter. Es zeigt Anfragezeit und API-Tokenzähler; Antworten und Schlüssel werden nicht ausgegeben. python3 -m pip install -U openai installieren, ZAI_API_KEY exportieren und als glm_compare.py speichern:
import os
import time
from openai import OpenAI

key = os.getenv("ZAI_API_KEY")
if not key:
    raise SystemExit("ZAI_API_KEY fehlt; kein Request gesendet")
client = OpenAI(api_key=key, base_url="https://api.z.ai/api/paas/v4/")
prompt = "Nenne drei Tests für eine fehlerhafte CSV-Parserfunktion."
for model in ("glm-5.2", "glm-5.3"):
    start = time.perf_counter()
    try:
        response = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=1024,
            extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "max"},
        )
    except Exception as error:
        print(model, type(error).__name__)
        continue
    usage = response.usage
    print({"model": model, "seconds": round(time.perf_counter()-start, 2),
           "prompt_tokens": getattr(usage, "prompt_tokens", None),
           "output_tokens": getattr(usage, "completion_tokens", None)})
Migrationsfalle: GLM-5.3 akzeptiert laut offizieller Modellseite kein deaktiviertes Reasoning. Ältere Agenten-Konfigurationen mit thinking.type: "disabled" müssen vor der Umstellung auf enabled angepasst werden; verfügbare reasoning_effort-Stufen sind low, high, max. Das obige Beispiel setzt bei beiden Modellen bewusst enabled und max, um einen nicht unterstützten Parameter und unterschiedliche Default-Werte zu vermeiden. Thinking kann Output-Tokens und Kosten beeinflussen.
Nicht als Qualitätsbenchmark ausgeben: Ein Aufruf je Modell reicht nicht, um Agentenqualität zu beurteilen. prompt_tokens ist auch kein Beleg für tatsächlich verrechnete Cache-Hits. Für eine sinnvolle Entscheidung: dieselben freigegebenen Aufgaben mehrfach mit gleichen Tools ausführen, Test-Erfolgsquote und Fehlversuche dokumentieren und echte Rechnungskosten pro bestandener Aufgabe vergleichen. Z.ai-Modellreferenz 5.3.
Datenschutz und Anbieterauswahl
Cloud-Agenten übermitteln ausgewählte Dateien und Tool-Ergebnisse an externe Infrastruktur. Eine vermeintliche EU-Region oder ein europäischer Endpunkt ist kein Nachweis vollständig europäischer Datenverarbeitung. Prüfe die konkrete Anbieter- und Subprozessorenkette, Nutzungsbedingungen, Speicherfristen und zulässigen Tool-Zugriffe. Eigene Open-Weight-Deployments bieten mehr technische Kontrolle, verlangen aber passende Infrastruktur.
Lohnt sich GLM-5.2 noch?
Wer ein bestehendes Setup besitzt, sollte die Erfolgsquote mit GLM-5.3 anhand derselben Aufgaben vergleichen. Für neue Cloud-Projekte zählen Gesamtkosten und bestätigte Qualität mehr als ein günstiger Providerpreis. Wer auf einem normalen Mac offline arbeiten muss, beginnt besser mit kleineren offenen Modellen.
Quellen, geprüft am 12. Oktober 2026: Z.ai-Dokumentation, Z.ai-Preise, OpenRouter, Hugging Face.
Häufig gestellte Fragen
Wie teuer ist GLM-5.2 bei Z.ai?
Z.ai nennt 1,40 USD für Input, 0,26 USD für Cached Input und 4,40 USD für Output je Million Tokens. OpenRouter hat eigene Providerpreise.
Läuft GLM-5.2 lokal auf einem Mac?
Die Gewichte sind unter MIT offen, aber das Modell ist sehr groß. Der Hersteller dokumentiert hauptsächlich Server-Frameworks, keinen unabhängig getesteten typischen Apple-Silicon-Aufbau.
Unterstützt GLM-5.2 eine Million Kontext-Tokens?
Z.ai nennt 1 Mio. Kontext-Tokens und maximal 128K Output-Tokens. OpenRouter-Provider können abweichende Bedingungen und Limits haben.
Welche Modell-ID gilt?
Z.ai verwendet glm-5.2, OpenRouter z-ai/glm-5.2 und Hugging Face zai-org/GLM-5.2.